排序

6. 写入文件
1️⃣w模式 概述:w模式是写入模式,写入前会先截断文件(清空文件)。 代码: with open('b.txt', 'wt', encoding='utf-8') as file: file.write('你好') 2️⃣x模式 概述:x模式是排它性创建...
 10天前
3. 数据类型转换
方法/操作语法示例描述查看数据类型df.dtypes显示每列的数据类型强制类型转换df['col'].astype('int')将列转换为指定类型(如int, float, str, datetime)转换为日期时间pd.to_datetime(df['col...
10天前7. 集合
7.1. 概述 集合是一种:无序、元素唯一的容器类型。 备注:无序是指从集合中取出元素的顺序,与定义集合时存入的顺序不一定一致。 集合分为两种,分别是: 可变集合(set):内部的元素无序(不...
11天前2.2.3.6 高级构造方法
(1) np.loadtxt data = np.loadtxt('data.txt') # 读取文本文件 (2) np.genfromtxt data = np.genfromtxt('data.csv', delimiter=',') # 支持复杂格式 2.2.3.7 创建方法推荐场景 场景推荐方法优...
10天前8.3. 字典的增删改查
1️⃣新增 新增语法:字典[key] = 值 # 新增 d1 = {'张三': 72, '李四': 60, '王五': 85} d1['赵六'] = 100 print(d1) 2️⃣删除 # 删除 d1 = {'张三': 72, '李四': 60, '王五': 85} # 删除...
11天前8. 列表推导式
概念:用一条简洁语句,从可迭代对象中,生成新列表的语法结构。 语法格式:[ 表达式 for 变量 in 可迭代对象 ] # 需求:让nums列表中所有的元素,都变为原来的2倍 # 方式一:用map函数 nums = ...
11天前6. 结果分析与解读
在这一阶段,我们对模型的训练结果进行详细分析,并从中提炼出对业务具有指导意义的洞察。通过分析模型的性能和数据特征,我们能够提供有关客户流失的重要见解,并为银行的客户管理策略提供指导...
9天前3. 特征工程
3.1 选择合适的特征 去除无关特征,数据集中包含以下列: CustomerID(客户ID):是唯一标识符,对聚类没有意义,应当删除。 Gender(性别):可能会影响消费行为,但我们主要关注消费习惯,因...
9天前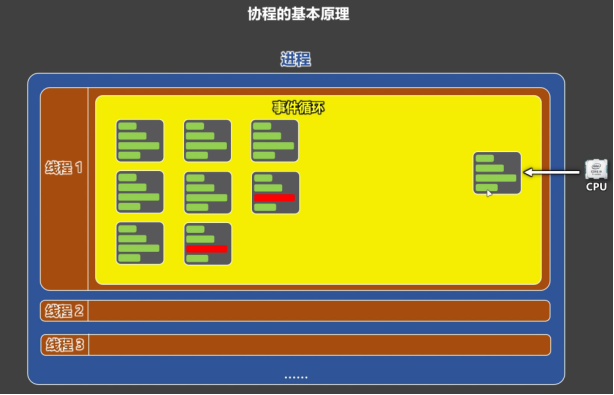
第 14 章 协程
1. 什么是协程 概念:协程(Coroutine),是一种线程内部的任务调度机制,它通过事件循环,在用户态中实现任务的挂起与恢复执行,从而在遇到 IO 操作时,不让 CPU 等待,而是继续执行其它需要 C...
10天前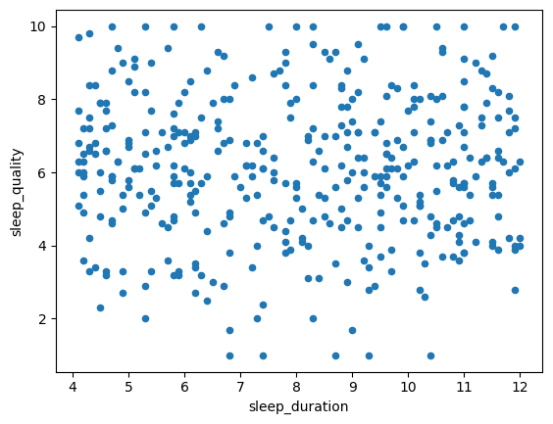
4.4.2 双变量可视化
散点图 散点图通过在二维坐标系中绘制数据点来展示两组数值数据之间的关系。能够揭示两个变量之间的相关性和趋势。 绘制睡眠时间与睡眠质量的散点图。 df.plot.scatter(x='sleep_duration', y='...
10天前
