



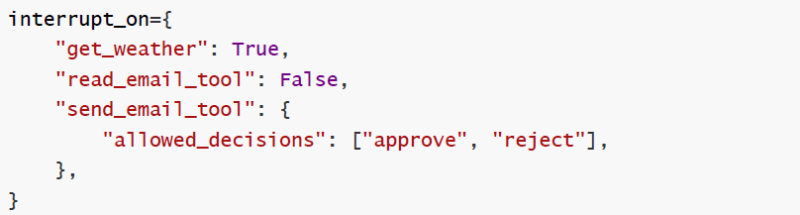
2.2 HumanInTheLoopMiddleware中间件
HumanInTheLoopMiddleware(人在环中间件、人工审核中间件)在工具调用前中断Agent运行,等待用户对工具调用请求决策。可选的决策有: approve(同意执行) 、edit(编辑调用配置后执行) 、rej...
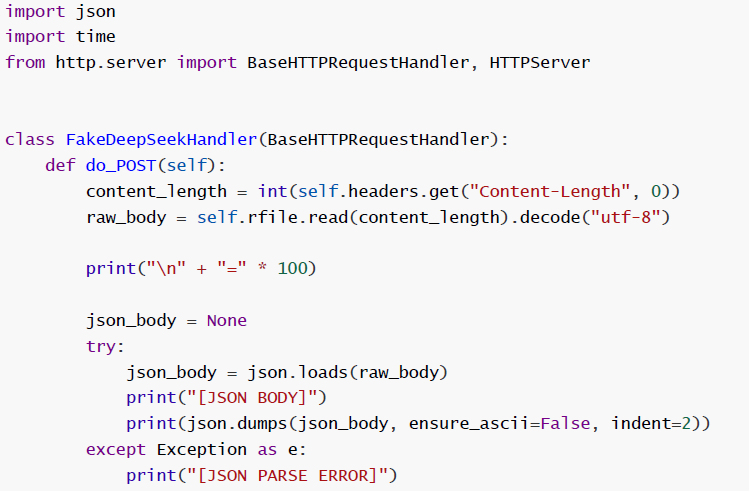
3、关于类型校验
验证不同schema定义方式在数据格式不匹配时的处理方式。 3.1 fake server 我们构造一个虚拟的DeepSeek服务端,客户端接收到的响应是人为构造的,主要目的是为了观察不同模式下LangChain会从响应...
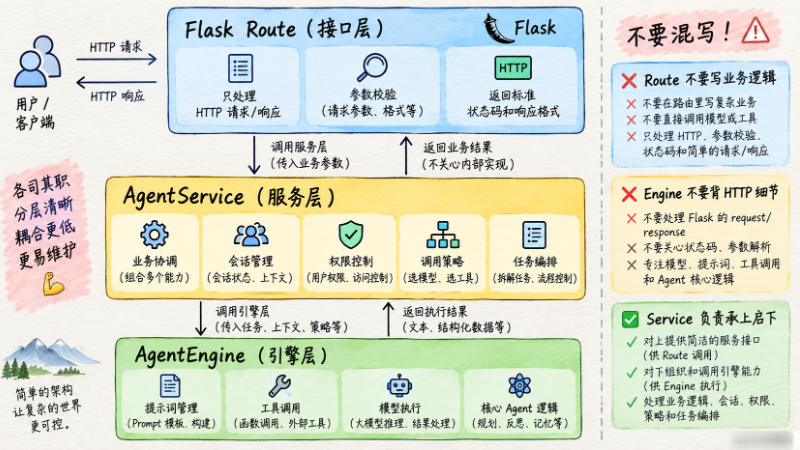
小节二:Flask Route、AgentService、AgentEngine 为什么必须分层?
先别急着看代码,先把分层关系在脑子里建立起来。下面这张图把三层结构拆得很细:最上层 Flask Route 只处理 HTTP 请求与响应,中间 AgentService 负责业务协调、会话、权限和任务编排,最下层 ...

3.5 模型评估与超参数调优
3.5.1 网格搜索 网格搜索(Grid Search)是一种系统化的超参数调优方法,通过遍历预定义的超参数组合,找到使模型性能最优的参数配置。通过自动化调参避免手动试错,提高效率。 网格搜索通常嵌...
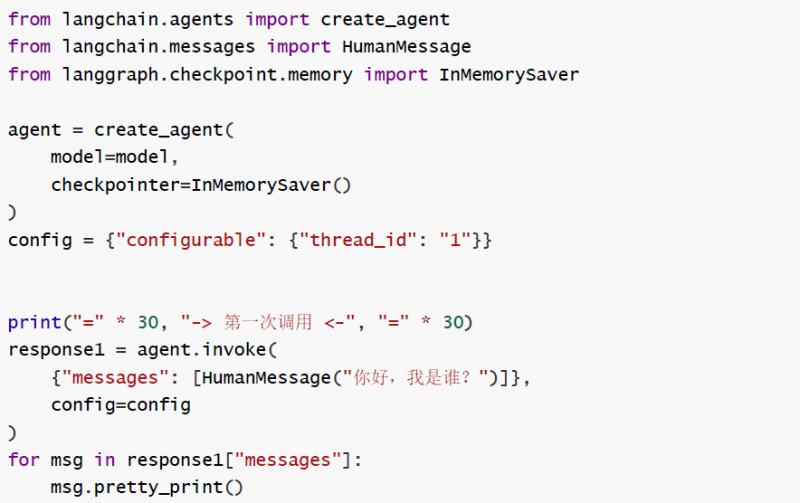
2.3 对比两种方式
举例1:基于内存存储 可以发现,每次执行的输出完全相同,而我们并没有更改thread_id ,之所以看不到上次运行的状态是因为每次运行创建新的Saver(),历史State被丢弃了。 举例2:基于外部存储器...
案例分析一:Coding Agent v2 成功率更高,但为什么不一定值得上线?
场景背景 v1: Success 84% Avg Steps 8 Avg Tokens 30K Cost 0.09 Latency 28s v2: Success 88% Avg Steps 19 Avg Tokens 95K Cost 0.27 Latency 77s 提升: 成功率 +4% 但成本: 3 倍 延迟:...
2. 变量与常量
2.1. 变量 1️⃣前情回顾 在上一节中,我们通过字面量的形式,记录了张三的体重,例如: 65.2 现在需要打印一些体重相关的内容,代码如下: print('张三的体重是', 65.2) print('对于', 65.2, '...
9、实战:多功能智能助手
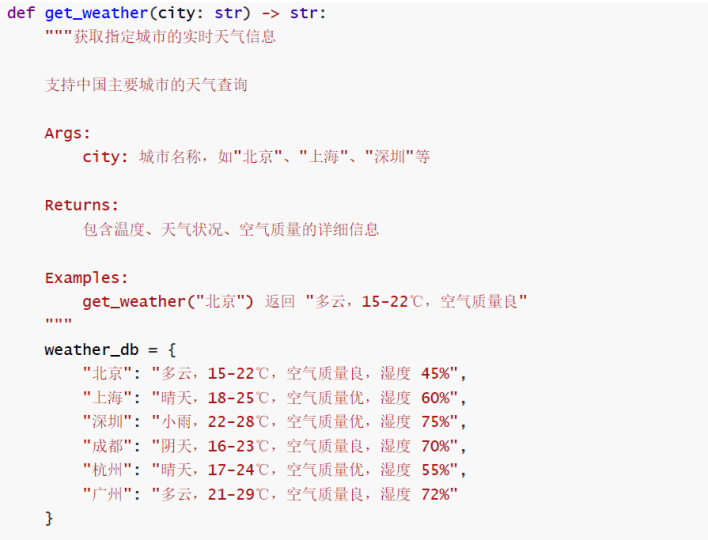
项目需求:开发一个多功能智能助手,支持: 天气查询:查询城市天气 数学计算:复杂数学运算 时间查询:获取当前时间、日期计算 货币转换:多种货币之间转换 信息搜索:搜索产品、新闻等信息 9....
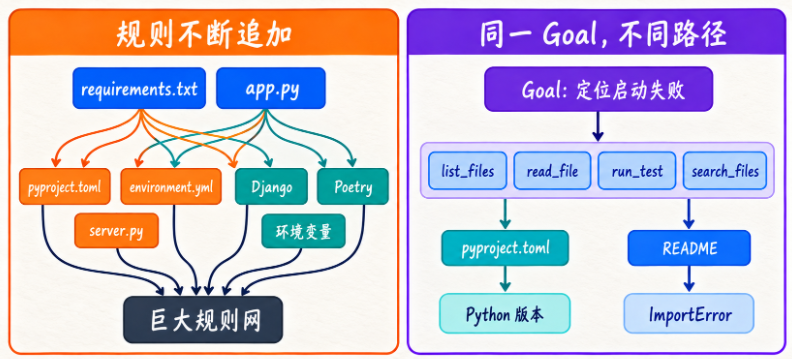
案例分析一:修复一个陌生 Python 项目——固定 Workflow 为什么会迅速膨胀?
场景背景 假设我们想做一个内部工具,用户提交一个 Python 项目,系统自动判断为什么项目启动失败。 第一版很自然: 读取 requirements.txt ↓ 读取 app.py ↓ 运行 python3 app.py ↓ 分析报错...

章末自测
题目 1:为什么 Agent Evaluation 不能只看“感觉回答不错”? 请从可重复性、过程行为、成本和安全四个方面解释。 “感觉不错”缺乏稳定标准,不同人判断会不同,也无法重复比较两个版本。Agen...

