

5.1 RAG开发
1)背景
大模型的知识冻结:随着 LLM 规模扩大,训练成本与周期相应增加,模型无法实时学习到最新的信
息或动态变化。导致 LLM 难以应对诸如“请推荐现在的热门影片”等时间敏感的问题。
大模型幻觉:涉及到大模型从未在训练过程中学习过的信息时,大模型无法给出准确的答复,转而开
始臆想和编造答案。
2)举例
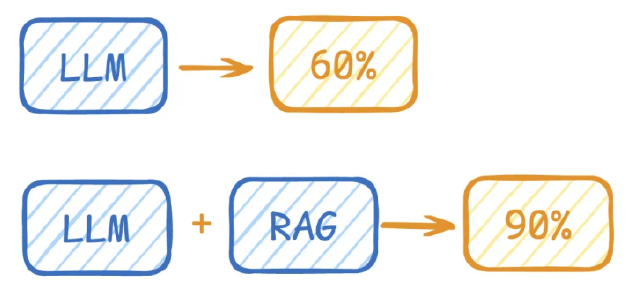
LLM在考试的时候面对陌生的领域,答复能力有限,然后就准备放飞自我了,而此时RAG给了一些提示
和思路,让LLM懂了开始往这个提示的方向做,最终考试的正确率从60%到了90%!
3)何为RAG?
Retrieval-Augmented Generation(检索增强生成)
图1:
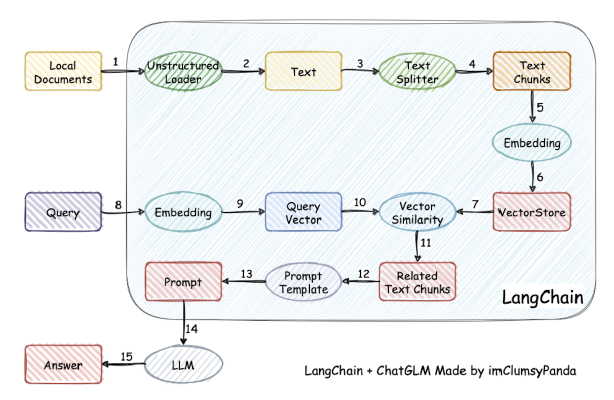
图2:
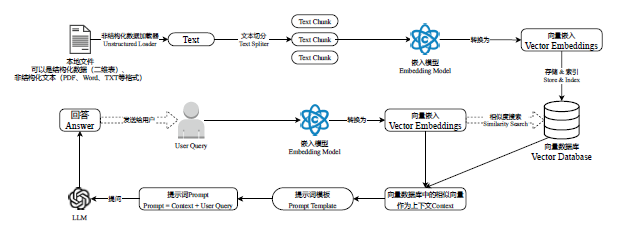
检索-增强-生成过程:检索可以理解为第10步,增强理解为第13步(这里的提示词包含检索到的数
据),生成理解为第15步。
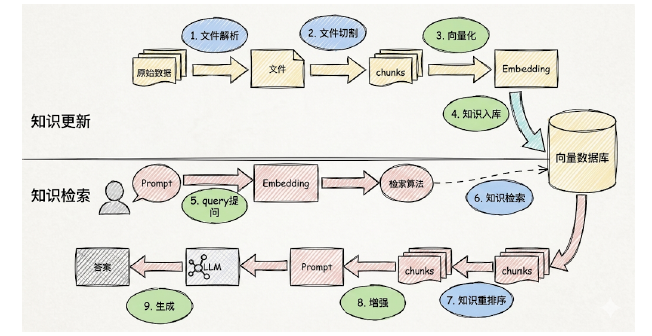
这些过程中的难点:1、文件解析 2、文件切割 3、知识检索 4、知识重排序
1、文件解析:如果是pdf,内部包含文件、图片、表格,图片上还有文字,需要处理。
2、文件切割:没有固定的格式
3、在 RAG 应用中,随着文档数量增加,召回准确率会下降,引入reranker(重排器)可对初步
召回的较多 chunk(如 top 20 或 top 50)进行精排,提高召回准确率,防止LLM 处理无关信
息,减少时间和成本。
此外,与基于基本矢量搜索的 RAG 相比,reranker增强型 RAG 的成本更高,但与仅依靠LLM 生
成答案相比,它的成本低些。
Reranker的使用场景:
适合:追求回答高精度和高相关性的场景中特别适合使用 Reranker,例如专业知识库或者客服
系统等应用。
不适合:引入reranker会增加召回时间,增加检索延迟。服务对响应时间要求高时,使用
reranker可能不合适。
5.2 Agent开发
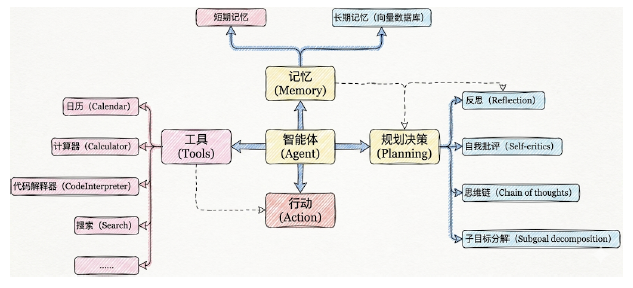
充分利用 LLM 的推理决策能力,通过增加规划、记忆和工具调用的能力,构造一个能够独立思考、逐步
完成给定目标的 Agent(智能体)。
类比举例:
一个数学公式来表示:
Agent = LLM + Planning + Tools + Memory + Action
比如,打车到西藏玩。
大脑中枢:规划行程的你
规划:步骤1:规划打车路线,步骤2:订饭店、酒店,。。。
调用工具:调用MCP或FunctionCalling等API,滴滴打车、携程、美团订酒店饭店
记忆能力:沟通时,要知道上下文。比如订酒店得知道是西藏路上的酒店,不能聊着聊着忘了最初
的目的。
能够执行上述操作。说走就走,不能纸上谈兵。
智能体核心要素被细化为以下模块:
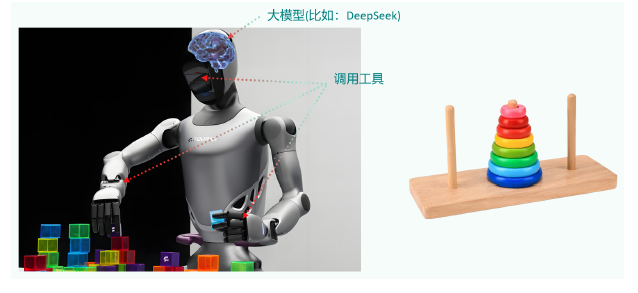
1、大模型(LLM)作为“大脑”:提供推理、规划和知识理解能力,是AI Agent的决策中枢。
大脑主要由一个大型语言模型 LLM 组成,承担着信息处理和决策等功能, 并可以呈现推理和规划
的过程,能很好地应对未知任务。
2、规划决策(Planning):通过任务分解、反思与自省框架实现复杂任务处理。例如,利用思维链
(Chain of Thought)将目标拆解为子任务,并通过反馈优化策略。
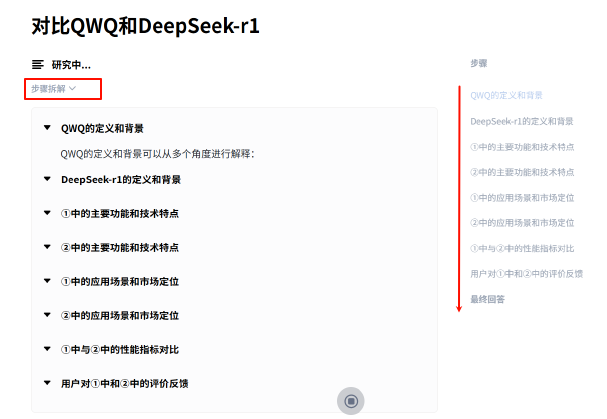
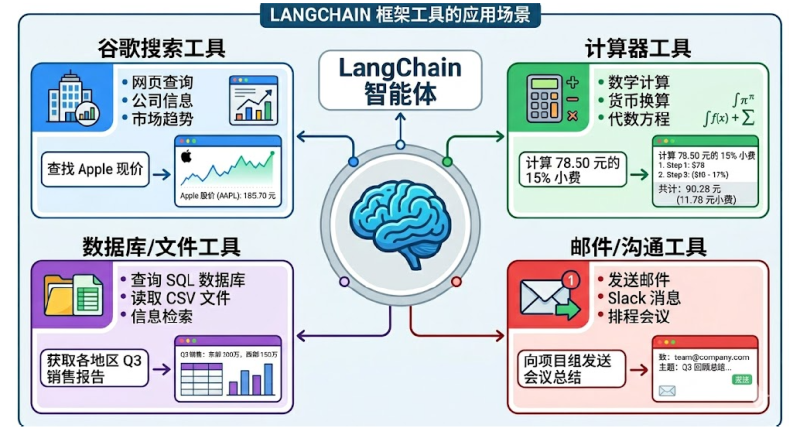
3、工具使用(Tool Use):调用外部工具(如API、数据库)扩展能力边界。
4、记忆(Memory)
智能体像人类一样,能留存学到的知识以及交互习惯等,这样的机制能让智能体在处理重复工作时
调用以前的经验,从而避免用户进行大量重复交互。
短期记忆:存储单次对话周期的上下文信息,属于临时信息存储机制。受限于模型的上下文窗口长
度。
长期记忆:可以横跨多个会话或时间周期,可存储并调用核心知识,非即时任务。
比如,关于用户的偏好,过去执行过的指令等。
长期记忆,可以通过模型参数微调(固化知识) 、知识图谱(结构化语义网络) 或向量数
据库(相似性检索) 方式实现。
5、行动(Action):实际执行决策的模块,涵盖软件接口操作(如自动订票)和物理交互(如机器人
执行搬运)。比如:检索、推理、编程等。
智能体会形成完整的计划流程。例如先读取以前工作的经验和记忆,之后规划子目标并使用相应工
具去处理问题,最后输出给用户并完成反思。











请登录后查看评论内容