

1、模型调用的准备工作
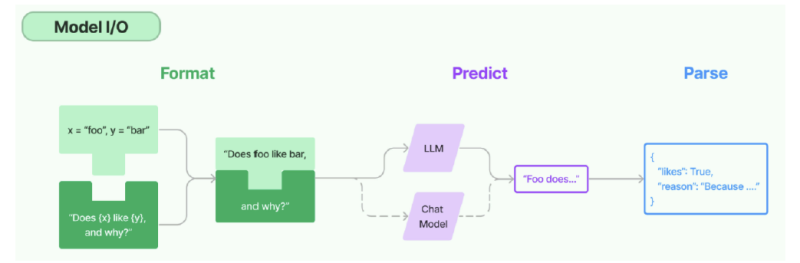
1.1 一张老图看大模型的调用
在LangChain v0.3版本中,提到了Model I/O,包括输入提示(Format)、调用模型(Predict)、输出解析(Parse)。分别对应着Prompt Template , Model 和Output Parser 。
关于模型调用模块,如今对话模型已经是主要形式。从历史上解读:
在GPT-3时代,大模型以补全模型为主,只能以类似“成语接龙”的方式对文本进行补全,并且实际运行效果也非常不稳定。此时LangChain借助一些高层封装的API,能够让模型完成对话、调用外部工具、甚至是结构化输出等功能,为开发者提供了极大的便利。伴随着GPT-3.5模型的发布, 对话模型正式登上历史的舞台,并逐渐成为主流。而得益于对话模型更强的指令跟随能力,很多GPT-3需要借助LangChain才能完成的工作,已经成为GPT-3.5原生自带的一些功能。所以,本章只提供了对话模型的创建,而没有了非对话模型。
1.2 模型初始化的分类方式
简单来说,就是用谁家的API以什么方式创建存放在哪个位置的大模型
角度1:调用谁家的API
- 使用模型提供商的库
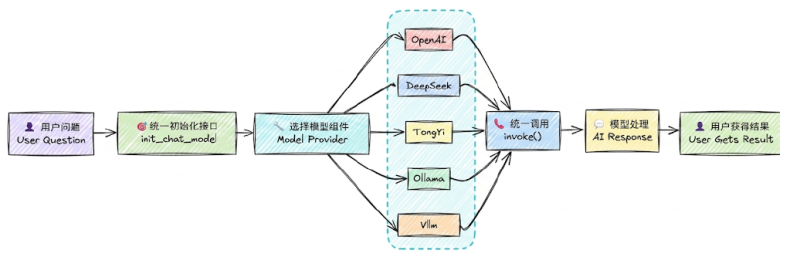
- 使用LangChain统一方式( 推荐)
角度2:模型初始化时,几个重要参数(如BASE_URL、API-KEY)的书写位置的不同:
- 使用配置文件( 推荐)
- 硬编码:写在代码文件中
角度3:调用的模型所在位置
- 在线部署的大模型
- 本地部署的大模型
LangChain作为一个“工具”,不提供任何 LLMs,而是依赖于第三方集成各种大模型。这里就看大模型到底部署在哪里。
1.3 线上大模型服务平台
有许多提供大模型API服务的平台,使用时只需要注册、充值并创建API-Key,之后即可使用API-Key与URL来调用平台提供的相应的模型的服务。
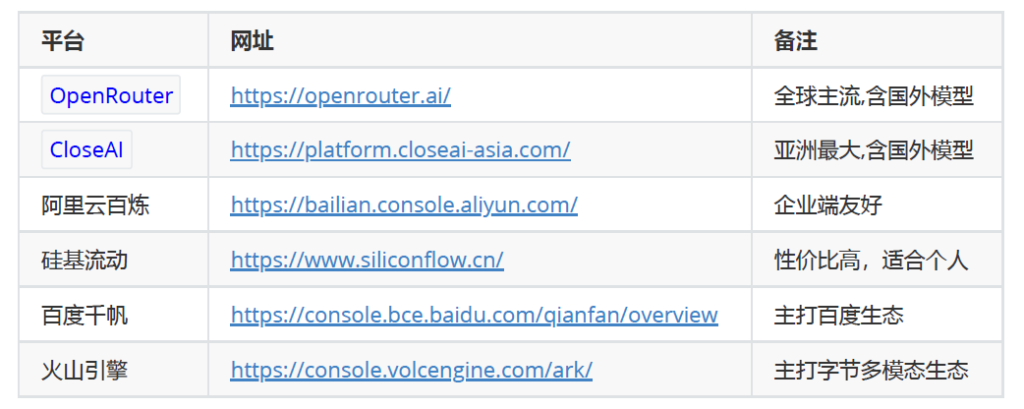
说明:每个平台配置时,都需要几个要素: 模型名、api-key 、base-url 。
如果大家想使用国外的大模型,就选择前两个;如果只使用国内的大模型,可以选择后四个。
阿里云百炼:所有新用户可获得超过5000万Tokens的免费额度及4500张图片生成额度。适合toB企业用户
硅基流动,号称9B 以下模型永久免费,开源模型价格低,适合个人学习。
此外,还有各个模型自己的厂商平台。比如deepseek、智谱等。
OpenRouter是一个第三方镜像站,专门转发大模型厂商的API服务。通过它我们可以间接调用几乎所有大模型厂商的API服务。支持国内直连。
OpenRouter支持支付宝或微信充值,最低限额$5,税费$0.8,此外,如果调用的模型禁止在国内使用,如ChatGPT,则无法通过OpenRouter直接调用(需要Magic),会提示This model is not available in your region,根据个人情况,决定是否充值并调用OpenRouter API。
1.4 提前安装所有依赖
课程中会涉及到多个库的安装,这里一并声明在 requirements.txt 文件中。
同时,LangChain的版本变化较快,不同版本之间可能存在兼容问题,为了避免因版本不一致导致的问题,本课程会通过 requirements.txt 固定主要依赖版本。
用法:将requirements.txt存放到项目所在的目录下,执行
(langchain1.2) PS D:\code\workspace_pycharm_llm\langchain1.2_tutorial>
pip install -r .\requirements.txt
说明:课程中的部分章节会单独列出相关依赖,主要是为了帮助大家了解该章节涉及的核心库。无需重复安装,这些依赖已经统一包含在 requirements.txt 中。











请登录后查看评论内容