

在 LangChain 中,模型调用(Invocation)是指通过特定方法触发大语言模型生成输出的过程。根据不
同的应用场景和需求,LangChain 提供了几种核心的调用方式,主要是 invoke() 、stream() 和
batch() 方法,以及它们的异步版本 ainvoke() 、astream() 和abatch() ,下面将系统地介绍这些方
法。
- invoke() :阻塞式,一次性返回完整结果问答、批处理任务、无需实时反馈的场景。
- ainvoke() :非阻塞式,提高系统吞吐量高并发Web应用、IO密集型任务。
- stream() :流式输出,实时返回每个token聊天机器人、长文本生成、需要提升用户体验的交互
- 应用。
- asteam() :非阻塞式,提高系统吞吐量高并发Web应用、IO密集型任务。
- batch() :批量处理多个输入高并发场景,需要同时处理大量请求。
- abatch() :非阻塞式,提高系统吞吐量高并发Web应用、IO密集型任务。
5.1 invoke()
invoke() 是 LangChain 中最核心的方法,它的工作模式是阻塞式的,即程序会等待模型完全生成整个响
应后,再一次性将结果返回给用户。
5.1.1 invoke()说明
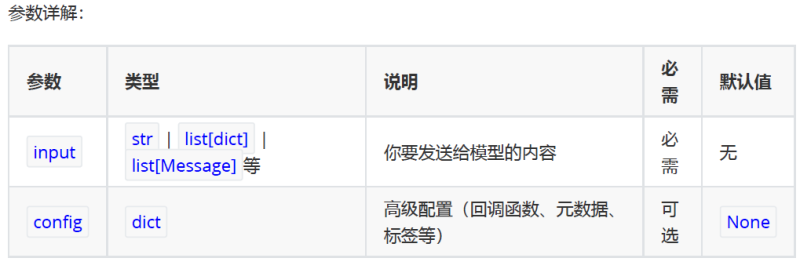
简单来说, invoke 方法的作用就是:
- 接收你的输入(问题、指令、对话历史等)
- 发送给 LLM 模型(如 GPT-4、Llama、Claude 等)
- 返回模型的响应(文本回复 + 元数据信息)
基本语法:
response = model.invoke(1 input, config=None)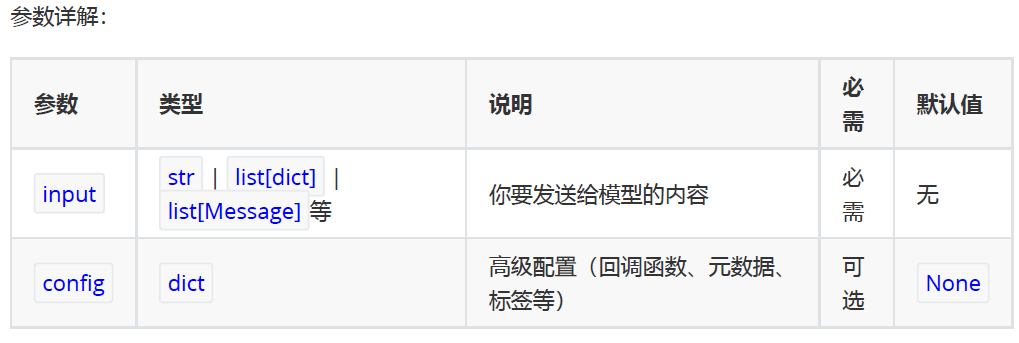
5.1.2 输入参数详解
invoke方法非常灵活,支持三种形式的输入: 文本输入、字典列表、消息对象列表。
1、文本输入(最简单)
简单的一次性问答,直接传入一个问题或指令。
✅适用场景:快速测试,不需要保留对话历史的简单生成任务。
❌缺点:无法设置系统提示(system prompt),无法传递对话历史
from langchain.chat_models import init_chat_model
from dotenv import load_dotenv
import os
# 从.env文件中加载环境变量
load_dotenv(override=True)
CLOSEAI_API_KEY = os.getenv("CLOSEAI_API_KEY")
CLOSEAI_BASE_URL = os.getenv("CLOSEAI_BASE_URL")
model = init_chat_model(
model="openai:gpt-5.4-mini",
api_key=CLOSEAI_API_KEY,
base_url=CLOSEAI_BASE_URL
)
# 向模型发送单条数据
prompt = "翻译成英文:你好世界"
response = model.invoke(prompt)
# 打印响应
print(response)
在 invoke 中直接输入文本,即可自动转化为 user message 并进行对话。
2、字典列表(推荐,最灵活)
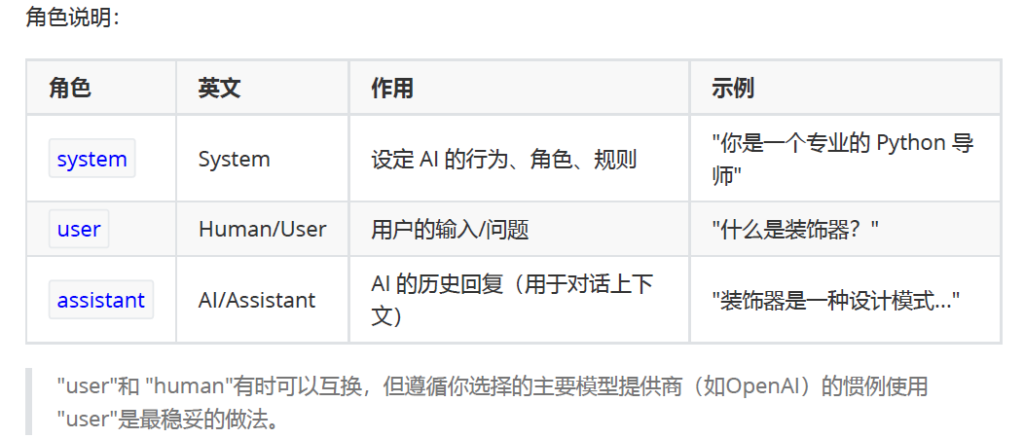
创建字典列表组成消息。一条消息通常包含 role(角色) 、content(内容) 等信息。
✅适用场景:可以设置系统提示,表达多轮对话历史,JSON 兼容,易于序列化和网络传输,生产环境
推荐。
❌缺点:代码稍微多一点(但更清晰)
格式:
messages = [
{"role": "system", "content": "系统提示"},
{"role": "user", "content": "用户消息"},
{"role": "assistant", "content": "AI回复"}, # 可选,用于对话历史
{"role": "user", "content": "继续提问"}
]
举例1:
from langchain.chat_models import init_chat_model
from dotenv import load_dotenv
import os
# 从.env文件中加载环境变量
load_dotenv(override=True)
CLOSEAI_API_KEY = os.getenv("CLOSEAI_API_KEY")
CLOSEAI_BASE_URL = os.getenv("CLOSEAI_BASE_URL")
model = init_chat_model(
model="gpt-5.4-mini",
model_provider="openai",
api_key=CLOSEAI_API_KEY,
base_url=CLOSEAI_BASE_URL
)
# 使用字典格式构建消息
messages = [
{"role":"system","content":"你是一个专业的数学老师。"},
{"role":"user","content":"什么是斐波那契数列?"}
]
response = model.invoke(messages)
# 打印响应
print(f"AI的回复:{response.content}")
举例2:多轮对话(带历史)
from langchain.chat_models import init_chat_model
from dotenv import load_dotenv
import os
# 从.env文件中加载环境变量
load_dotenv(override=True)
CLOSEAI_API_KEY = os.getenv("CLOSEAI_API_KEY")
CLOSEAI_BASE_URL = os.getenv("CLOSEAI_BASE_URL")
model = init_chat_model(
model="gpt-5.4-mini",
model_provider="openai",
api_key=CLOSEAI_API_KEY,
base_url=CLOSEAI_BASE_URL
)
# 使用字典格式构建消息
messages = [
{"role":"system","content":"你是一个专业的数学老师。"},
{"role":"user","content":"2 + 3 * 2 = ?"},
{"role":"assistant","content":"8"},
{"role":"user","content":"我刚才问了什么问题?"}
]
response = model.invoke(messages)
# 打印响应
print(f"AI的回复:{response.content}")
AI的回复:你刚才问的是1 :“2 + 3 * 2 = ?”
举例3:如果不传递历史,AI 会”失忆”
from langchain.chat_models import init_chat_model
from dotenv import load_dotenv
import os
# 从.env文件中加载环境变量
load_dotenv(override=True)
CLOSEAI_API_KEY = os.getenv("CLOSEAI_API_KEY")
CLOSEAI_BASE_URL = os.getenv("CLOSEAI_BASE_URL")
model = init_chat_model(
model="openai:gpt-5.4-mini",
api_key=CLOSEAI_API_KEY,
base_url=CLOSEAI_BASE_URL
)
messages1 = [
{"role": "system", "content": "你是一个非常友好的AI助手"},
{"role": "user", "content": "你好,我叫小明"},
]
# 第一次对话
response1 = model.invoke(messages1)
# 打印响应
print(f"AI的回复1:{response1.content}")
messages2 = [
{"role": "user", "content": "我叫什么名字?"}
]
# 第二次对话
response2 = model.invoke(messages2)
# 打印响应
print(f"AI的回复2:{response2.content}")
AI的回复1:你好,小明!很高兴认识你 😊
我是你的AI助手,有什么我可以帮你的吗?
AI的回复2:我不知道你的名字,除非你告诉我。
如果你愿意,可以直接告诉我,我之后就可以这样称呼你。
作为对比,传递记忆:
conversation = [
{"role": "system", "content": "你是一个非常友好的AI助手"},
{"role": "user", "content": "你好,我叫小明"}
]
# 第一次对话
response1 = model.invoke(conversation)
# 打印响应
print(f"AI的回复1:{response1.content}")
# 添加记忆
conversation.append({"role": "assistant", "content": response1.content})
conversation.append({"role": "user", "content": "我叫什么名字?"})
# 第二次对话
response2 = model.invoke(conversation)
print(f"AI的回复2:{response2.content}")
AI的回复1:你好,小明!很高兴认识你 😊
我是你的AI助手,有什么我可以帮你的吗?
AI的回复2:你叫小明。
说明:关于消息列表的内容此处不必深究,Messages章节会系统介绍。
3、消息对象列表
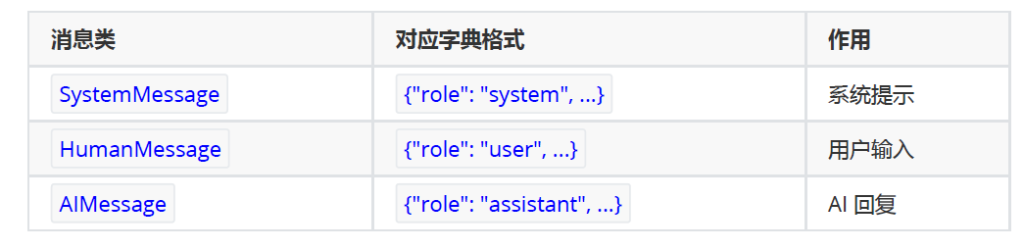
使用内置的消息类(如 SystemMessage, HumanMessage, AIMessage),将消息对象列表输入模型。
✅适用场景:需要类型检查(针对大型项目)、IDE 自动补全的场景
❌缺点:代码较长、不如字典简洁、难以序列化(JSON)
消息类型对照:
举例1:
from langchain_core.messages import SystemMessage, AIMessage, HumanMessage
from langchain.chat_models import init_chat_model
from dotenv import load_dotenv
import os
# 从.env文件中加载环境变量
load_dotenv(override=True)
CLOSEAI_API_KEY = os.getenv("CLOSEAI_API_KEY")
CLOSEAI_BASE_URL = os.getenv("CLOSEAI_BASE_URL")
model = init_chat_model(
model="openai:gpt-5.4-mini",
api_key=CLOSEAI_API_KEY,
base_url=CLOSEAI_BASE_URL
)
# 使用消息对象格式构建消息
messages = [
SystemMessage("你是一个专业的数学老师。"),
HumanMessage("2 + 3 * 2 = ?"),
AIMessage("8"),
HumanMessage("我刚才问什么问题了?")
]
response = model.invoke(messages)
# 打印响应
print(f"AI的回复:{response.content}")
举例2:
from langchain_core.messages import SystemMessage, HumanMessage, AIMessage
messages = [
SystemMessage(content="你是一个 Python 专家"),
HumanMessage(content="什么是生成器?"),
]
response = model.invoke(messages)
# print(response)
# 继续对话
messages.append(AIMessage(content=response.content))
messages.append(HumanMessage(content="能给个例子吗?"))
response1 = model.invoke(messages)
print(response1)
5.1.3 返回值详解
def invoke(
self,
input: LanguageModelInput,
config: RunnableConfig | None = None,
*,
stop: list[str] | None = None,
**kwargs: Any,
) -> AIMessage:
举例:
from langchain_core.messages import SystemMessage, AIMessage, HumanMessage
from langchain.chat_models import init_chat_model
from dotenv import load_dotenv
import os
# 从.env文件中加载环境变量
load_dotenv(override=True)
CLOSEAI_API_KEY = os.getenv("CLOSEAI_API_KEY")
CLOSEAI_BASE_URL = os.getenv("CLOSEAI_BASE_URL")
model = init_chat_model(
model="gpt-5.4-mini",
api_key=CLOSEAI_API_KEY,
base_url=CLOSEAI_BASE_URL
)
# 使用字典格式构建消息
response = model.invoke([HumanMessage("2 + 3 * 2 = ?")])
# 打印响应
print(type(response))
# <class 'langchain_core.messages.ai.AIMessage'>
from rich import print as rprint
rprint(response)
AIMessage(
content='2 + 3 * 2 = **8**',
additional_kwargs={'refusal': None},
response_metadata={
'token_usage': {
'completion_tokens': 15,
'prompt_tokens': 16,
'total_tokens': 31,
'completion_tokens_details': {
'accepted_prediction_tokens': 0,
'audio_tokens': 0,
'reasoning_tokens': 0,
'rejected_prediction_tokens': 0
},
'prompt_tokens_details': {'audio_tokens': 0, 'cached_tokens':
0},
'latency_checkpoint': {
'engine_tbt_ms': 4,
'engine_ttft_ms': 36,
'engine_ttlt_ms': 100,
'pre_inference_ms': 86,
'service_tbt_ms': 4,
'service_ttft_ms': 280,
'service_ttlt_ms': 338,
'total_duration_ms': 259,
'user_visible_ttft_ms': 194
}
},
'model_provider': 'openai',
'model_name': 'gpt-5.4-mini-2026-03-17',
'system_fingerprint': None,
'id': 'chatcmpl-DgWobsxhDOqzjqVFwbZYKRnovpEiV',
'service_tier': 'default',
'finish_reason': 'stop',
'logprobs': None
},
id='lc_run--019e3659-5ee2-7b62-bc8a-741e27374b43-0',
tool_calls=[],
invalid_tool_calls=[],
usage_metadata={
'input_tokens': 16,
'output_tokens': 15,
'total_tokens': 31,
'input_token_details': {'audio': 0, 'cache_read': 0},
'output_token_details': {'audio': 0, 'reasoning': 0}
}
)AIMessage中包含丰富的信息,以上面案例的输出为例,整体说明如下:
AIMessage(
# --- 核心内容 ---
content='2 + 3 * 2 = **8**', # 模型生成的最终文本答案
additional_kwargs={
'refusal': None# 模型拒绝回答的情况(如触碰安全策略),None 表示正常回答
},
# --- 响应元数据(API 返回的详细原始数据) ---
response_metadata={
'token_usage': {
'completion_tokens': 15, # 生成回答消耗的 Token 数(输出)
'prompt_tokens': 16, # 用户输入消耗的 Token 数(输入)
'total_tokens': 31, # 本次交互总共消耗的 Token
'completion_tokens_details': {
'accepted_prediction_tokens': 0, # 预测性生成的 Token 数
'audio_tokens': 0, # 音频生成消耗(如有)
'reasoning_tokens': 0,# 推理模型(如 o1)思考过程消耗的 Token
'rejected_prediction_tokens': 0 # 被拒绝的预测 Token
},
'prompt_tokens_details': {
'audio_tokens': 0, # 输入中的音频 Token 数
'cached_tokens': 0 # 命中的缓存 Token 数(能省钱/提速)
},
# --- 延迟性能监控(单位:毫秒 ms) ---
'latency_checkpoint': {
'engine_tbt_ms': 4, # 引擎 Token 间平均间隔时间
'engine_ttft_ms': 36, # 引擎生成首个 Token 的时间
'engine_ttlt_ms': 100, # 引擎生成最后一个 Token 的时间
'pre_inference_ms': 86, # 推理前的预处理耗时(安全审核、Token 化等
预处理)
'service_tbt_ms': 4, # 服务端token与token之间生成的间隔时间,决定
了打字机效果是否丝滑。
'service_ttft_ms': 280, # 服务端接收到请求到输出首字的总时间
'service_ttlt_ms': 338, # 服务端完成全部输出的总时间
'total_duration_ms': 259, # 本次请求在系统中记录的总持续时长
'user_visible_ttft_ms': 194 # 用户看到第一个字跳出来等待的时间
}
},
'model_provider': 'openai', # 模型供应商
'model_name': 'gpt-5.4-mini-2026-03-17', # 使用的具体模型版本
'system_fingerprint': None, # 系统指纹,用于追踪模型后端的配置变
更
'id': 'chatcmpl-DgWobsxhDOqzjqVFwbZYKRnovpEiV', #API层面的响应 ID
'service_tier': 'default', # 服务层级(如按量付费或订阅)
'finish_reason': 'stop', # 停止原因:stop(自然结束)、length(长度受
限)
'logprobs': None # 对数概率(通常用于分析词汇选择的可能性)
},
# --- LangChain 内部标识 ---
id='lc_run--019e3659-5ee2-7b62-bc8a-741e27374b43-0',
# LangChain 追踪此条运行的唯一 ID
# --- 工具调用信息 ---
tool_calls=[], # 正常触发的外部工具调用列表
invalid_tool_calls=[], # 触发失败或格式错误的工具调用
# --- 统一消耗元数据(LangChain 标准化后的消耗格式) ---
usage_metadata={
'input_tokens': 16, # 输入 Token 数
'output_tokens': 15, # 输出 Token 数
'total_tokens': 31, # 总 Token 数
'input_token_details': {
'audio': 0,
'cache_read': 0 # 从缓存中读取的输入数量
},
'output_token_details': {
'audio': 0,
'reasoning': 0 # 包含在输出中的推理 Token
}
}
)
总结一下:
- 核心内容与基本信息
- content : 模型生成的文本回答。这是你最关心的核心输出。
- id : 本次运行在 LangChain 内部生成的唯一标识符(Run ID)。
- additional_kwargs : 包含特定供应商的额外参数。
- refusal : 如果模型拒绝回答(涉及敏感政策),此处会显示拒绝原因。
- 消耗统计 (Token Usage)
这部分决定了你这一行输入操作花了多少钱:
- prompt_tokens / input_tokens : 输入 Token 数。你发送给模型的问题长度。
- completion_tokens / output_tokens : 输出 Token 数。模型回答生成的长度。
- total_tokens : 总消耗。 两者之和。
- reasoning_tokens : 推理 Token 数。 如果是 O1/O3 等推理模型,这里会显示它在“思考”时消耗的 Token。
- cached_tokens : 缓存命中的 Token 数。重复提问时,如果命中了模型商的缓存,这部分费用通常更低。
3. 响应元数据 (Response Metadata)
这部分是 API 返回的原始详细信息:
- model_name : 实际调用的模型具体版本(如 gpt-5.4-mini )。
- model_provider : 模型供应商(如 openai )。
- finish_reason : 生成停止的原因。
- stop : 正常回答结束。
- length : 达到最大 Token 限制被截断。
- system_fingerprint : 系统指纹,用于追踪模型后端的配置变更。
4. 性能与延迟 (Latency Checkpoint)
这是针对 API 响应速度的深度拆解(单位通常为毫秒 ms):
- total_duration_ms : 总耗时。从请求发出到完全收到的总时间(259ms)。
- user_visible_ttft_ms : 首字到达时间。用户看到第一个字跳出来等待的时间(194ms),这是体感快慢的关键。
- engine_ttft_ms : 引擎层面的首字到达时间(36ms)。
- engine_ttlt_ms : 引擎生成最后一个字的时间(100ms)。
- pre_inference_ms : 推理前处理耗时。包括安全审核、Token 化等预处理(86ms)。
- service_tbt_ms : Time Between Tokens。字与字之间生成的间隔时间,决定了打字机效果是否丝滑。
5. 工具调用信息
- tool_calls : 结构化工具调用列表。如果模型决定调用某个 Python 函数或搜索工具,参数会在这里。
- invalid_tool_calls : 格式错误的工具调用尝试。
举例:访问所有信息
response = model.invoke("用一句话解释什么是 AI")
# 1. 获取回复内容
print("AI 回复:", response.content)
# 2. 获取响应元数据
metadata = response.response_metadata
print(f"使用的模型: {metadata['model_name']}")
print(f"结束原因: {metadata['finish_reason']}")
print(f"模型提供商:{metadata['model_provider']}\n")
# 3. 获取 Token 使用情况
usage = metadata.get('token_usage', {})
print(f"输入 tokens: {usage.get('prompt_tokens')}")
print(f"输出 tokens: {usage.get('completion_tokens')}")
print(f"总计 tokens: {usage.get('total_tokens')}")
# 4. 获取消息 ID
print(f"消息 ID: {response.id}")
AI 回复: AI(人工智能)就是让机器模拟人类的学习、推理、识别和决策能力。
使用的模型: gpt-5.4-mini-2026-03-17
结束原因: stop
模型提供商:openai
输入 tokens: 13
输出 tokens: 28
总计 tokens: 41
消息 ID: lc_run--019e3665-8dfa-7c53-a9a5-4995348a0258-0










请登录后查看评论内容