

2.1 环境准备
2.1.1 安装依赖
我们在《第02章-模型调用》章节已经通过requirements.txt 文件安装过课程的依赖。当时考虑到本章RAG模块涉及的依赖较多且大,所以不在之前的依赖文件中。所以,这里大家需要补充安装RAG涉及到的依赖。完整版文件见《02-资料requirements_full.txt》
pip install -r requirements_1 full.txt检查冲突
pip check如果环境安装正确,则日志如下
(langchain1.2) PS C:\Users\shkstart\OneDrive\文档\AI\langchain> pip check
No broken requirements found.
(langchain1.2) PS C:\Users\shkstart\OneDrive\文档\AI\langchain>
2.1.2 准备数据
将 knowledge.txt 置于项目根目录下
将 asset文件夹 解压后置于项目根目录下
2.2 文档加载器 Document Loaders
数据源可能包含多种格式的文件,如文本文档、Markdown,PDF 等。LangChain 实现和集成了众多文
档加载器(https://docs.langchain.com/oss/python/integrations/document_loaders ),方便从不同
格式的文件中加载数据。
常用 Loaders:
- TextLoader – 文本文件
- CSVLoader – CSV 文件
- PyPDFLoader – PDF 文件
- WebBaseLoader – 网页
LangChain的设计:对于Source 中多种不同的数据源,我们可以用一种统一的形式读取、调用。上述
每一个文档加载器,都要继承自 BaseLoader 基类,此类提供了通用的 load (一次加载所有文档)
与 lazy_load (以延迟方式加载文档) 方法,用于从数据源加载数据并处理为Document 对象。
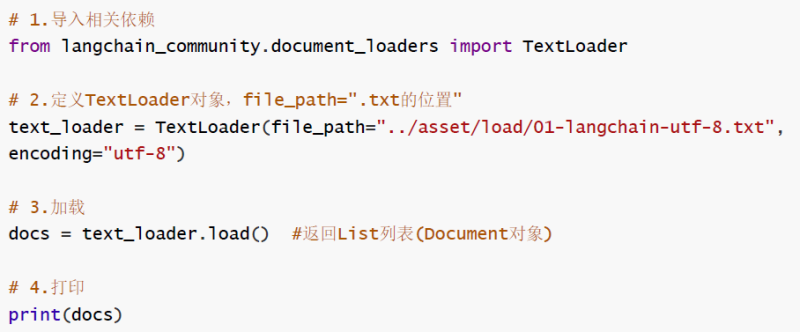
2.2.1 加载txt
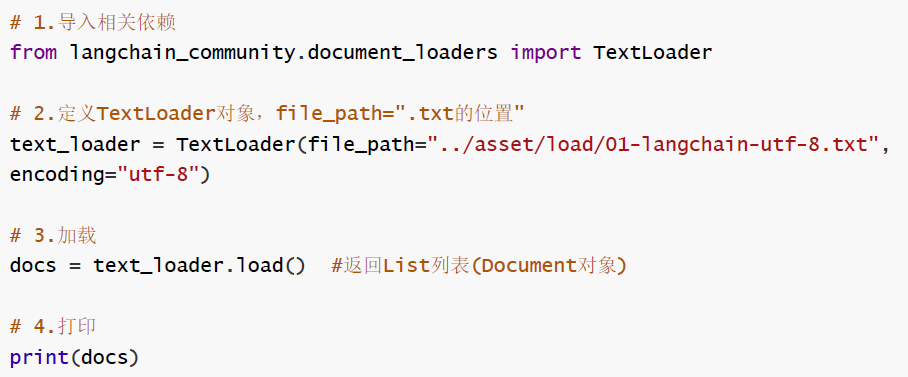
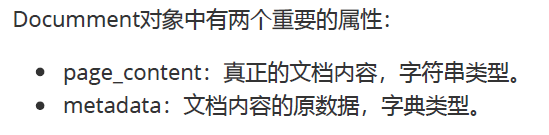
print(type(docs[0])) #langchain_core.documents.1 base.Document
print(docs[0].page_content)
'''
LangChain 是一个用于开发由大型语言模型 (LLMs) 驱动的应用程序的框架。LangChain简化了LLM
应用程序生命周期的每个阶段。\nLangChain 已经成为了我们每一个大模型开发工程师的标配。
'''
print(docs[0].metadata) # {'source': './1 data/langchain.txt'}
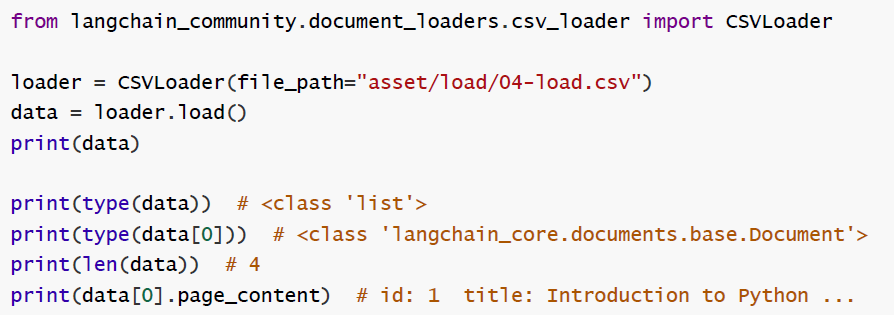
2.2.2 加载CSV
举例:加载csv所有列
2.2.3 加载JSON
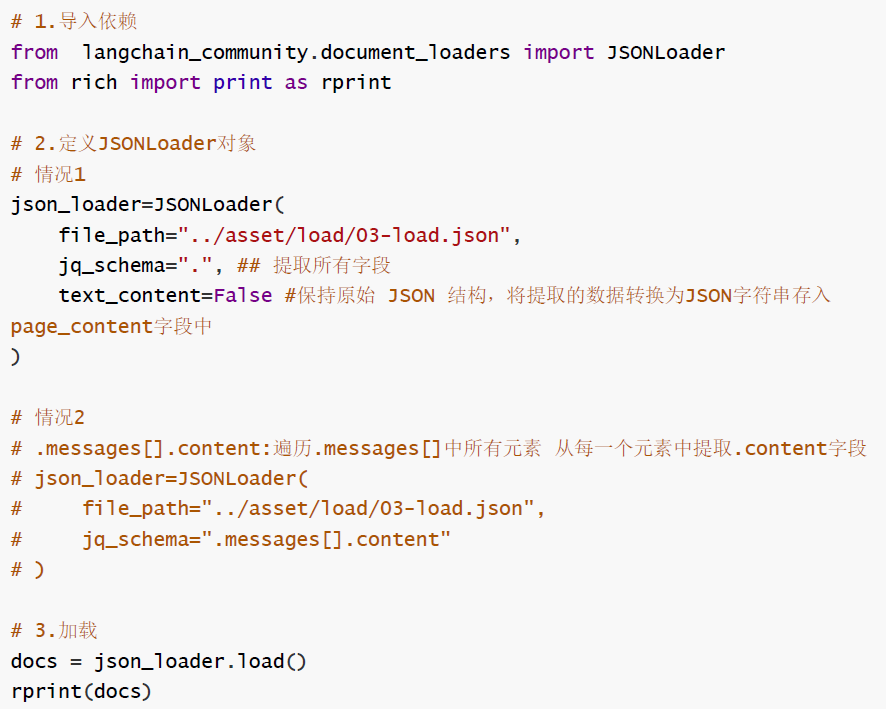
LangChain提供的JSON格式的文档加载器是JSONLoader 。在实际应用场景中,JSON格式的数据占有很大比例,而且JSON的形式也是多样的。我们需要特别关注。
JSONLoader 使用指定的 jq结构来解析 JSON 文件。jq是一个轻量级的命令行 JSON 处理器 ,可以对JSON 格式的数据进行各种复杂的处理,包括数据过滤、映射、减少和转换,是处理 JSON 数据的首选工具之一。
# 在requirements_full.txt中已经安装
pip install jq
举例1:使用JSONLoader文档加载器加载
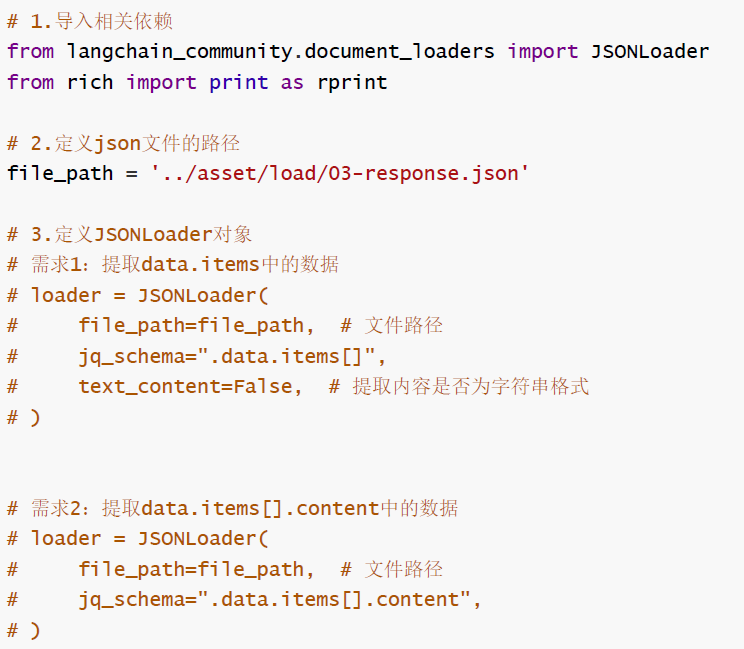
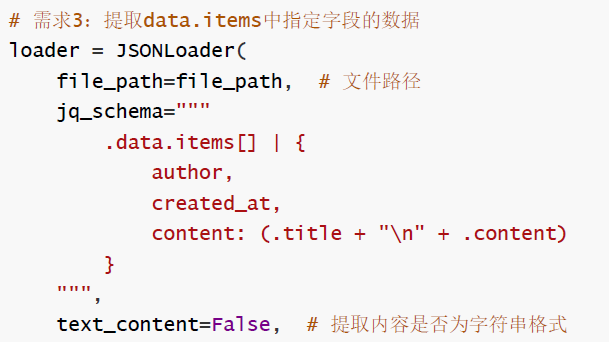
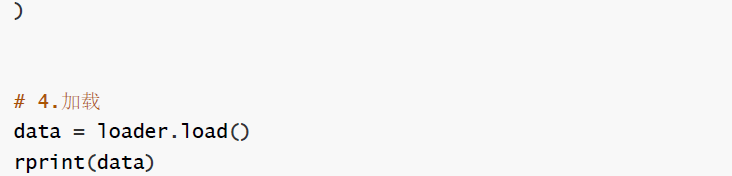
举例2:提取03-response.json文件中指定的文本
2.2.4 加载pdf
PDF 存在多种来源格式,包括扫描版(图片 PDF)、电子文本版、混合版。并且布局格式也多种多样,包括单列布局、双列布局甚至竖排文本布局。并且包含段落、标题、页眉页脚、表格、数学公式、化学式、特殊符号、图片等各种元素。
因此,PDF 解析存在很多挑战。对于复杂 PDF,需要进行文本提取、布局检测、表格解析、公式识别等处理。
方式1:PyPDFLoader
LangChain加载PDF文件使用的是pypdf,先安装
# 在requirements_full.txt中已经安装
pip install pypdf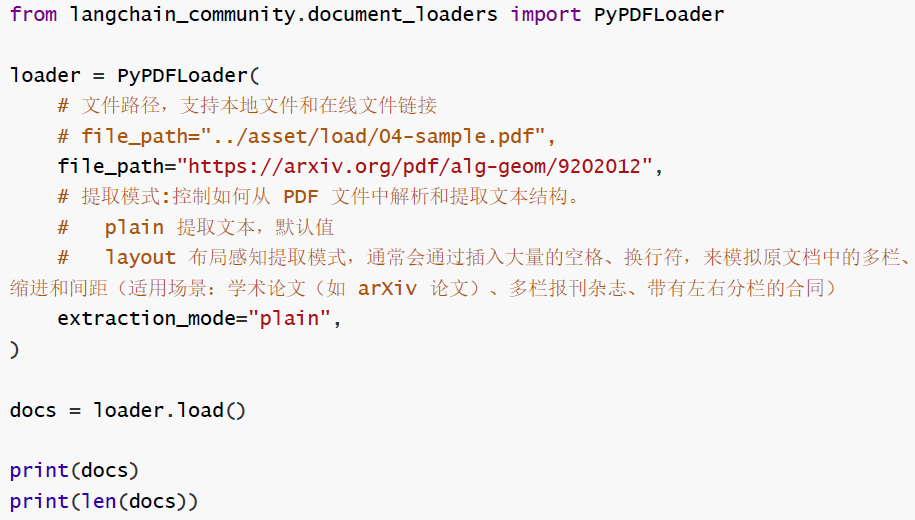
方式2:MinerU
MinerU 提供了 PDF、Word、PPT、图片等文件的解析,支持图像提取、OCR、公式、表格解析等功能。
调用在线服务:https://mineru.net/apiManage/docs。可以从本地批量上传文件进行解析,并接收解析结果。
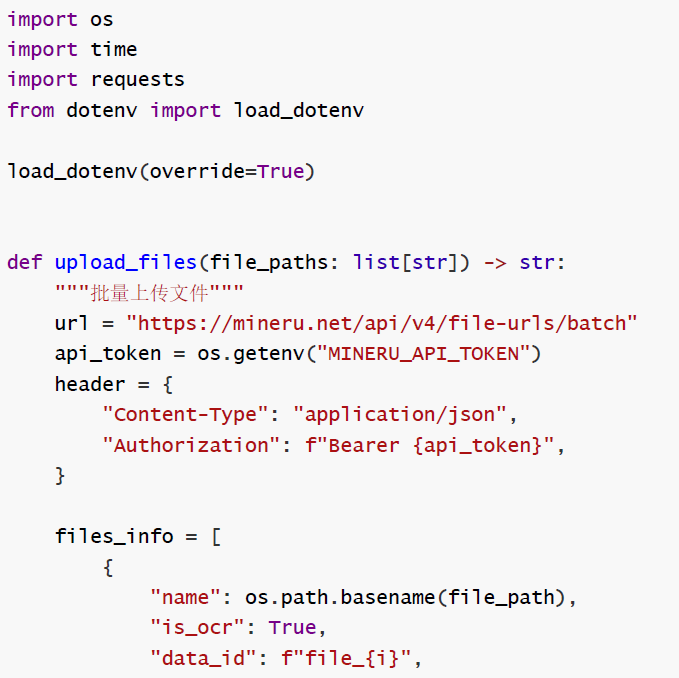
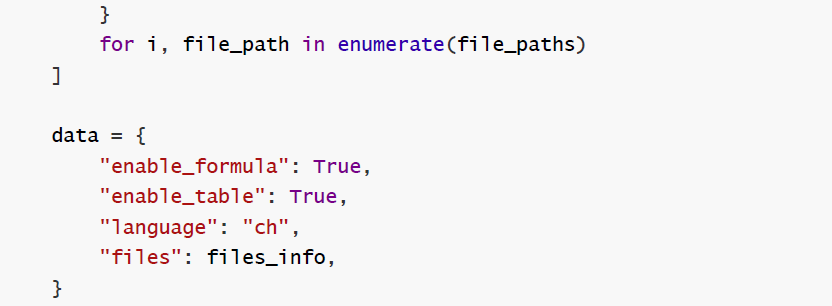
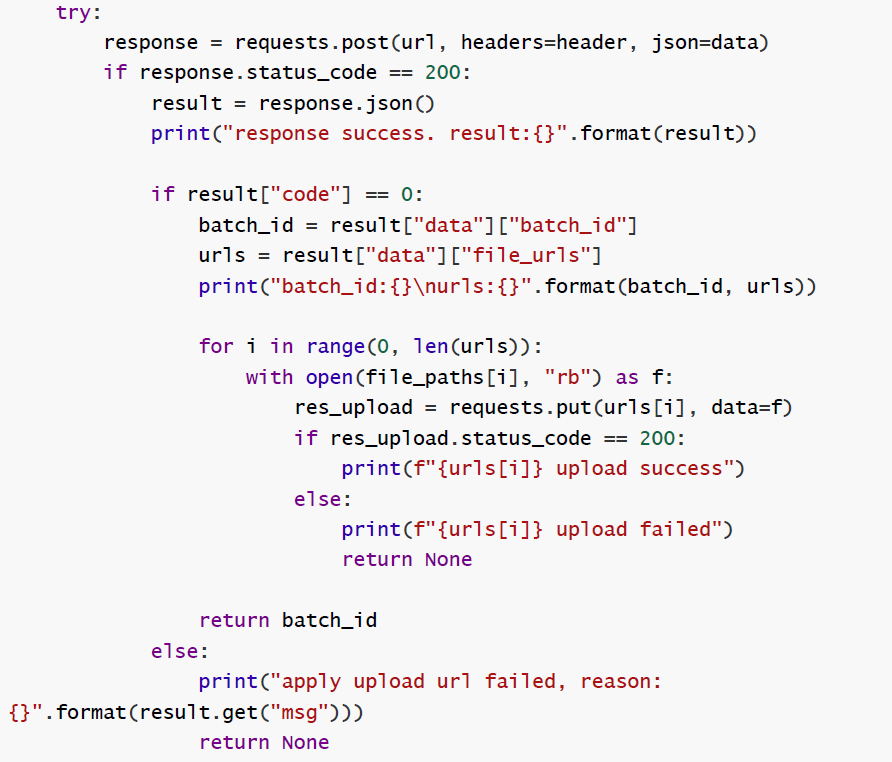
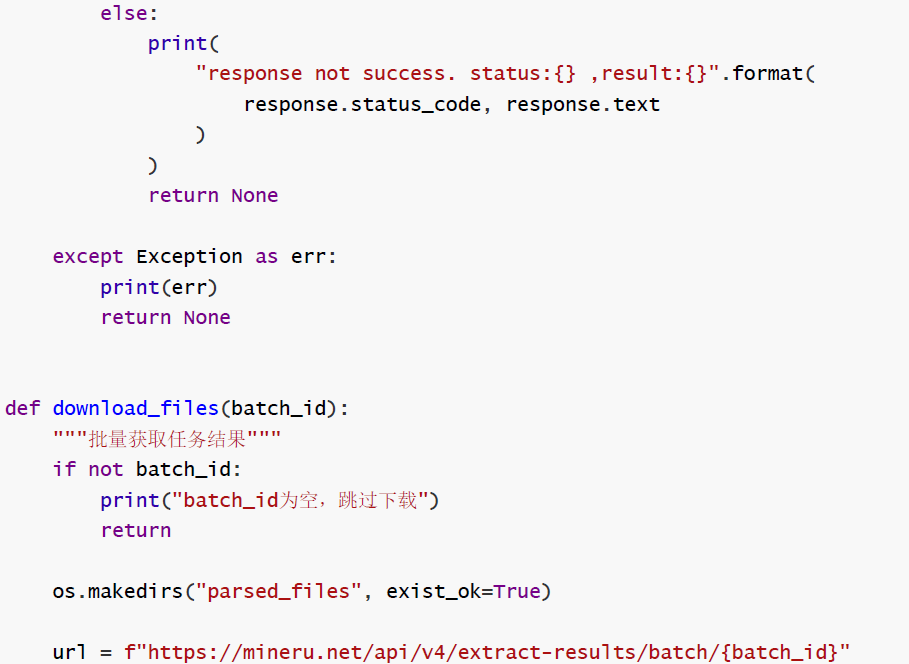
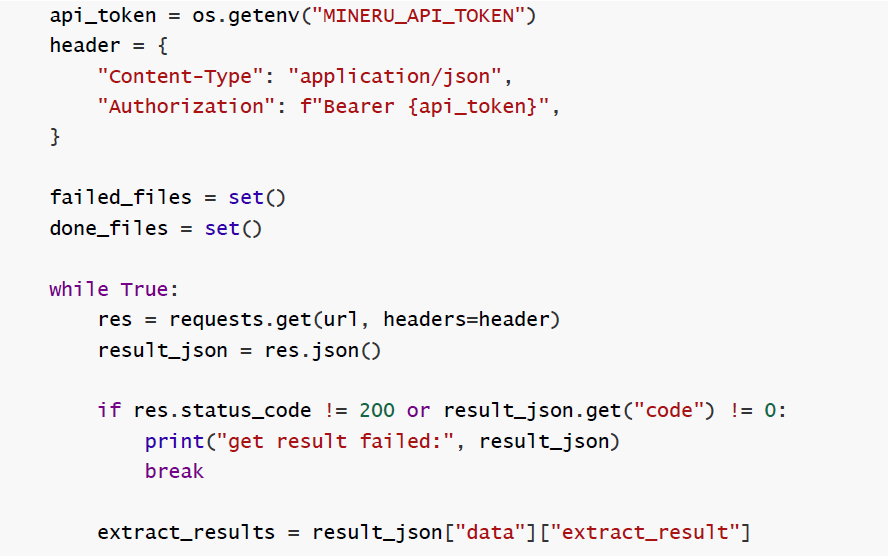
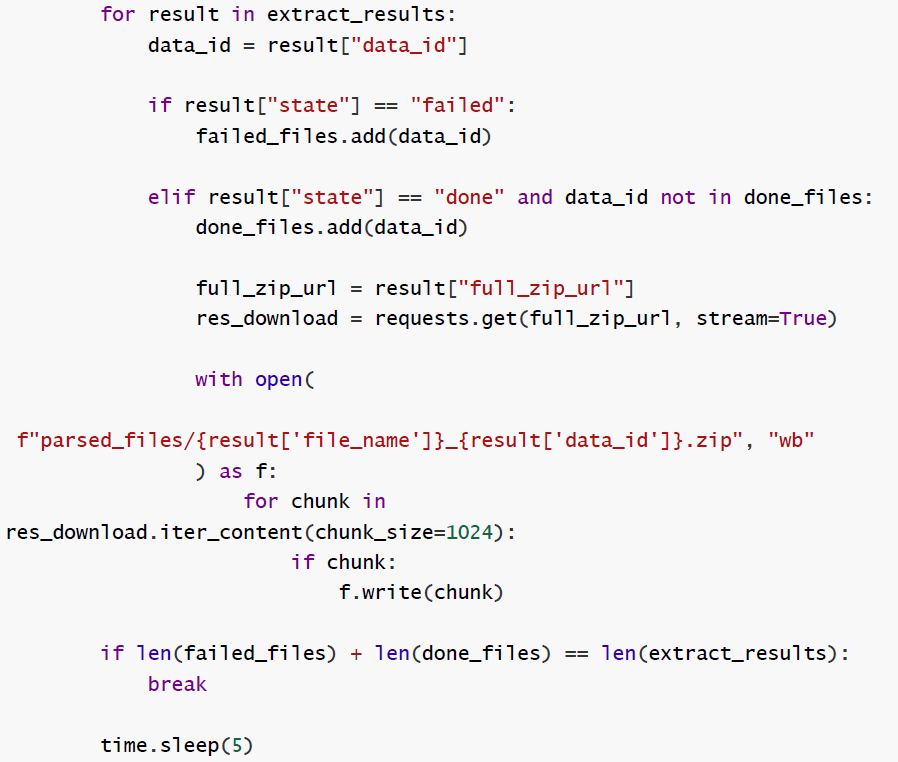
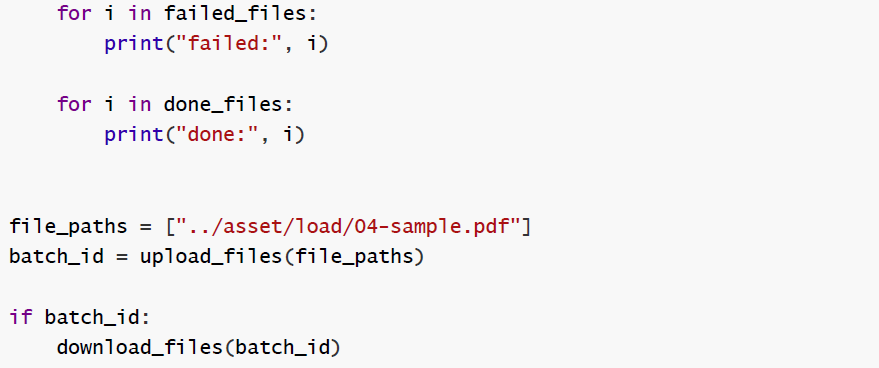
说明:需要在.env文件中提供:
#MinerU的API_TOKEN
MINERU_API_TOKEN=<你的API TOKEN>
2.2.5 加载word
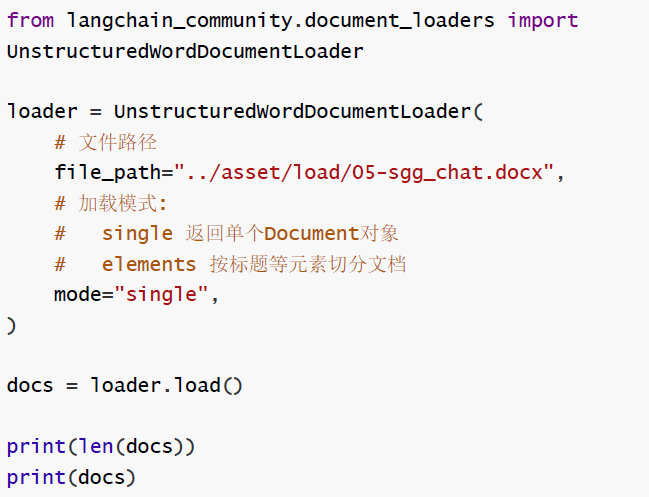
可使用 UnstructuredWordDocumentLoader加载 Word 文件,需要 unstructured 包。(已在
requirements_full.txt文件中安装)
举例:
2.2.6 加载Markdown
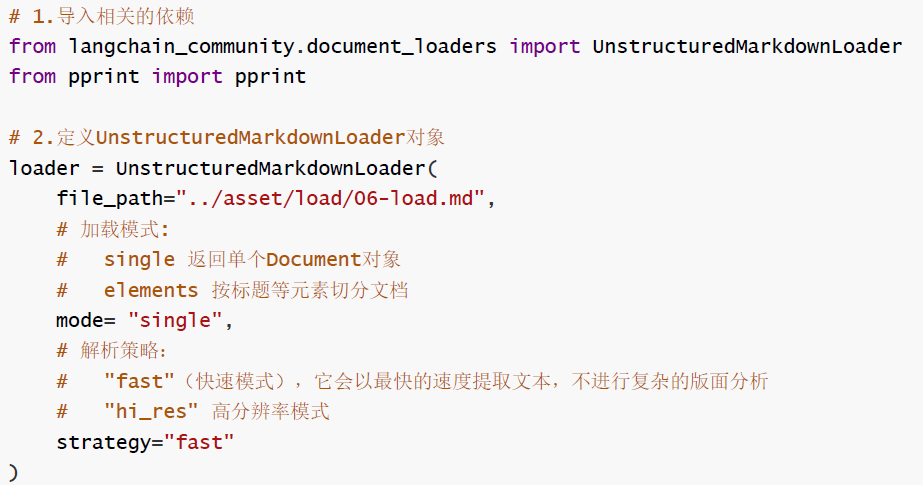
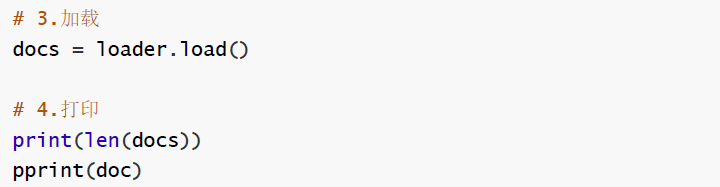
可使用 UnstructuredMarkdownLoader 加载 Markdown 文件,需要 unstructured 包。(已在requirements_full.txt文件中安装)
举例1:使用UnstructuredMarkdownLoader加载md文件
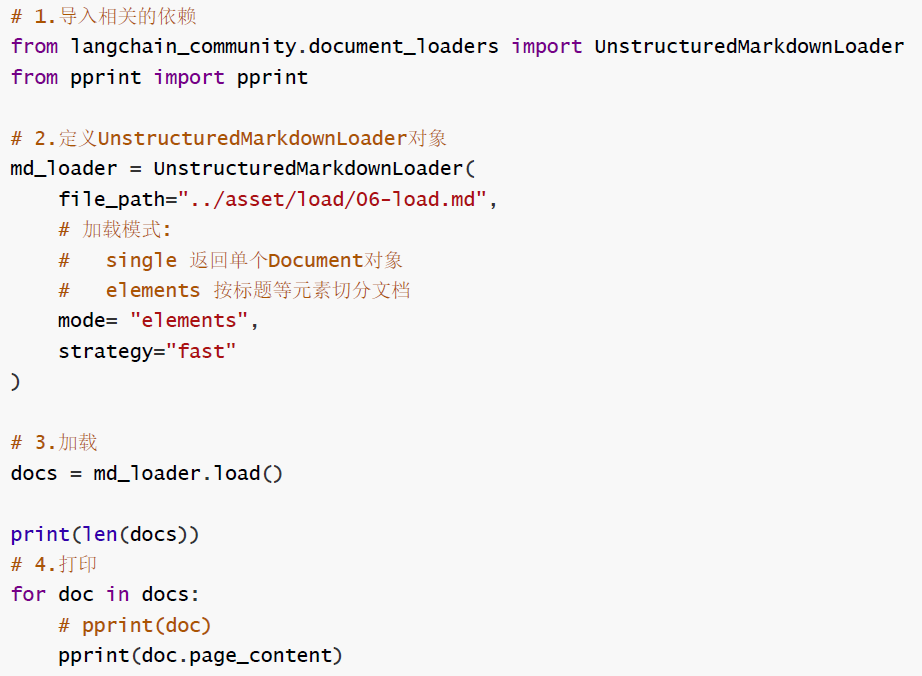
举例2:精细分割文档,保留结构信息
将Markdown文档按语义元素(标题、段落、列表、表格等)拆分成多个独立的小文档( Element 对象),而不是返回单个大文档。通过指定mode=”elements” 轻松保持这种分离。
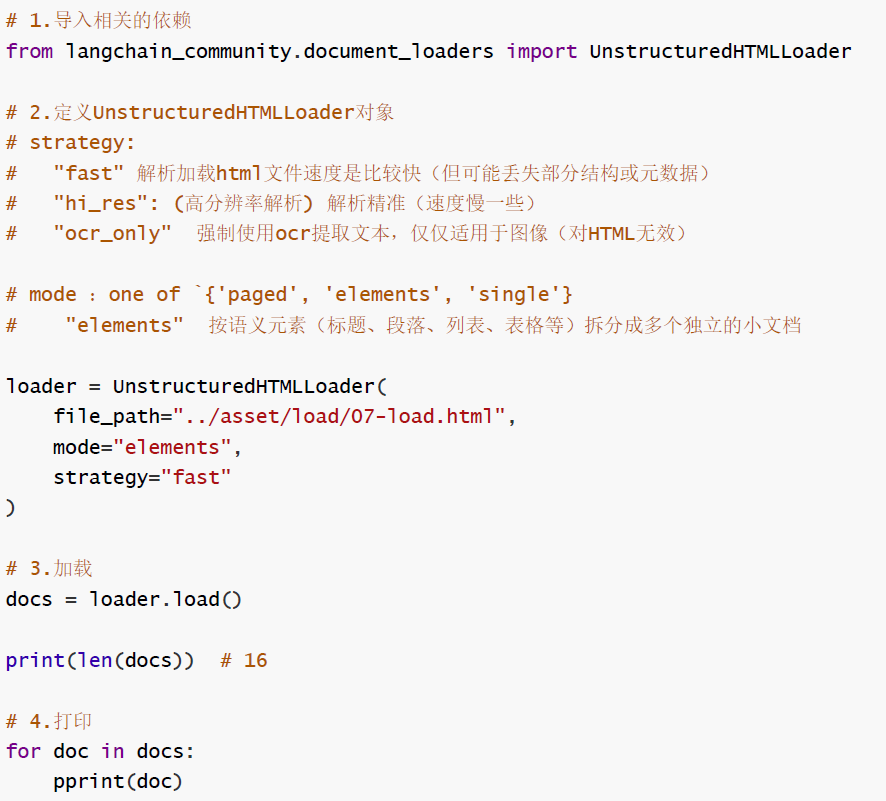
2.2.7 加载HTML
举例:
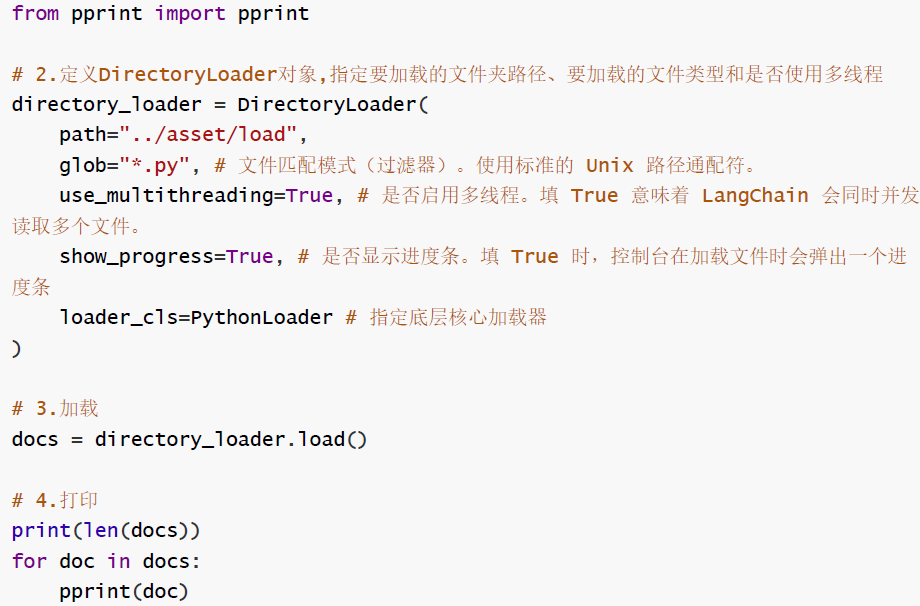
2.2.8 加载File Directory(了解)
除了上述的单个文件加载,我们也可以批量加载一个文件夹内的所有文件。
举例:
2.2.9 了解:BaseLoader、Document类
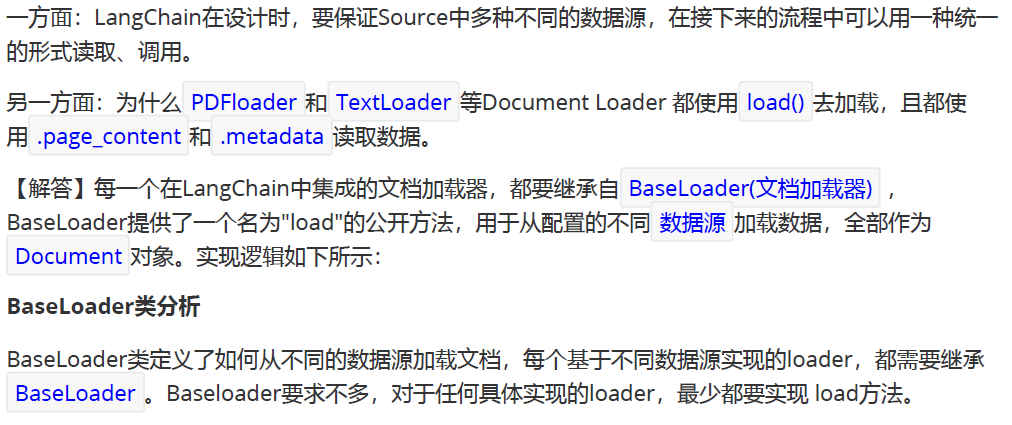
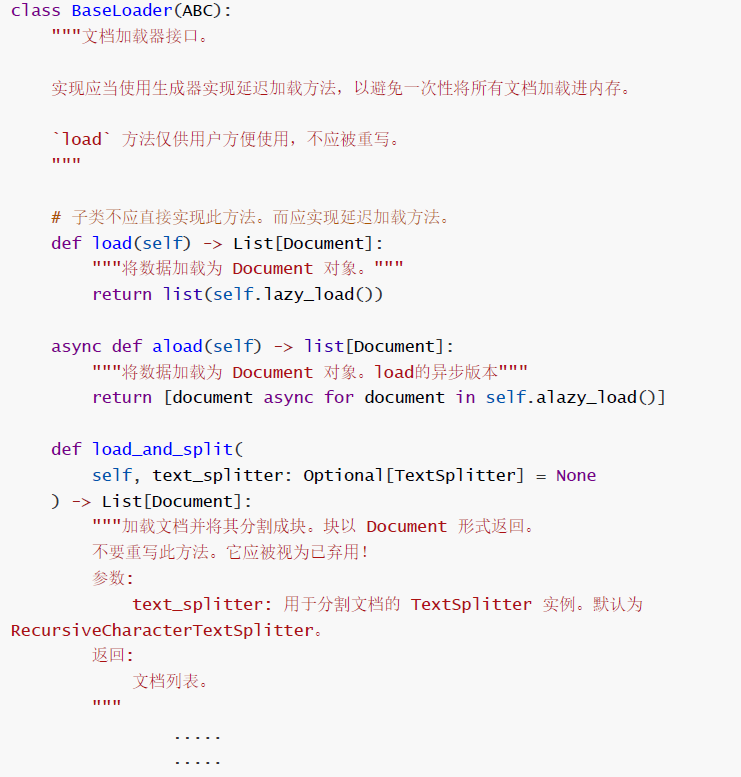
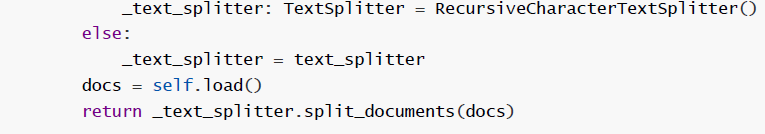
BaseLoader 把数据加载成Documents object ,存到 Documents 类中的page_content 中。
Document类分析
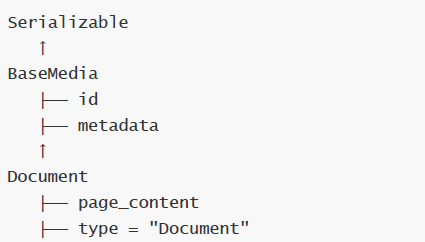
Document 允许用户与文档的内容进行交互,可以查看文档内容。
其继承体系如下











请登录后查看评论内容