本节你会学到什么
- 理解数学分析在数据分析和机器学习中的基础作用
- 知道导数、梯度和函数形状如何影响模型训练
- 建立从公式到代码再到模型调试的学习主线
学机器学习数学,都会有一个很真实的疑问:
我只是想做数据分析、跑模型、做项目,为什么一上来要学导数、梯度、Taylor 展开这些东西?
如果目标只是“把模型跑起来”,我们确实可以先不深究数学。
打开 scikit-learn,导入模型,调用 .fit(),很多任务都能跑出一个结果。但只要继续往前做,就会遇到更关键的问题:
- 模型为什么不收敛?
- loss 为什么忽上忽下?
- 学习率为什么调大一点就发散?
- 特征缩放为什么会影响训练速度?
- Logistic 回归为什么输出的是概率?
- 神经网络为什么要反向传播?
- PCA、SVM、正则化、Boosting 这些方法,背后到底在优化什么?
这些问题,光靠“会调包”就不够了。
我们得往模型里面多看一层:机器学习模型本质上是一类函数;训练模型本质上是在优化一个函数。
而数学分析,研究的正是函数如何变化、如何近似、如何达到最优。
这一节我们不急着推特别复杂的公式,先把学习机器学习数学时最重要的底层视角搭起来:
数学分析,帮助我们理解函数如何变化;
机器学习,很多时候就是利用这种“变化”来训练模型、解释模型、改进模型。
这条线打通了,后面学导数、梯度、Taylor 展开、凸函数,就不会像在背一堆孤立公式,而是在搭一套真正能用的模型理解工具。
1.1 数据驱动与模型驱动方法的融合
当一个产品经理问你:为什么我们某些用户看了商品却没下单?你能否建个模型找出原因?
这个问题很常见。电商转化、广告点击、推荐系统、风控审核,本质上都会遇到类似的问题:
我们手里有数据,也有业务经验,怎么把它们变成一个可训练、可解释、可优化的模型?
这时候,作为数据分析师或者数据科学家的你,通常会有两个思路:一个偏数据驱动,一个偏模型驱动。
1.1.1 数据驱动方法:从数据中寻找模式
也就是我们通常讲的统计学习 或机器学习 方法的思路。
比如我们先不急着写出“用户为什么下单”的完整机理,而是把用户行为数据整理出来:
- 是否点击商品;
- 是否加入购物车;
- 商品价格;
- 折扣力度;
- 用户年龄;
- 用户所在城市;
- 历史购买次数;
- 浏览时长;
- 页面停留时间。
然后我们建立模型,比如逻辑回归、决策树、随机森林、XGBoost,让模型从历史样本中学习:
什么样的用户更可能下单?
哪些特征和下单概率关系更强?
一个新用户来了,模型应该给出怎样的预测?
这叫做“从数据中学经验”,数据驱动。
从数学角度看,数据驱动方法常常可以写成:
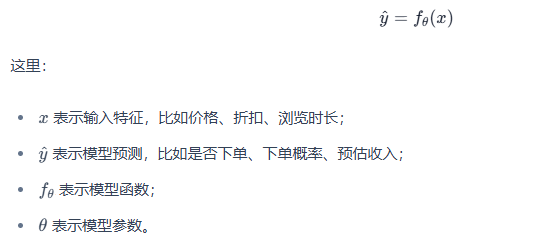
我们真正要做的,是从数据中学出一组合适的 θ,让模型预测更接近真实结果。
数据驱动方法的优点是:不需要一开始就把完整机制写死,模型表达能力强,能捕捉复杂模式。
但这里有一个容易踩坑的地方:不能简单说“数据驱动模型泛化能力一定强”。
更准确地说,数据驱动方法有机会学到复杂规律,但泛化能力取决于很多条件:
- 训练数据是否代表真实业务场景;
- 特征是否稳定、是否泄漏未来信息;
- 模型复杂度是否合适;
- 有没有做验证集、测试集评估;
- 有没有正则化、交叉验证、早停等约束手段。
所以我们可以这样理解:
数据驱动方法不是天然可靠,它需要数学、统计和工程流程一起托住。
这也是为什么我们后面要学习损失函数、梯度、过拟合、正则化和优化。模型不是跑出一个分数就结束了,我们还要知道这个分数为什么出现、能不能相信、换一批数据后表现是否仍然稳定。


请登录后查看评论内容