机器学习(Machine Learning, ML)主要研究计算机系统对于特定任务的性能,逐步进行改善的算法和统计模型。通过输入海量训练数据对模型进行训练,使模型掌握数据所蕴含的潜在规律,进而对新输入的数据进行准确的分类或预测。
机器学习是一门多领域交叉学科,涉及概率论、统计学、逼近论、凸优化、算法复杂度理论等多门学科。
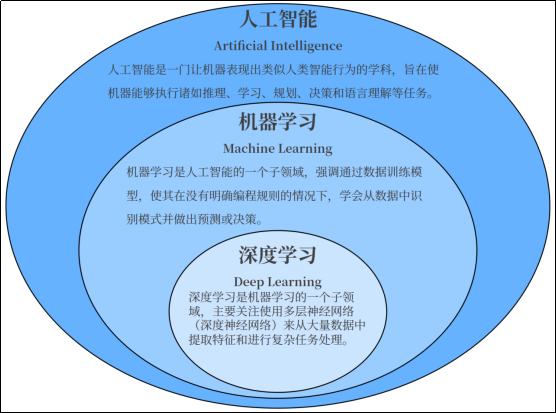
1.1 人工智能、机器学习与深度学习
- 人工智能(AI)是计算机科学的一个广泛领域,目标是让机器具备类人的“智能”,包括自然语言处理(NLP)、计算机视觉、机器人技术、专家系统等等;具体实现手段多种多样,包括规则系统、符号逻辑、统计方法、机器学习等。
- 机器学习是AI的一个子领域,核心是通过数据驱动,让计算机进行学习并改进性能,自动发现规律(模式),并利用这些规律进行预测或决策。
- 深度学习是机器学习的一个子领域,基于多层神经网络处理复杂任务。
1.2 发展历史
1.2.1 早期探索:20世纪50-70年代
人工智能研究处于“推理期”,人们认为只要能赋予机器逻辑推理能力,机器就能具有智能。
- 图灵提出“图灵测试”,定义机器智能的基本标准
- 弗兰克·罗森布拉特提出感知机算法,这是最早的人工神经网络模型之一,用于线性分类问题
- 亚瑟·李·塞谬尔提出“机器学习”一词,并设计了一个用于玩跳棋的学习算法
1.2.2 知识驱动与专家系统:20世纪70-80年代
随着研究推进,人们逐渐认识到,仅具有逻辑推理能力是远远实现不了人工智能的。部分人认为,要使机器具有智能,就必须设法使机器拥有知识。计算机硬件逐步发展,人工智能的研究进入以规则为主的“知识驱动”阶段。
- 出现众多专家系统,如MYCIN(用于医疗诊断)
- 引入了决策树(如ID3算法)
- 统计学习理论开始成形,例如贝叶斯定理在机器学习中的应用
1.2.3 数据驱动与统计学习:20世纪80年代-21世纪
专家系统面临“知识工程瓶颈”。机器学习成为一个独立的学科领域,各种机器学习技术百花初绽。基于神经网络的连接主义逐步发展,但其局限性也开始凸显。统计学习登场并占据主流,代表技术是支持向量机。互联网的发展带来了大量数据,统计学方法逐渐成为机器学习的核心。
- 决策树算法得到进一步发展(如C4.5算法)
- 支持向量机(SVM)被提出,成为一种强大的分类工具
- 无监督学习方法开始成熟,例如K-means聚类
- 随机森林和Boosting方法(如AdaBoost)引入,提升了集成学习的性能
1.2.4 深度学习崛起:21世纪初
随着计算能力(特别是GPU的发展)和数据规模的快速增长,深度学习技术得以崛起。深度神经网络主导,突破了图像、语音和文本领域的性能瓶颈。
- 深度信念网络(DBN)被提出,标志着深度学习研究的复兴
- AlexNet在ImageNet图像分类竞赛中获胜,证明了卷积神经网络(CNN)的强大性能
- 生成对抗网络(GAN)被提出,用于生成图像和其他生成任务
- Transformer架构在论文《Attention is All You Need》中提出,彻底改变了自然语言处理领域
1.2.5 大模型与通用人工智能:2020年代
深度学习进入规模化应用阶段,大语言模型和多模态模型的出现推动了机器学习的新高潮。模型参数规模空前,技术以通用性和泛化能力为目标。
- 自然语言处理:如OpenAI的GPT系列模型、Google的BERT
- 多模态模型:如OpenAI的CLIP、DeepMind的Gato
- 自监督学习成为重要方向,降低了对人工标注数据的依赖
- 强化学习和深度学习结合,应用于AlphaGo、AlphaFold等项目
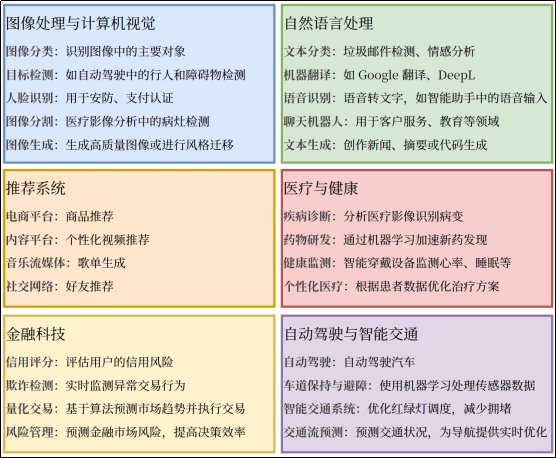
1.3 机器学习应用领域
今天,在计算机科学的诸多分支学科领域中,无论是多媒体、图形学,还是网络通信、软件工程,乃至体系结构、芯片设计,都能找到机器学习技术的身影,尤其是在计算机视觉、自然语言处理等计算机应用技术领域,机器学习已成为最重要的技术进步源泉之一,并为许多交叉学科提供了重要的技术支撑。
1.4 基本术语
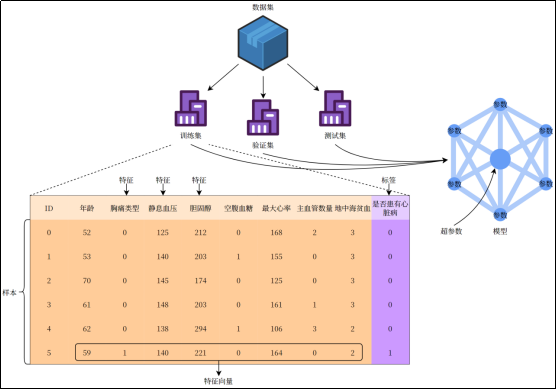
- 数据集(Data Set):多条记录的集合。
- 训练集(Training Set):用于训练模型的数据。
- 验证集(Validation Set):用于调节超参数的数据。
- 测试集(Test Set):用于评估模型性能的数据。
- 样本(Sample):数据集中的一条记录是关于一个事件或对象的描述,称为一个样本。
- 特征(Feature):数据集中一列反映事件或对象在某方面的表现或性质的事项,称为特征或属性。
- 特征向量(Feature Vector):将样本的所有特征表示为向量的形式,输入到模型中。
- 标签(Label):监督学习中每个样本的结果信息,也称作目标值(target)。
- 模型(Model):一个机器学习算法与训练后的参数集合,用于进行预测或分类。
- 参数(Parameter):模型通过训练学习到的值,例如线性回归中的权重和偏置。
- 超参数(Hyper Parameter):由用户设置的参数,不能通过训练自动学习,例如学习率、正则化系数等。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END


请登录后查看评论内容