

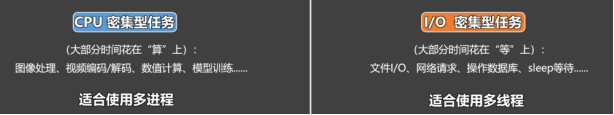
CPU密集型任务,更适合用多进程。
import time
from concurrent.futures import ProcessPoolExecutor, ThreadPoolExecutor

# 准备一个 CPU 密集型任务
def cpu_task(n):
    print(f'任务{n}开始了')
    total = 0
    for i in range(10000000):
        total += i * i
    return total

if __name__ == '_main_':
    print('===== 多进程完成【CPU密集型任务】=====')
    start = time.time()
    #开启四个进程进行计算
    with ProcessPoolExecutor(4) as executor:
        list(executor.map(cpu_task, [1, 2, 3, 4]))
    end = time.time() - start
    print(f'多进程总耗时:{end}秒')


    # print('===== 多线程完成【CPU密集型任务】=====')
    # start = time.time()
    # # 开启四个线程进行计算
    # with ThreadPoolExecutor(max_workers=4) as executor:
    #     results = list(executor.map(cpu_task, [1, 2, 3, 4]))
    # end = time.time() - start
    # print(f'多线程总耗时:{end}秒')
IO密集型任务,更适合用多线程。
import time
from concurrent.futures import ThreadPoolExecutor, ProcessPoolExecutor

# 拷贝文件
def copy_file(index):
    with open('a.zip', 'rb') as src, open(f'a_副本{index}.zip', 'wb') as dst:
        while True:
            data = src.read(1024 * 1024)  # 每次读 1MB
            if not data:
                break
            dst.write(data)

if __name__ == '__main__':
    # print('===== 使用多进程完成【IO密集型任务】 =====')
    # start = time.time()
    # with ProcessPoolExecutor(4) as executor:
    #     for i in range(4):
    #         executor.submit(copy_file, i)
    # end = time.time() - start
    # print(f'多进程耗时:{end} 秒')

    print('===== 使用多线程完成【IO密集型任务】 =====')
    start = time.time()
    with ThreadPoolExecutor(4) as executor:
        for i in range(4):
            executor.submit(copy_file, i)
    end = time.time() - start
    print(f'多线程耗时:{end} 秒')
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END











请登录后查看评论内容