

3.1 Pandas 简介
3.1.1 Pandas 是什么?
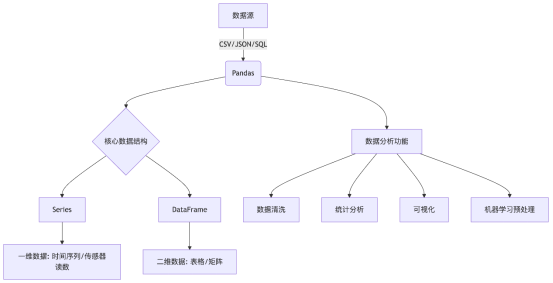
Pandas 是 Python 数据分析工具链中最核心的库,充当数据读取、清洗、分析、统计、输出的高效工具。
Pandas 是一个开源的数据分析和数据处理库,它是基于 Python 编程语言的。
Pandas 提供了易于使用的数据结构和数据分析工具,特别适用于处理结构化数据,如表格型数据(类似于Excel表格)。
Pandas 是数据科学和分析领域中常用的工具之一,它使得用户能够轻松地从各种数据源中导入数据,并对数据进行高效的操作和分析。
Pandas是基于NumPy构建的专门为处理表格和混杂数据设计的Python库,其核心设计理念包括:
- 标签化数据结构:提供带标签的轴(行索引和列名)
- 灵活处理缺失数据:内置NaN处理机制
- 智能数据对齐:自动按标签对齐数据
- 强大IO工具:支持从CSV、Excel、SQL等20+数据源读写
- 时间序列处理:原生支持日期时间处理和频率转换
名称由来
pandas这个名字源于panel data(面板数据,这是多维结构化数据集在计量经济学中的术语)以及Python data analysis(Python数据分析)。
pandas兼具numpy高性能的数组计算功能以及电子表格和关系型数据库(如SQL)灵活的数据处理功能。它提供了复杂精细的索引功能,能更加便捷地完成重塑、切片和切块、聚合以及选取数据子集等操作。
pandas功能:
- 有标签轴的数据结构
在数据结构中,每个轴都被赋予了特定的标签,这些标签用于标识和引用轴上的数据元素,使得数据的组织、访问和操作更加直观和方便
应用场景
| 工具 | 功能特色 | 适用场景 |
| Excel | 图形界面,简单上手 | 人工分析、小规模数据 |
| SQL | 高效读写,最终数据源 | 数据库查询和联表 |
| Python + Pandas | 算法和分析部署核心 | 数据清洗,统计分析,可视化等 |
- 与Excel对比:
- 优势:
- 处理百万级数据不卡顿(Excel约100万行限制)
- 可复用的分析流程(脚本 vs 手工操作)
- 支持复杂数据转换(如:分组聚合、时间重采样)
- 局限:
- 可视化交互性较弱
- 学习曲线较陡峭
- 与数据库对比:
- 优势:
- 无需SQL知识即可分析
- 适合探索性分析(即时反馈)
- 丰富的数据清洗函数
- 局限:
- 数据量受内存限制
- 不适合高并发访问
- 与纯Python代码对比:
- 优势:
- 向量化运算比for循环快10-100倍
- 内置统计分析方法(如:相关系数计算)
- 丰富的数据透视功能
- 局限:
- 需要额外学习Pandas API
行业洞见:根据2023年Kaggle调查,Pandas是数据科学家使用率最高的工具(占比93%),远超第二名Excel(占比32%)
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END











请登录后查看评论内容