

3.2.1 创建与访问
什么是Series
类似于 NumPy 一维数组,但增加了 “标签”,可以理解为「一维标签化数组」
Series 是 Pandas 中的一个核心数据结构,类似于一个一维的数组,具有数据和索引。
Series 可以存储任何数据类型(整数、浮点数、字符串等),并通过标签(索引)来访问元素。Series 的数据结构是非常有用的,因为它可以处理各种数据类型,同时保持了高效的数据操作能力,比如可以通过标签来快速访问和操作数据。
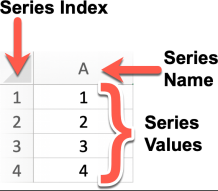
Series 特点:
- 一维数组:Series 中的每个元素都有一个对应的索引值。
- 索引: 每个数据元素都可以通过标签(索引)来访问,默认情况下索引是从 0 开始的整数,但你也可以自定义索引。
- 数据类型: Series 可以容纳不同数据类型的元素,包括整数、浮点数、字符串、Python 对象等。
- 大小不变性:Series 的大小在创建后是不变的,但可以通过某些操作(如 append 或 delete)来改变。
- 操作:Series 支持各种操作,如数学运算、统计分析、字符串处理等。
- 缺失数据:Series 可以包含缺失数据,Pandas 使用NaN(Not a Number)来表示缺失或无值。
- 自动对齐:当对多个 Series 进行运算时,Pandas 会自动根据索引对齐数据,这使得数据处理更加高效。
我们可以使用 Pandas 库来创建一个 Series 对象,并且可以为其指定索引(Index)、名称(Name)以及值(Values):
import pandas as pd
s = pd.Series([10, 20, 30], index=["a", "b", "c"])
创建Series
直接通过列表创建Series
import pandas as pd
s = pd.Series([4, 7, -5, 3])
print(s)
# 0    4
# 1    7
# 2   -5
# 3    3
# dtype: int64
Series的字符串表现形式为:索引在左边,值在右边。由于我们没有为数据指定索引,于是会自动创建一个0到N-1(N为数据的长度)的整数型索引。
通过列表创建Series时指定索引
s = pd.Series([4, 7, -5, 3], index=["a", "b", "c", "d"])
print(s)
# a    4
# b    7
# c   -5
# d    3
# dtype: int64
通过列表创建Series时指定索引和名称
s = pd.Series([4, 7, -5, 3], index=["a", "b", "c", "d"],name="hello_python")
print(s)
# a    4
# b    7
# c   -5
# d    3
# Name: hello_python, dtype: int6
名称的作用,与变量名的区别
在 Pandas 的 Series 中,name 参数用于给整个 Series 对象赋予一个名称。这个名称有以下几个用途:
1. 标识作用
- name 可以作为 Series 的标识,类似于给数据列取一个名字。
- 当你打印 Series 时,name 会显示在输出的最下方(如你的例子所示)。
2. DataFrame 列名
- 如果你将一个 Series 转换成 DataFrame 或与其他 DataFrame 合并,name 会自动成为列名。
- 例如:
df = s.to_frame()  # 转换为 DataFrame,列名就是 "hello_python"
print(df)
输出:
Plain Text
hello_python
a 4
b 7
c -5
d 3
3. 对齐操作
- 在 Pandas 运算(如 concat、merge 等)时,name 可以帮助对齐数据。
4. 导出数据
- 当你将 Series 导出为 CSV 或其他格式时,name 会成为列名。
name 的主要作用是 给 Series 一个标识,方便后续数据处理、合并或导出。如果只是单独使用 Series,name 可能看起来作用不大,但在更复杂的数据操作中(如 DataFrame 整合),它会很有用。
- 直接通过字典创建Series
dic = {"a": 4, "b": 7, "c": -5, "d": 3}
s = pd.Series(dic)
print(s)
# a    4
# b    7
# c   -5
# d    3
# dtype: int64
s1 = pd.Series(dic,index=["a","c"],name="aacc")
print(s1)
# a    4
# c   -5
# Name: aacc, dtype: int64访问Series数据
以下是 Pandas 中访问 Series 数据的主要方法汇总表格:
| 方法分类 | 语法示例 | 描述 | 返回值 | 是否支持切片/布尔索引 |
| 位置索引 | s.iloc[0] | 通过整数位置访问(从0开始) | 标量值 | 是 |
| s.iloc[1:3] | 位置切片(左闭右开) | Series | ||
| 标签索引 | s.loc[‘a’] | 通过索引标签访问 | 标量值 | 是 |
| s.loc[[‘a’,’b’]] | 通过标签列表访问 | Series | ||
| 直接索引 | s[0] | 类似iloc(当索引非整数时可能混淆) | 标量值/Series | 是 |
| s[‘a’] | 类似loc(优先标签索引) | |||
| 布尔索引 | s[s > 3] | 通过布尔条件筛选 | Series | 是 |
| s[~(s > 3)] | 取反条件 | |||
| 函数访问 | s.at[‘a’] | 快速访问单个标签(类似loc但效率更高) | 标量值 | 否 |
| s.iat[0] | 快速访问单个位置(类似iloc但效率更高) | |||
| 头部/尾部 | s.head(3) | 访问前N行(默认5) | Series | 否 |
| s.tail(2) | 访问后N行(默认5) | |||
| 取唯一值 | s.unique() | 返回唯一值数组 | ndarray | 否 |
| 值计数 | s.value_counts() | 统计各值出现次数 | Series |
- 优先使用**loc****/****iloc**:直接索引[]的行为可能因索引类型不同而变化,明确场景时建议显式使用loc(标签)或iloc(位置)。
- 切片差异:
- loc切片为闭区间(包含两端)
- iloc切片为左闭右开(与Python列表一致)
- 布尔索引:常用于条件过滤,如s[s > 3 & s < 10]。
s = pd.Series([10, 20, 30, 40], index=['a', 'b', 'c', 'd'])
# 位置索引
print(s.iloc[0])  # 10
# 标签访问
s["a"]
# 标签索引
print(s.loc['b'])  # 20
# 布尔索引
print(s[s > 25])  # c:30, d:40
# 花式索引
print(s[['a', 'c']])  # a:10, c:30

#使用布尔索引从Series中筛选满足某些条件的值
bools = s > s.mean()  # 将大于平均值的元素标记为 True
print(bools)
# a    False
# b     True
# c     True
# d    False
# dtype: bool
print(s[bools])
# b    3.5
# c    6.8
# dtype: float64
# 使用where过滤
print(s.where(s > 20, -1))  # 小于等于20的值替换为-1
Series的常用属性
| 属性 | 说明 |
| index | Series的索引对象 |
| values | Series的值 |
| dtype或dtypes | Series的元素类型 |
| shape | Series的形状 |
| ndim | Series的维度 |
| size | Series的元素个数 |
| name | Series的名称 |
| loc[] | 显式索引,按标签索引或切片 |
| iloc[] | 隐式索引,按位置索引或切片 |
| at[] | 使用标签访问单个元素 |
| iat[] | 使用位置访问单个元素 |
import pandas as pd
arrs = pd.Series([11,22,33,44,55],name="atguigu",index=["a","b","c","d","e"])
# print(arrs)
# index Series的索引对象
print(arrs.index)
for i in arrs.index:
    print(i)
print(arrs.values) # values    Series的值
print(arrs.ndim)  # ndim  Series的维度
print(arrs.shape)  # shape Series的形状
print(arrs.size) # size  Series的元素个数
# dtype或dtypes  Series的元素类型
print(arrs.dtype)
print(arrs.dtypes)
# name  Series的名称
print(arrs.name)
# loc[] 显式索引,按标签索引或切片
print(arrs.loc["c"])
print(arrs.loc["c":"d"])
# iloc[]    隐式索引,按位置索引或切片
print(arrs.iloc[0])
print(arrs.iloc[0:3])
# at[]  使用标签访问单个元素
print(arrs.at["a"])
# iat[] 使用位置访问单个元素
print(arrs.iat[3])










请登录后查看评论内容