

| 分类 | 依赖关系 | 协同应用场景 | 示例 |
| 描述性统计 | 所有分析的基础 | 初步了解数据分布,指导后续分组策略 | df.describe() 发现某列标准差大 → 触发分组过滤 |
| 分组聚合 | 基于描述性统计或分组过滤结果 | 按维度拆分后计算指标(如各品类销售额总和) | df.groupby(‘category’)[‘sales’].sum() |
| 分组转换 | 依赖分组聚合结构 | 在保留原始行数的前提下,添加组内计算列(如标准化、排名) | df.groupby(‘group’)[‘value’].transform(lambda x: x/x.max()) |
| 分组过滤 | 依赖描述性统计或分组聚合结果 | 根据组级条件筛选数据(如剔除样本量不足的组) | df.groupby(‘group’).filter(lambda x: len(x) > 5) |
| 相关性分析 | 可结合分组聚合结果 | 分析不同分组下变量的关联性(如各地区的价格-销量相关性) | df.groupby(‘region’)[[‘price’,’sales’]].corr() |
关键交互逻辑
- 从宏观到微观
- 描述性统计(宏观) → 分组聚合(细分维度) → 分组转换/过滤(微观调整)
- 数据流闭环
# 示例:分析高波动品类(闭环流程)
grouped = df.groupby('category')
# 1. 描述性统计 → 2. 分组过滤 → 3. 分组转换
result = (grouped.filter(lambda x: x['price'].std() > 2)
          .groupby('category')['price']
.transform(lambda x: (x - x.mean())/x.std()))- 功能互补性
- 聚合 vs 转换:聚合减少行数,转换保持行数。
- 过滤 vs 转*:过滤删除整组,转换修改组内值。
可视化应用场景
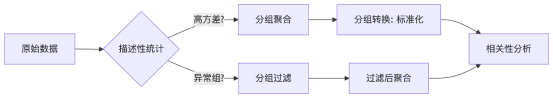
通过以上关系图和表格,可清晰理解如何组合这些方法解决实际问题,例如:
- 数据清洗:描述统计 → 发现异常 → 分组过滤
- 特征工程:分组聚合 → 分组转换(如生成占比特征)
- 业务分析:分组聚合 → 相关性分析(如用户分群行为关联)
1. 常用聚合函数
| 方法 | 说明 |
| sum() | 求和 |
| mean() | 平均值 |
| min() | 最小值 |
| max() | 最大值 |
| var() | 方差 |
| std() | 标准差 |
| median() | 中位数 |
| quantile() | 指定位置的分位数,如quantile(0.5) |
| describe() | 常见统计信息 |
| size() | 所有元素的个数 |
| count() | 非空元素的个数 |
| first | 第一行 |
| last | 最后一行 |
| nth | 第n行 |
2. 分组聚合
df.groupby("分组字段")["要聚合的字段"].聚合函数()
df.groupby(["分组字段", "分组字段2", ...])[["要聚合的字段", "要聚合的字段2", ...]].聚合函数()DataFrameGroupBy对象
对DataFrame对象调用groupby()方法后,会返回DataFrameGroupBy对象。
df = pd.read_csv("data/employees.csv")  # 读取员工数据
print(df.groupby("department_id"))  # 按department_id分组,返回DataFrameGroupBy对象
# <pandas.core.groupby.generic.DataFrameGroupBy object at 0x0000024FCBAFD700>
这个对象可以看成是一种特殊形式的 DataFrame,里面隐藏着若干组数据,但是在没有应用累计函数之前不会计算。GroupBy对象是一种非常灵活的抽象类型。在大多数场景中,可以将它看成是DataFrame的集合。
查看分组
通过groups属性查看分组结果,返回一个字典,字典的键是分组的标签,值是属于该组的所有索引的列表。
print(df.groupby("department_id").groups)  # 查看分组结果
# {10.0: [100], 20.0: [101, 102], 30.0: [14, 15, 16, 17, 18, 19]...
通过get_group()方法获取分组。
print(df.groupby("department_id").get_group(50))  # 获取分组为50的数据
#     employee_id first_name    last_name     email...
# 20          120    Matthew        Weiss    MWEISS...
# 21          121       Adam        Fripp    AFRIPP...
# 22          122      Payam     Kaufling  PKAUFLIN...
按列取值
print(df.groupby("department_id")["salary"])  # 按department_id分组,取salary列
# <pandas.core.groupby.generic.SeriesGroupBy object at 0x0000022456D6F2F0>
这里从原来的DataFrame中取某个列名作为一个Series组。与GroupBy对象一样,直到我们运行累计函数,才会开始计算。
print(df.groupby("department_id")["salary"].mean())  # 计算每个部门平均薪资
# department_id
# 10.0      4400.000000
# 20.0      9500.000000
# 30.0      4150.000000
按组迭代
GroupBy对象支持直接按组进行迭代,返回的每一组都是Series或DataFrame。
for dept_id,group in df.groupby("department_id"):
    print(f"当前组为{dept_id},组里的数据情况{group.shape}:")
    print(group.iloc[:,0:3])
    print("-------------------")
# 当前组为10.0,组里的数据情况(1, 10):
#      employee_id first_name last_name
# 100          200   Jennifer    Whalen
# -------------------
# 当前组为20.0,组里的数据情况(2, 10):
#      employee_id first_name  last_name
# 101          201    Michael  Hartstein
# 102          202        Pat        Fay
按多字段分组
salary_mean = df.groupby(["department_id", "job_id"])[
   ["salary", "commission_pct"]
].mean()  # 按department_id和job_id分组
print(salary_mean.index)  # 查看分组后的索引
# MultiIndex([( 10.0,    'AD_ASST'),
#             ( 20.0,     'MK_MAN'),
#             ( 20.0,     'MK_REP'),
#             ( 30.0,   'PU_CLERK'),
#             ( 30.0,     'PU_MAN'),
#             ...
print(salary_mean.columns)  # 查看分组后的列
# Index(['salary', 'commission_pct'], dtype='object')
按多个字段分组后得到的索引为复合索引。
可通过reset_index()方法重置索引。
print(salary_mean.reset_index())
#     department_id      job_id        salary  commission_pct
# 0            10.0     AD_ASST   4400.000000             NaN
# 1            20.0      MK_MAN  13000.000000             NaN
# 2            20.0      MK_REP   6000.000000             NaN
# 3            30.0    PU_CLERK   2780.000000             NaN
# 4            30.0      PU_MAN  11000.000000             NaN
也可以在分组的时候通过as_index = False参数(默认是True)重置索引。
salary_mean = df.groupby(["department_id", "job_id"], as_index=False)[
    ["salary", "commission_pct"]
].mean()  # 按department_id和job_id分组
print(salary_mean)
#     department_id      job_id        salary  commission_pct
# 0            10.0     AD_ASST   4400.000000             NaN
# 1            20.0      MK_MAN  13000.000000             NaN
# 2            20.0      MK_REP   6000.000000             NaN
# 3            30.0    PU_CLERK   2780.000000             NaN
# 4            30.0      PU_MAN  11000.000000             NaN
将数据按月分组,并统计最大温度和最小温度的平均值
df["month"] = pd.to_datetime(df["date"]).dt.to_period("M").astype(str)  # 将date转换为 年-月 的格式

df_groupby_date = df.groupby("month")  # 按month分组,返回一个分组对象(DataFrameGroupBy)
month_temp = df_groupby_date[["temp_max", "temp_min"]]  # 从分组对象中选择特定的列
month_temp_mean = month_temp.mean()  # 对每个列求平均值

# 以上代码可以写在一起
month_temp_mean = df.groupby("month")[["temp_max", "temp_min"]].mean()
#           temp_max   temp_min
# month
# 2012-01   7.054839   1.541935
# 2012-02   9.275862   3.203448
# 2012-03   9.554839   2.838710
# 2012-04  14.873333   5.993333
# 2012-05  17.661290   8.190323
分组后默认会将分组字段作为行索引。如果分组字段有多个,得到的是复合索引。
分组频数计算
统计每个月不同天气状况的数量。
df.groupby("month")["weather"].nunique()
# date
# 2012-01    4
# 2012-02    4
# 2012-03    4
# 2012-04    4
# 2012-05    3
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END











请登录后查看评论内容