

1. 目标定义和假设设定
1.1 背景介绍
房价预测是房地产行业的重要任务,准确的房价估计可以帮助买家、卖家、投资者和金融机构做出合理决策。
本案例基于 Kaggle 数据集 House Prices: Advanced Regression Techniques,主要涉及影响房价的各类因素,如房屋结构、地理位置、建筑年份、面积、装修质量等。
1.2 数据分析目标
本案例的主要目标是 进行房价数据清洗与基础统计分析,以便后续建模和预测房价。
具体目标包括:
- 数据理解与探索:分析数据集的特征,检查数据的完整性和分布情况。
- 数据清洗:处理缺失值、异常值和数据类型问题,确保数据质量。
- 特征分析:分析不同特征对房价的影响,进行可视化展示。
- 基础统计分析:计算各个特征的描述性统计信息,观察数据的总体趋势。
1.3 业务需求
- 买家视角:希望了解哪些因素对房价影响最大,以帮助决策。
- 卖家视角:希望找到影响房屋售价的关键因素,以合理定价。
- 房地产投资者:希望通过数据分析找到潜在投资机会。
1.4 关键假设设定
我们提出以下假设,并将在后续分析中进行验证:
- 房屋面积(GrLivArea、TotalBsmtSF)对房价有显著影响。
- 建筑质量(OverallQual)是决定房价的关键因素之一。
- 地理位置(Neighborhood)影响房价,即不同社区的房价存在显著差异。
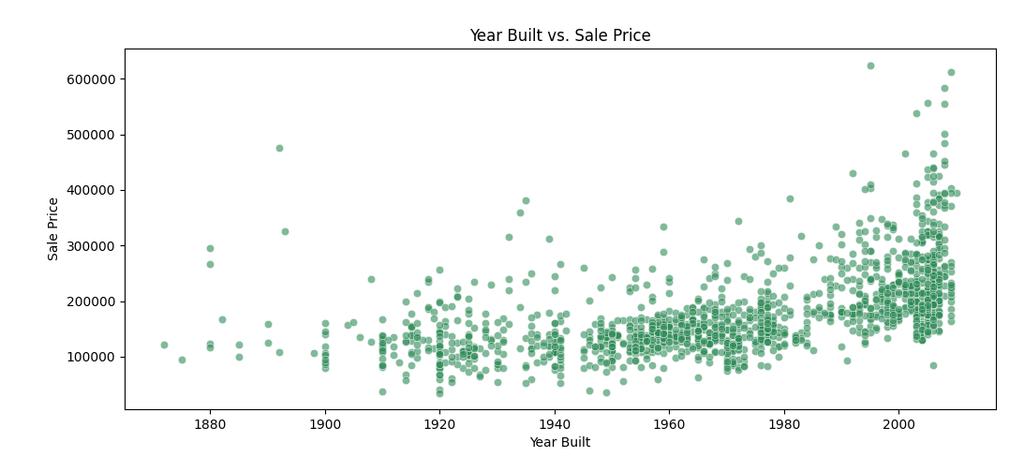
- 房龄(YearBuilt、YearRemodAdd)较新的房屋售价较高。
- 配套设施(GarageCars、Fireplaces、WoodDeckSF 等)可能对房价有正向影响。
2. 数据探索
在这一部分,我们将对数据进行深入探索,并执行 缺失值处理、异常值检测、数据分布分析,确保数据质量。
使用 matplotlib 和 seaborn 进行可视化,以直观展示数据趋势和分布情况。
2.1 加载数据 & 基本信息
首先,我们加载数据并查看基本信息,包括数据类型、缺失值、数值范围等。
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns

# 读取数据
file_path = "./dataset/003/house-prices-advanced-regression-techniques/train.csv"
df = pd.read_csv(file_path)

# 显示数据基本信息
print("数据集基本信息:")
print(df.info())

# 显示数据的前5行
print("数据样例:")
print(df.head())

# 统计描述性信息
print("数据描述性统计信息:")
print(df.describe())
2.2 处理缺失值
2.2.1 缺失值统计
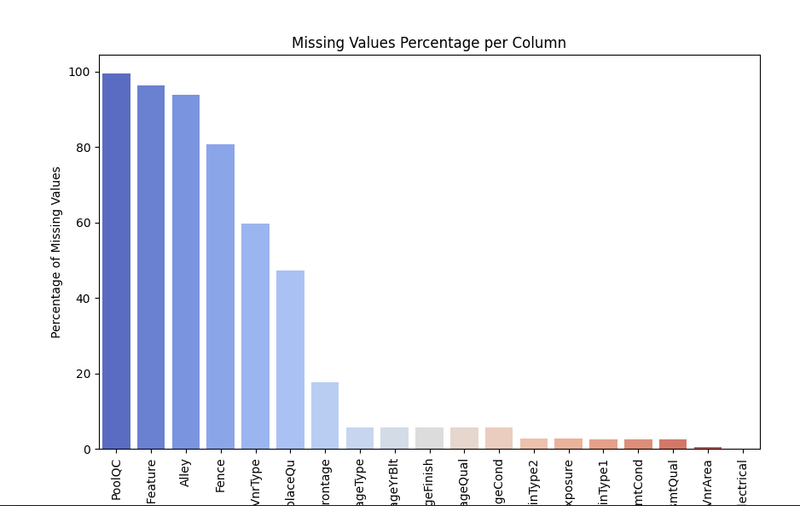
计算各列缺失值数量,并绘制缺失值占比图。
# 计算缺失值数量和占比
missing_values = df.isnull().sum()
missing_percent = (missing_values / len(df)) * 100

# 只显示有缺失值的列
missing_data = pd.DataFrame({'Missing Values': missing_values, 'Percentage': missing_percent})
missing_data = missing_data[missing_data['Missing Values'] > 0].sort_values(by='Percentage', ascending=False)

# 绘制缺失值可视化
plt.figure(figsize=(10, 6))
sns.barplot(x=missing_data.index, y=missing_data['Percentage'], palette="coolwarm")
plt.xticks(rotation=90)
plt.ylabel("Percentage of Missing Values")
plt.title("Missing Values Percentage per Column")
plt.show()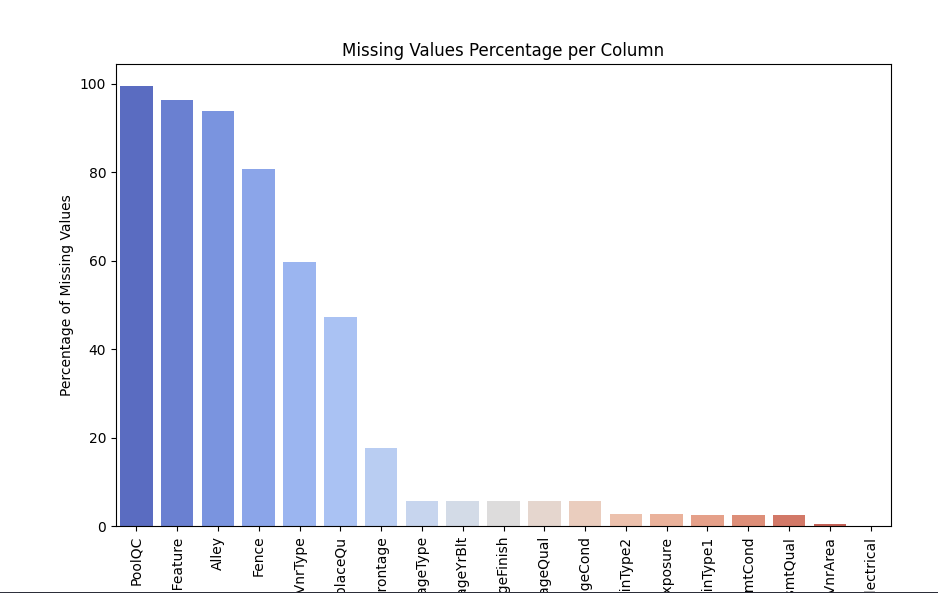
2.2.2 处理缺失值
- 数值型特征(如
LotFrontage、GarageYrBlt)用中位数填充。 - 类别型特征(如
Alley、PoolQC)用“None”(表示无该特征)填充。
# 数值型特征:用中位数填充
num_features = df.select_dtypes(include=['number']).columns
for col in num_features:
    df[col].fillna(df[col].median(), inplace=True)

# 类别型特征:用 "None" 填充
cat_features = df.select_dtypes(include=['object']).columns
for col in cat_features:
    df[col].fillna("None", inplace=True)

# 确保无缺失值
print("缺失值处理后:")
print(df.isnull().sum().sum())  # 应该输出 0
2.3 处理异常值
2.3.1 检查极大值、极小值
使用 箱线图(Boxplot) 检测异常值,并进行可视化。
# 选取数值型变量
numeric_columns = ['SalePrice', 'GrLivArea', 'TotalBsmtSF', 'LotArea']

# 绘制箱线图
plt.figure(figsize=(15, 6))
for i, col in enumerate(numeric_columns, 1):
    plt.subplot(1, 4, i)
    sns.boxplot(y=df[col], palette="coolwarm")
    plt.title(f"Boxplot of {col}")
plt.tight_layout()
plt.show()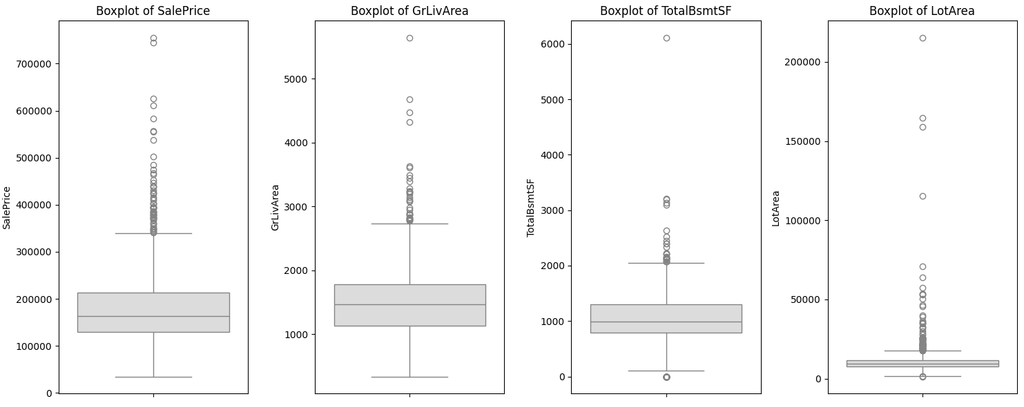
2.3.2 处理异常值
GrLivArea:去除房屋面积过大的异常值(大于 4000 平方英尺)。LotArea:去除极端值(> 100000 平方英尺)。
# 删除异常值
df = df[df['GrLivArea'] < 4000]
df = df[df['LotArea'] < 100000]

# 重新绘制箱线图,检查异常值处理效果
plt.figure(figsize=(15, 6))
for i, col in enumerate(numeric_columns, 1):
    plt.subplot(1, 4, i)
    sns.boxplot(y=df[col], palette="coolwarm")
    plt.title(f"Boxplot of {col} after Cleaning")
plt.tight_layout()
plt.show()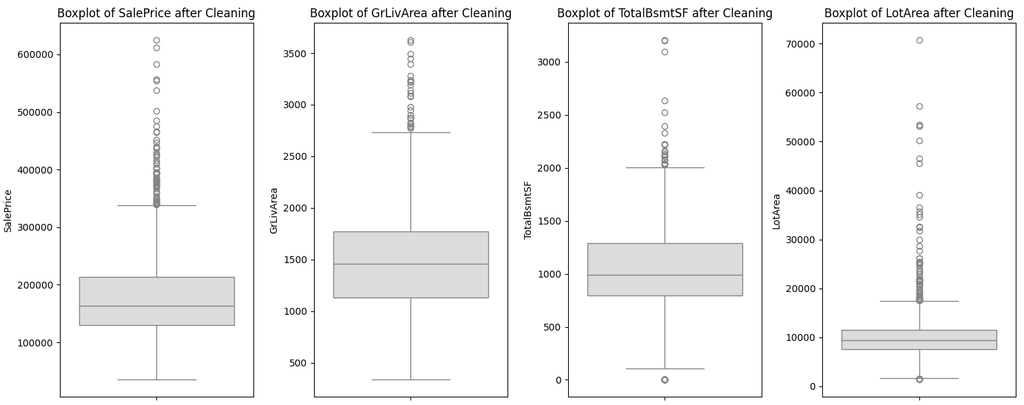
2.4 数据分布 & 相关性分析
2.4.1 目标变量 SalePrice 分布
我们绘制房价的 直方图 及核密度曲线(KDE)。
plt.figure(figsize=(10, 5))
sns.histplot(df['SalePrice'], bins=50, kde=True, color='royalblue')
plt.xlabel("Sale Price")
plt.ylabel("Frequency")
plt.title("Distribution of Sale Prices")
plt.show()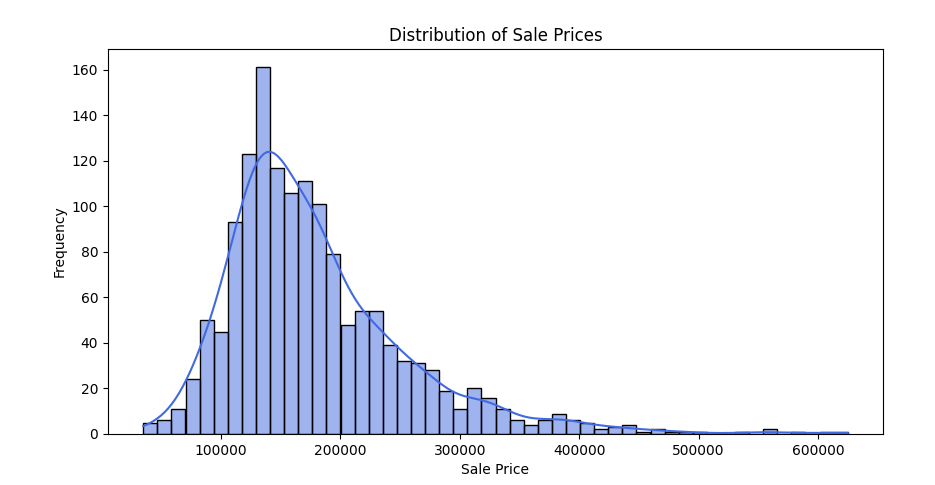
2.4.2 变量相关性
计算 特征与房价的相关性,并绘制热图(Heatmap)。
# 只选择数值型特征进行相关性计算
numeric_df = df.select_dtypes(include=['number'])

# 计算相关性矩阵
correlation_matrix = numeric_df.corr()

# 选择与 SalePrice 相关性最高的前10个特征
top_corr_features = correlation_matrix['SalePrice'].abs().sort_values(ascending=False)[1:11]

# 绘制热力图
plt.figure(figsize=(10, 6))
sns.heatmap(numeric_df[top_corr_features.index].corr(), annot=True, cmap='coolwarm', fmt=".2f")
plt.title("Top 10 Feature Correlations with Sale Price")
plt.show()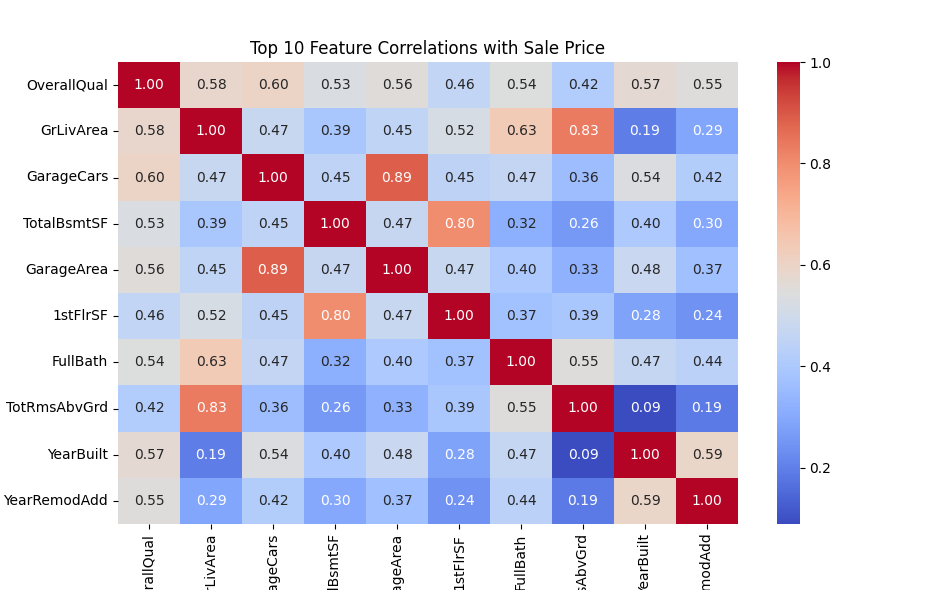
2.5 关键特征分析
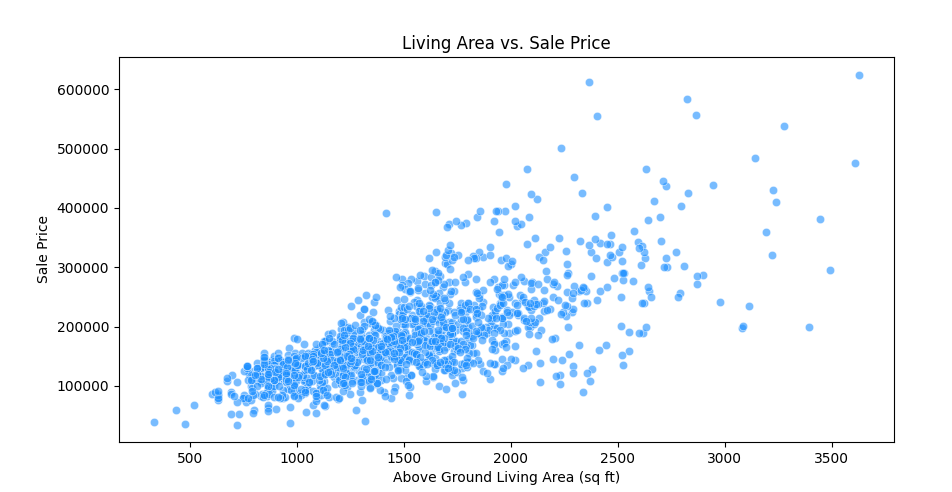
2.5.1 生活面积(GrLivArea) vs. 房价
2.5.2 建筑质量(OverallQual) vs. 房价
plt.figure(figsize=(10, 5))
sns.boxplot(x=df['OverallQual'], y=df['SalePrice'], palette="coolwarm")
plt.xlabel("Overall Quality")
plt.ylabel("Sale Price")
plt.title("Overall Quality vs. Sale Price")
plt.show()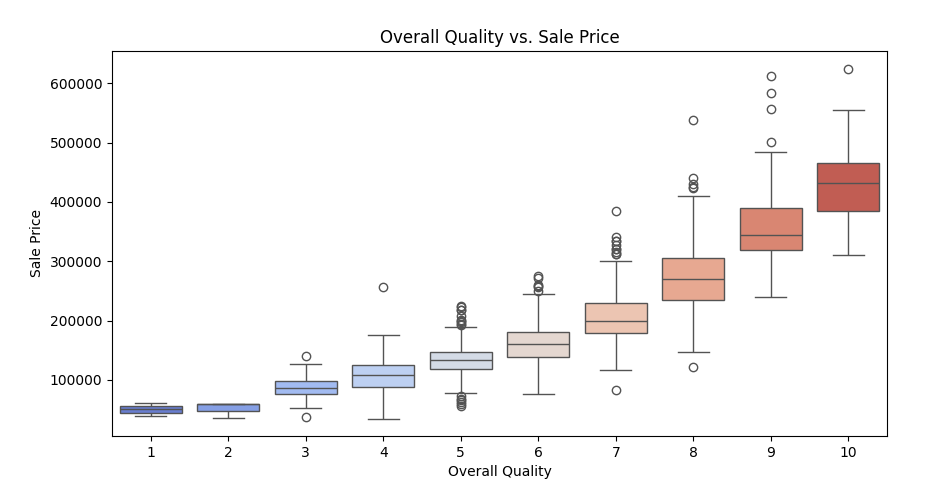
2.5.3 建造年份(YearBuilt) vs. 房价
2.6 处理重复数据
# 统计重复行数
duplicate_count = df.duplicated().sum()
print(f"重复行数: {duplicate_count}")

# 删除重复行
df = df.drop_duplicates()

# 再次检查重复数据
print(f"去重后重复行数: {df.duplicated().sum()}")
2.7 处理 inf 和 NaN
# 替换 inf 和 NaN
df.replace([np.inf, -np.inf], np.nan, inplace=True)
df.fillna(df.median(), inplace=True)
2.8 小结
- 缺失值处理:数值型变量用中位数填充,类别型变量用“None” 填充。
- 异常值处理:去除极端房屋面积(>4000) 和土地面积(>100000) 的数据点。
- 房价分布分析:房价呈右偏态分布,可能需要对数变换。
- 变量相关性:
- 房屋面积(GrLivArea) 与房价高度相关。
- 建筑质量(OverallQual) 是房价的重要决定因素。
- 房龄(YearBuilt) 越新,房价通常越高。
- 去重 & 清理
inf/NaN:确保数据干净无误。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END












请登录后查看评论内容