

1. 目标定义和假设设定
1.1 案例名称
房价数据清洗与基础统计分析
1.2 数据集
Kaggle 上的Bank Customer Churn Prediction 数据集。
1.3 分析背景与业务需求:
在本案例中,我们的任务是利用客户数据进行分析,探索可能影响银行客户流失(Churn)的因素。客户流失率是银行等金融机构非常关注的一个指标,客户的流失意味着银行可能失去未来的收入。因此,识别影响客户流失的关键因素对制定保留客户的策略具有重要意义。
业务需求:通过清洗和分析客户数据,找出哪些因素对客户流失具有显著影响,进而帮助银行制定有效的客户管理策略,降低客户流失率,提升盈利能力。
1.4 数据分析目标
- 数据清洗:处理缺失值、重复值以及不合理数据,确保数据质量。
- 基础统计分析:通过描述性统计和可视化,理解数据的分布和特征。
- 客户流失的关键因素分析:分析影响客户流失(变量
Exited)的主要因素,例如客户的年龄、信用评分、账户余额等。 - 业务洞察:根据分析结果,提出降低客户流失率的业务建议。
1.5 假设设定
- 假设 1:年龄较大的客户更容易流失。
- 假设 2:信用评分较低的客户流失率较高。
- 假设 3:拥有多个银行产品(如信用卡、贷款等)的客户流失率较低。
- 假设 4:余额较高的客户流失率较低。
- 假设 5:活跃用户(
IsActiveMember为1)的流失率低于非活跃用户。
这些假设将在后续数据分析中通过统计验证,帮助确定影响客户流失的关键因素。
2. 数据探索
在这一阶段,我们将对数据进行探索性分析,了解数据的基本特征,处理缺失值、异常值、重复数据,并确保数据质量。此外,我们会使用可视化手段展示数据的分布和趋势。
2.1 读取数据并检查基本信息
首先,导入必要的库并读取数据,查看数据类型、维度等基本信息。
# 导入必要的库
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns

# 读取数据集
file_path = './dataset/004/Churn_Modelling.csv'
df = pd.read_csv(file_path)

# 查看数据的基本信息
print(df.info())  # 显示数据的列信息和数据类型
print(df.describe())  # 显示数值型列的统计信息
print(df.head())  # 显示前几行数据,检查数据读取是否正常
2.2 检查缺失值、重复值、异常值等
在数据分析之前,处理缺失值、重复值以及检测异常数据是非常重要的步骤。
首先我们检查数据是否有缺失值或重复值。
# 检查是否存在缺失值
print(df.isnull().sum())  # 输出每列缺失值的数量

# 检查是否有重复值
print(f"重复值数量: {df.duplicated().sum()}")  # 查看重复值的数量

# 删除重复值(如果有的话)
df.drop_duplicates(inplace=True)
2.3 处理异常值和极值
通过可视化和统计方法检查数值列中的极大值和极小值,确保没有异常的极端数据点。
例如,可以绘制箱线图来观察CreditScore、Age、Balance等列的分布,检测是否有离群值。
# 绘制数值列的箱线图,检查异常值
plt.figure(figsize=(12, 6))
sns.boxplot(data=df[['CreditScore', 'Age', 'Balance', 'EstimatedSalary']])
plt.title('Boxplot of Numeric Columns')
plt.show()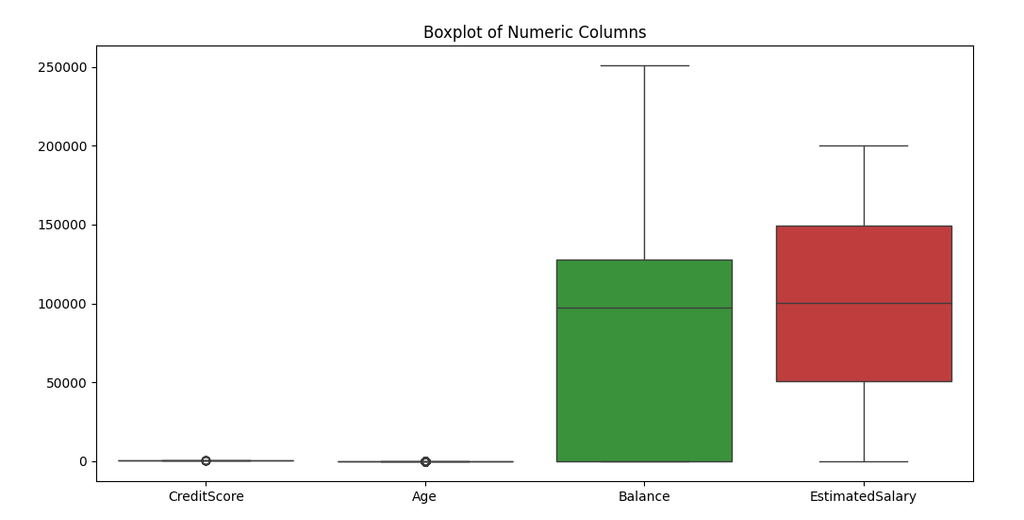
2.4 处理异常值
可以根据业务逻辑对异常值进行处理,如对于年龄值的极端异常,可以设置合理的范围(如年龄大于18岁,小于100岁),并过滤掉异常值。
# 过滤年龄在合理范围之外的异常值
df = df[(df['Age'] > 18) & (df['Age'] < 100)]

# 对其他列也可以根据业务逻辑进行处理,如余额
df = df[df['Balance'] >= 0]
2.5 检查数据的分布和相关性
接下来,我们使用直方图、散点图等方法检查数据的分布,观察各特征的趋势。
# 设置图形风格
sns.set(style='whitegrid', palette='bright')

# 绘制数值列的直方图
df[['CreditScore', 'Age', 'Balance', 'EstimatedSalary']].hist(bins=20, figsize=(12, 8), color='skyblue')
plt.suptitle('Histograms of Numeric Columns', fontsize=16)
plt.show()

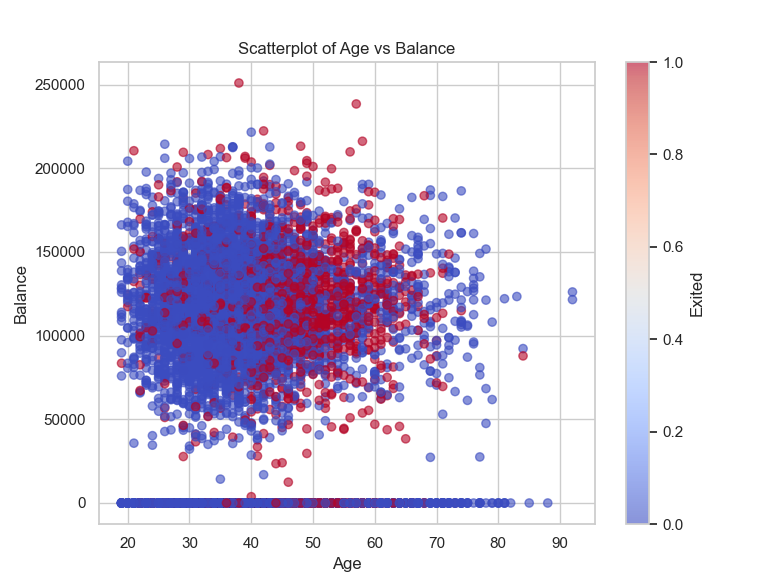
# 绘制客户年龄和账户余额的散点图,观察数据分布趋势
plt.figure(figsize=(8, 6))
plt.scatter(df['Age'], df['Balance'], alpha=0.6, c=df['Exited'], cmap='coolwarm')
plt.title('Scatterplot of Age vs Balance')
plt.xlabel('Age')
plt.ylabel('Balance')
plt.colorbar(label='Exited')
plt.show()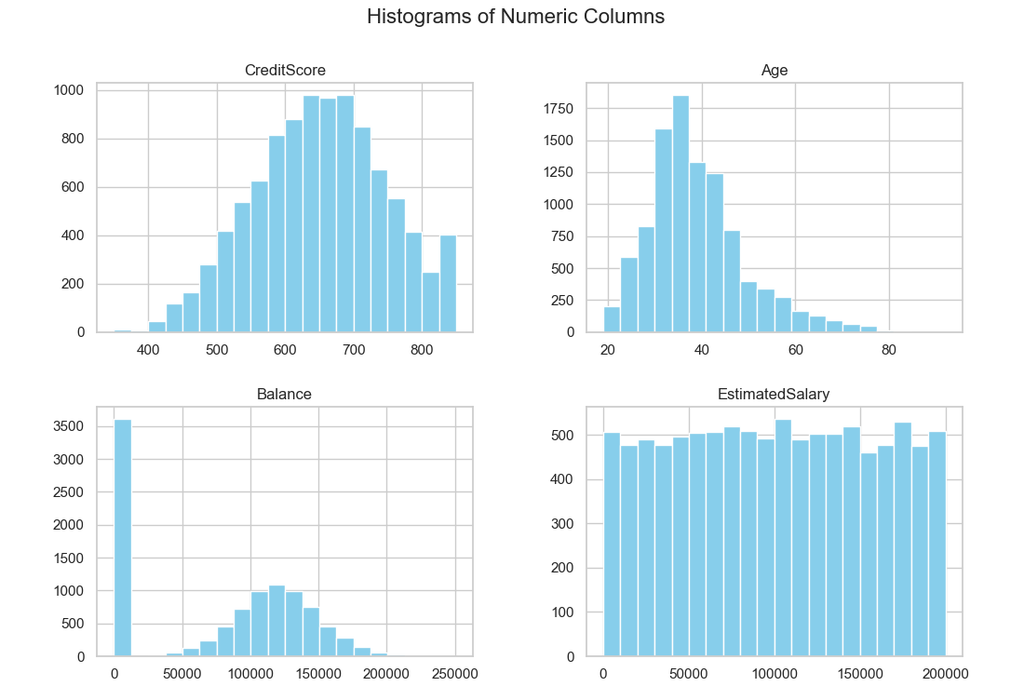
2.6 检查特征之间的相关性
通过相关矩阵和热图来检查特征之间的相关性,尤其是与目标变量Exited之间的关系。
# 只选择数值型特征进行相关性计算
numeric_df = df.select_dtypes(include=['number'])

# 计算相关性矩阵
corr_matrix = numeric_df.corr()

# 绘制热图展示相关性
plt.figure(figsize=(10, 8))
sns.heatmap(corr_matrix, annot=True, cmap='coolwarm', fmt='.2f', linewidths=0.5)
plt.title('Correlation Matrix')
plt.show()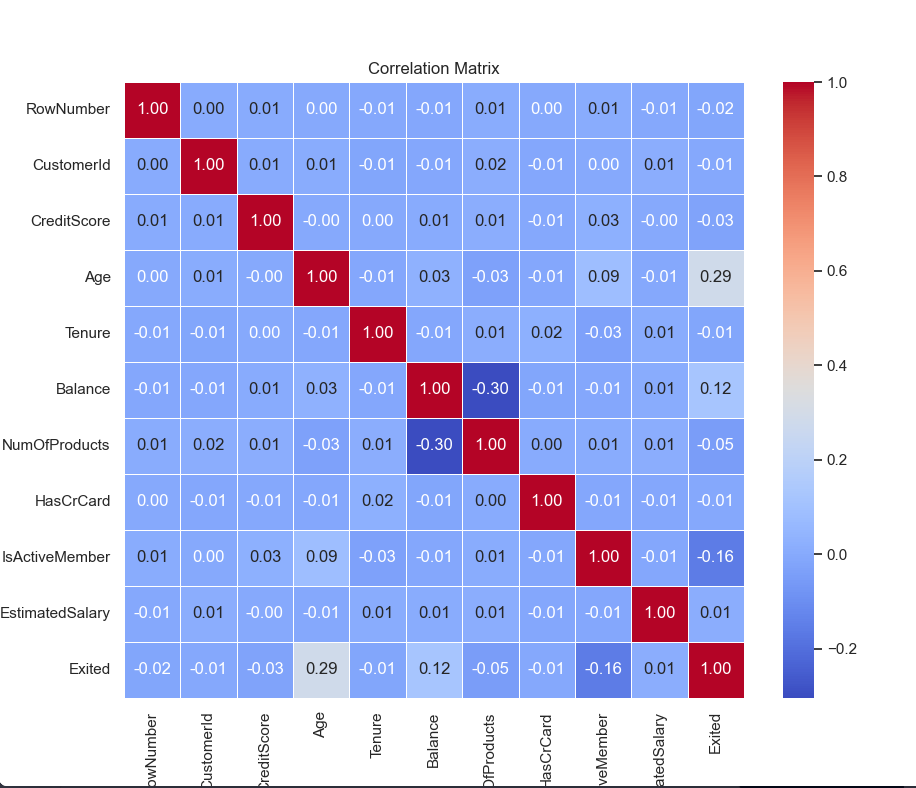
2.7 数据清洗结果与数据集的最终检查
最后,检查处理完毕的数据集是否存在任何质量问题,并进行数据保存。
# 最终检查是否还有缺失值和重复值
print(f"最终缺失值数量: {df.isnull().sum().sum()}")
print(f"最终重复值数量: {df.duplicated().sum()}")

# 保存清洗后的数据
df.to_csv('./dataset/004/Churn_Modelling_cleaned.csv', index=False)
2.8 小结
- 数据清洗:经过缺失值、重复值和异常值的检查和处理,确保了数据质量。我们删除了重复值,过滤了不合理的年龄值和余额值。
- 数据分布和趋势:通过直方图、箱线图和散点图,展示了数值型特征如信用评分、年龄、余额等的分布和趋势,观察到年龄和余额等特征可能对客户流失有一定影响。
- 相关性分析:通过热图,我们看到了特征之间的相关性,为后续的进一步分析和建模提供了参考。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END












请登录后查看评论内容