

1. 目标定义和假设设定
1.1 分析目标
本案例的目标是 对购物中心的客户进行聚类分析,以便根据其消费行为进行分群。
这有助于商家了解不同类型的客户,从而制定更精准的营销策略,提高客户满意度和销售额。
1.2 业务背景
购物中心希望通过对客户的年龄、年收入和消费评分等数据进行分析,识别出不同消费行为的群体。例如,可能存在高消费但低频次的客户,或者低收入但忠诚度高的客户等。
通过分群,商家可以采取针对性的市场推广策略,如提供专属折扣、个性化推荐等,从而优化资源配置,提高盈利能力。
1.3 需要验证的假设
在本次分析中,我们希望验证以下几个假设:
- 客户可以根据年龄、年收入和消费评分划分为不同的群体,不同群体在消费行为上存在明显差异。
- 年收入较高的客户可能具有更高的消费评分,即高收入客户更倾向于高消费。
- 年龄可能对消费行为有影响,如年轻客户可能更倾向于高消费,而年长客户的消费评分可能较低。
- 不同性别的消费模式可能有所不同,例如,女性客户可能在某些群体中占比较高,或者某些群体更倾向于某一性别。
2. 数据探索
在本部分,我们将对数据集 Mall_Customers.csv 进行详细的探索性数据分析(EDA)。
主要包括以下几个方面:
- 查看数据基本信息
- 检查缺失值、异常值、重复数据
- 统计数据分布
- 数据可视化
2.1 导入库 & 读取数据
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns

# 读取数据
file_path = "./dataset/008/Mall_Customers.csv"
df = pd.read_csv(file_path)

# 查看数据基本信息
print(df.info())
print(df.describe())

# 查看前 5 行数据
df.head()
2.2 检查缺失值、重复值、异常值
# 检查缺失值
print("缺失值情况:\n", df.isnull().sum())

# 检查重复数据
print("重复值情况:", df.duplicated().sum())

# 统计每一列的唯一值数量
print("唯一值数量:\n", df.nunique())

# 检查极端值(利用 IQR 方法)
Q1 = df[['Age', 'Annual Income (k$)', 'Spending Score (1-100)']].quantile(0.25)
Q3 = df[['Age', 'Annual Income (k$)', 'Spending Score (1-100)']].quantile(0.75)
IQR = Q3 - Q1

# 计算异常值范围
lower_bound = Q1 - 1.5 * IQR
upper_bound = Q3 + 1.5 * IQR

# 查找异常值
outliers = ((df[['Age', 'Annual Income (k$)', 'Spending Score (1-100)']] < lower_bound) |
            (df[['Age', 'Annual Income (k$)', 'Spending Score (1-100)']] > upper_bound)).sum()
print("异常值统计:\n", outliers)
如果发现异常值过多,可以选择去除或进行数据转换(如对数变换、均值填充等)。
2.3 数据分布分析
# 设置 Seaborn 风格
sns.set(style="whitegrid")

# 年龄、年收入、消费评分的分布
fig, axes = plt.subplots(1, 3, figsize=(18, 5))

sns.histplot(df['Age'], bins=20, kde=True, color='royalblue', ax=axes[0])
axes[0].set_title('Age Distribution')
axes[0].set_xlabel('Age')

sns.histplot(df['Annual Income (k$)'], bins=20, kde=True, color='tomato', ax=axes[1])
axes[1].set_title('Annual Income Distribution')
axes[1].set_xlabel('Annual Income (k$)')

sns.histplot(df['Spending Score (1-100)'], bins=20, kde=True, color='seagreen', ax=axes[2])
axes[2].set_title('Spending Score Distribution')
axes[2].set_xlabel('Spending Score')

plt.show()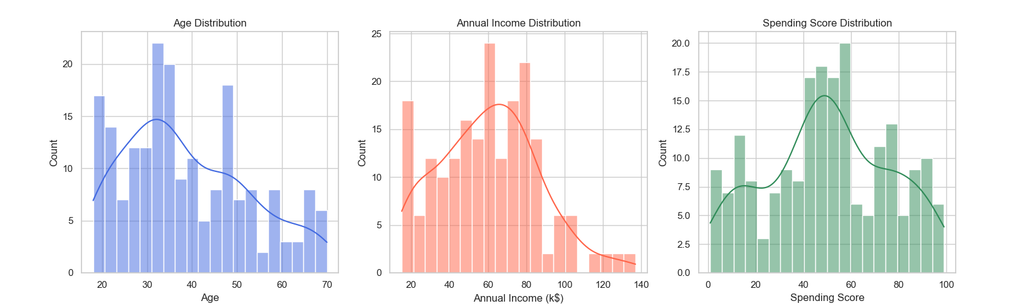
2.4 变量之间的相关性分析
# 计算相关性矩阵
corr_matrix = df[['Age', 'Annual Income (k$)', 'Spending Score (1-100)']].corr()

# 可视化相关性
plt.figure(figsize=(6, 5))
sns.heatmap(corr_matrix, annot=True, cmap='coolwarm', fmt=".2f")
plt.title("Feature Correlation Heatmap")
plt.show()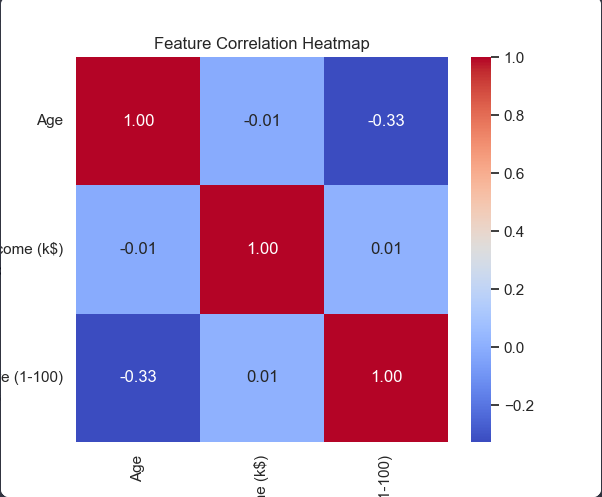
2.5 客户年龄、年收入与消费评分的关系
# 三个变量的关系
plt.figure(figsize=(10, 6))
sns.scatterplot(x='Annual Income (k$)', y='Spending Score (1-100)', hue='Age', size='Age',
                palette='viridis', sizes=(20, 200), data=df)
plt.title("Annual Income vs Spending Score (Age as Hue)")
plt.xlabel("Annual Income (k$)")
plt.ylabel("Spending Score")
plt.legend(title="Age")
plt.show()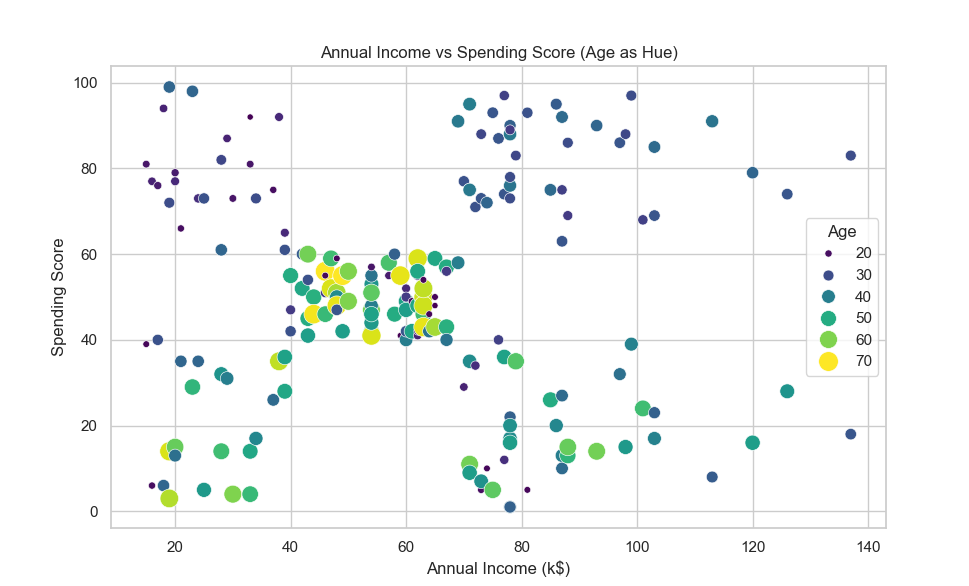
2.6 小结
- 数据没有缺失值或重复值,质量较好。
- 年龄分布较均衡,但存在部分较年轻或较年长的客户。
- 年收入大致呈正态分布,但存在部分高收入客户。
- 消费评分分布较均衡,但有部分极端客户(高消费评分或低消费评分)。
- 变量相关性分析显示,年收入和消费评分之间的相关性较弱,需要进一步探索是否存在不同的客户群体。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END











请登录后查看评论内容