

1. 目标定义和假设设定
1.1 目标定义
本次数据分析的目标是对信用卡交易数据进行基本探索,以识别潜在的欺诈交易模式,并为后续的机器学习建模奠定基础。
具体目标:
- 数据理解:分析数据的分布情况,变量的基本统计特征,以及数据中的潜在问题(如类别不平衡)。
- 欺诈交易识别:尝试发现欺诈交易与正常交易之间的区别,并探索可能的特征模式。
- 数据可视化:使用适当的图表展示数据特征,使数据模式更直观。
- 数据预处理:为后续机器学习任务做准备,包括缺失值处理、特征缩放、数据划分等。
- 初步建模:使用基础的机器学习方法(如逻辑回归、随机森林等)进行欺诈检测,评估初步模型的表现。
1.2 背景介绍
信用卡欺诈是一种常见的金融犯罪行为,欺诈分子通常通过盗刷、伪造身份等方式进行欺诈交易。由于欺诈交易通常只占所有交易的一小部分,如何在海量的正常交易中准确识别出欺诈行为,是银行和金融机构亟待解决的问题。
本案例使用的数据来自 Kaggle 的 Credit Card Fraud Detection 数据集,包含经过 PCA 变换的交易特征数据,并且目标变量(Class)表示交易是否为欺诈行为。
1.3 业务需求
对于银行和信用卡公司而言,有效识别欺诈交易能够:
- 降低经济损失:减少因欺诈交易导致的资金损失,提高信用卡交易的安全性。
- 提高用户体验:避免对正常交易进行误判,减少用户因交易被拒而产生的不满。
- 优化风险管理:结合数据分析结果,改进风控系统,提高欺诈检测能力。
1.4 关键假设
为了完成以上目标,我们需要基于数据分析以下关键假设:
- 欺诈交易与正常交易在数据分布上存在显著差异,即部分特征可以有效区分正常交易和欺诈交易。
- 欺诈交易的金额(Amount)可能较大,因为诈骗分子往往希望在短时间内获取更多资金。
- 欺诈交易在时间上可能具有某些模式,例如某些时段的欺诈交易更为集中。
- 数据类别不平衡问题严重,欺诈交易占比极低,因此需要特别处理以保证模型的有效性。
- PCA 变换后的特征仍然保留了原始交易的有效信息,能够用于欺诈检测。
2. 数据探索
这里,我们对信用卡交易数据进行详细的探索分析,包括基本统计信息、数据分布、异常值处理、数据可视化等,以便更好地理解数据特征,为后续建模做好准备。
2.1 读取数据并查看基本信息
首先,我们加载数据并检查其基本信息,如数据维度、缺失值情况、数据类型等。
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns

# 读取数据
file_path = "./mnt/data/creditcard.csv"  # 数据文件路径
df = pd.read_csv(file_path)

# 显示数据集的基本信息
print("数据集基本信息:")
print(df.info())

# 显示数据的前几行
print("\n数据集前几行:")
print(df.head())

# 统计数据的基本描述信息
print("\n数据集统计描述:")
print(df.describe())
2.2 检查缺失值、inf、NaN 和重复数据
# 检查缺失值
print("\n数据集中缺失值统计:")
print(df.isnull().sum())

# 检查是否存在无穷大 (inf) 数据
print("\n数据集中是否包含无穷大 (inf) 值:")
print(np.isinf(df.values).sum())

# 检查重复数据
print("\n数据集中重复行的数量:", df.duplicated().sum())

# 如果有重复数据,则删除
df = df.drop_duplicates()
print("去除重复数据后数据集大小:", df.shape)
2.3 数据分布分析
我们对交易金额 (Amount)、交易时间 (Time) 以及类别 (Class) 进行数据分布分析。
# 交易金额的分布
plt.figure(figsize=(10, 5))
sns.histplot(df['Amount'], bins=50, kde=True, color='blue')
plt.xlabel("Transaction Amount")
plt.ylabel("Frequency")
plt.title("Distribution of Transaction Amount")
plt.show()

# 交易时间的分布
plt.figure(figsize=(10, 5))
sns.histplot(df['Time'], bins=50, kde=True, color='green')
plt.xlabel("Transaction Time (Seconds)")
plt.ylabel("Frequency")
plt.title("Distribution of Transaction Time")
plt.show()

# 类别分布
plt.figure(figsize=(6, 6))
labels = ["Non-Fraud (0)", "Fraud (1)"]
sizes = df["Class"].value_counts().values
colors = ["#3498db", "#e74c3c"]
plt.pie(sizes, labels=labels, autopct='%1.2f%%', colors=colors, startangle=140, explode=(0, 0.1))
plt.title("Class Distribution")
plt.show()
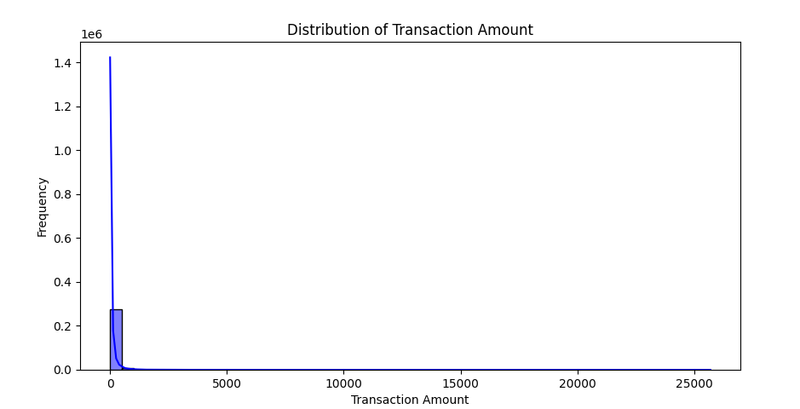
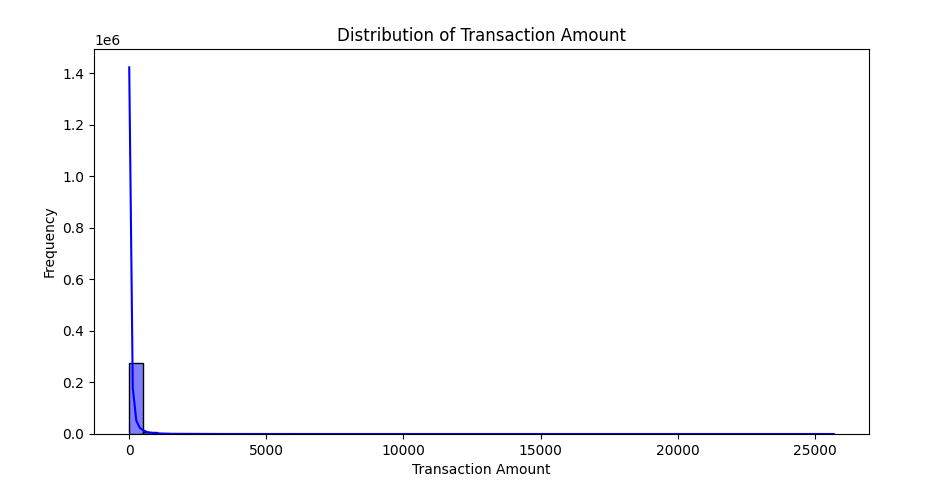
交易金额大部分较小,但有部分交易金额较大,需要进一步分析异常值。
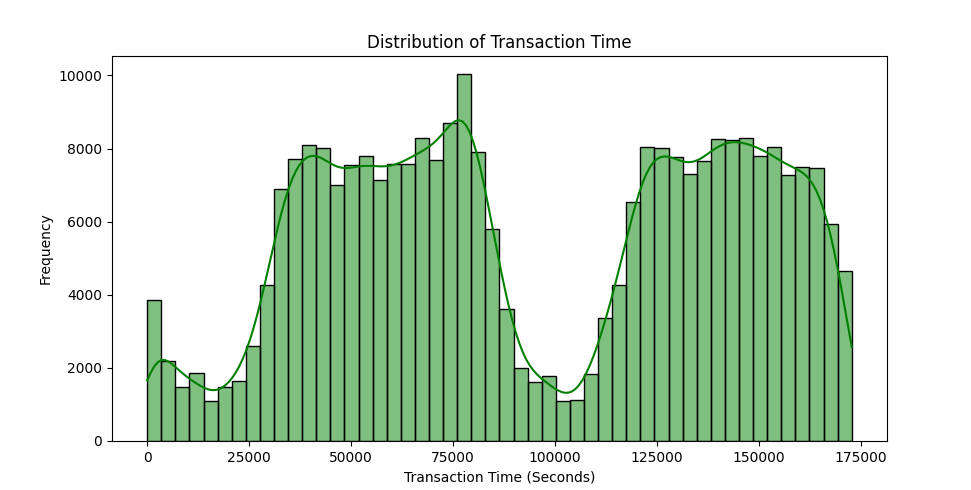
交易时间分布显示数据可能包含多个时间段,可能需要进一步分析欺诈交易的时间模式。
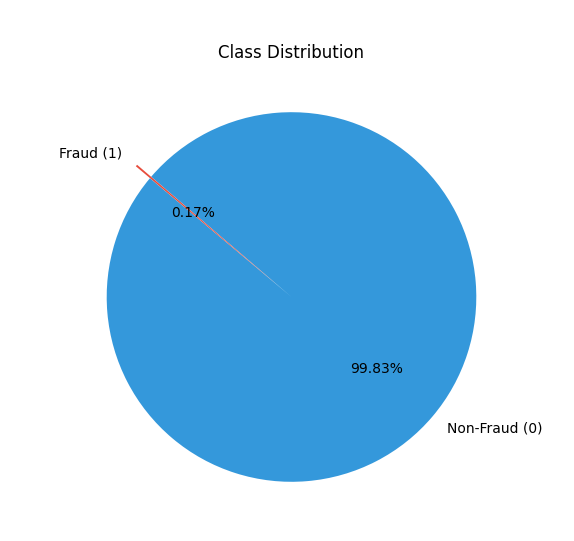
数据类别极度不平衡,欺诈交易(Class=1)占比非常低,后续需要采取数据平衡措施。
2.4 变量相关性分析
由于数据中的 V1-V28 特征已经过 PCA 降维,因此我们主要分析它们与目标变量(Class)之间的相关性。
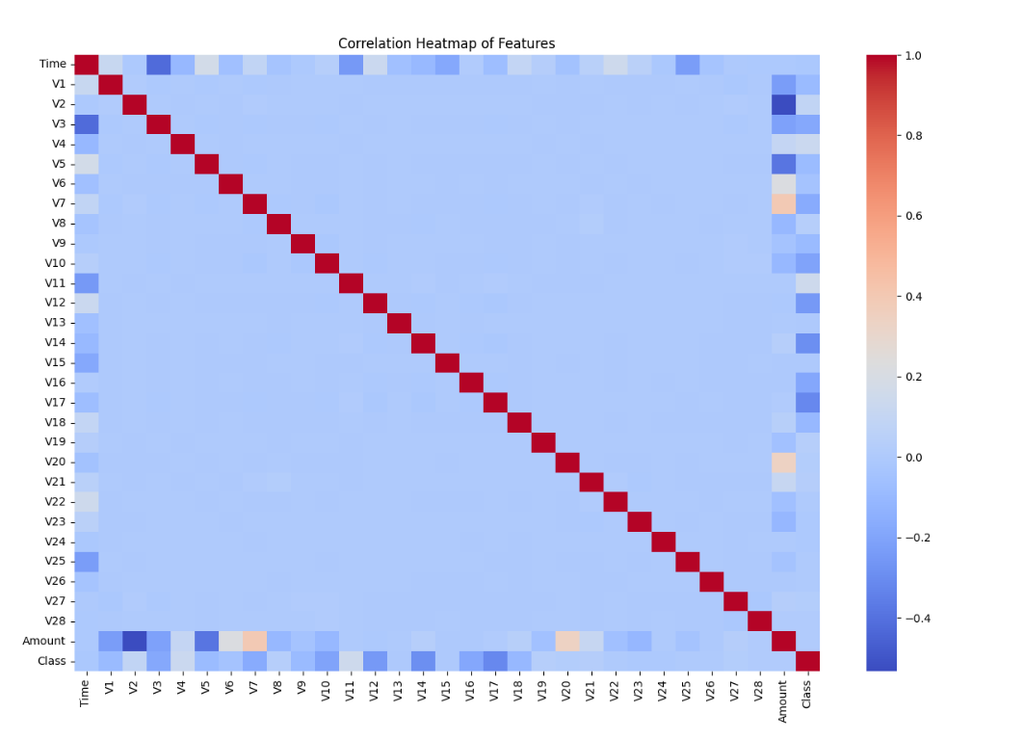
- 部分特征(如 V10、V12、V14 等)与欺诈交易的相关性较高,可能是关键识别特征。
- 交易金额(Amount)和时间(Time)与欺诈交易的相关性较低,但可能仍有一定的辅助作用。
2.5 识别异常值
由于欺诈交易较少,我们检查在与欺诈交易相关性较高的特征上是否存在异常值。
# 选取与 Class 相关性较高的特征
important_features = ["V10", "V12", "V14", "V17", "V18"]

plt.figure(figsize=(15, 8))
for i, feature in enumerate(important_features, 1):
    plt.subplot(2, 3, i)
    sns.boxplot(x=df["Class"], y=df[feature], palette=["blue", "red"])
    plt.xlabel("Class")
    plt.ylabel(feature)
    plt.title(f"Boxplot of {feature}")
plt.tight_layout()
plt.show()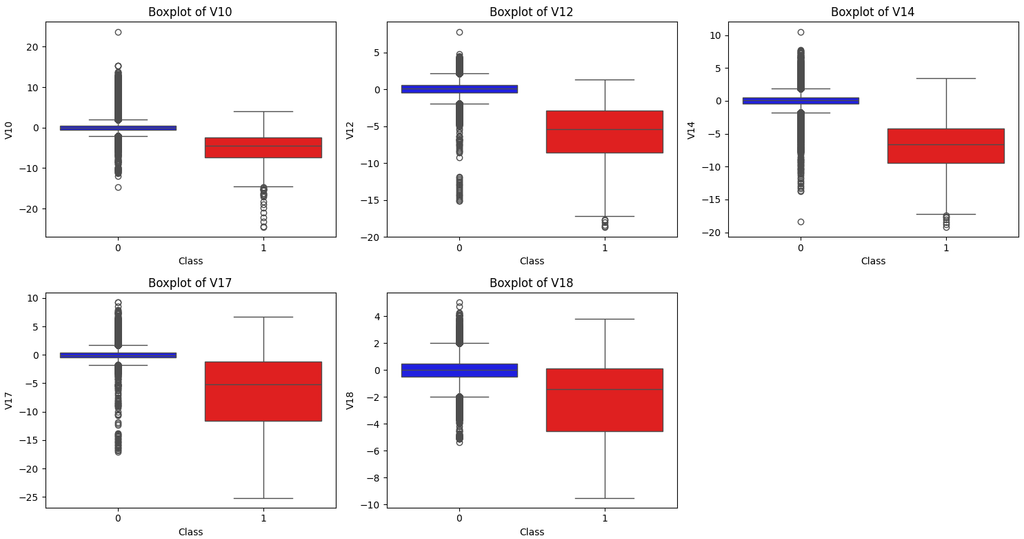
- 在欺诈交易中,这些特征的分布明显不同于正常交易,说明这些特征可能对模型的欺诈检测有重要贡献。
- 可能需要进一步处理极端值,以提高模型的稳定性。
2.6 小结
- 数据集无缺失值,但包含少量重复数据,已去除。
- 欺诈交易占比极低,类别严重不平衡。
- 部分特征(如 V10、V12、V14)在欺诈交易中的分布明显异常,可能是识别欺诈交易的重要特征。
- 交易金额大部分较小,但存在极端值,需在建模时进行处理。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END











请登录后查看评论内容