

选择一个适合的模型进行欺诈交易检测,并详细介绍其原理及适用性。
此外,我们会进行多维度数据分析,以提高欺诈识别的准确性。
4.1 模型选择
在欺诈交易检测问题中,我们面临以下几个挑战:
- 类别极度不平衡(欺诈交易远少于正常交易)。
- 特征已经过 PCA 变换,意味着某些机器学习算法可能比其他算法更适合处理这种数据。
- 需要高召回率(Recall),因为我们希望尽可能多地识别欺诈交易,而不遗漏风险交易。
候选模型
在分类问题中,我们有多个选择,包括:
- 逻辑回归(Logistic Regression)
- 适用于线性可分问题,但欺诈交易检测可能存在非线性特征。
- 计算效率高,但可能无法捕捉复杂的欺诈模式。
- 随机森林(Random Forest)
- 能够处理非线性特征,并且具有较强的特征选择能力。
- 计算成本较高,可能受数据不平衡影响。
- XGBoost(eXtreme Gradient Boosting)✅(最终选择)
- 适用于非平衡数据集,可以调整
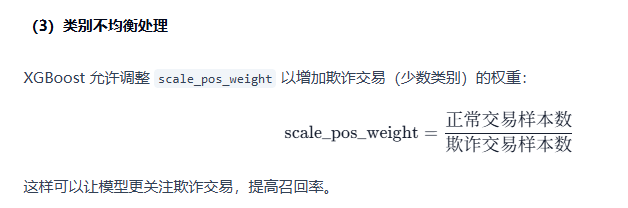
scale_pos_weight处理类别不均衡问题。 - 能够自动进行特征选择,减少冗余信息,提高模型泛化能力。
- 适用于 PCA 变换后的数据,可以有效挖掘欺诈交易模式。
- 适用于非平衡数据集,可以调整
4.2 XGBoost 的原理
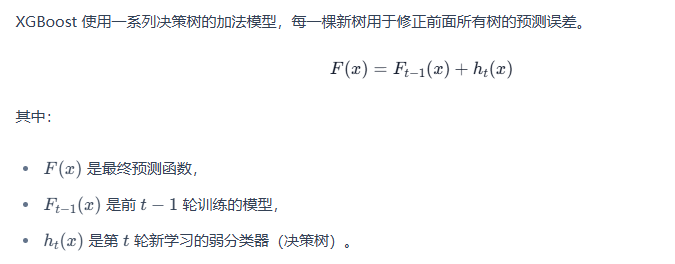
XGBoost 是基于梯度提升决策树(Gradient Boosting Decision Tree, GBDT)的一种优化算法,它结合了多棵决策树,采用加法模型逐步优化误差。
(1)加法模型
4.3 小结
模型选择:
- 选择 XGBoost,因为它适用于类别不均衡问题,并能自动进行特征选择。
XGBoost 核心原理:
- 使用 梯度提升树 逐步优化误差。
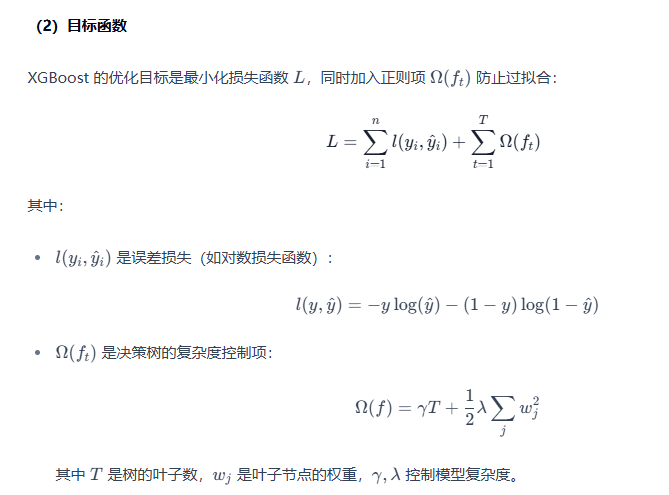
- 通过 正则化 控制模型复杂度,防止过拟合。
- 采用 类别权重调整 处理不均衡数据,提高召回率。
模型训练与评估:
- 训练了 XGBoost 模型,并进行混淆矩阵分析 和分类报告评估。
- 进行 特征重要性分析,找出影响欺诈交易检测的关键特征。
- 误分类分析帮助优化模型,减少欺诈交易的漏检率。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END











请登录后查看评论内容