

1.3.1 规则系统阶段
在20世纪50年代至80年代初,自然语言处理主要依赖人工编写的语言规则,这些规则由语言学家和程序员手动制定。这一阶段的代表系统有早期的机器翻译系统(如Georgetown-IBM实验)和ELIZA聊天机器人。这类系统在特定领域表现良好,但缺乏通用性,扩展性差,对语言的复杂性处理有限。
下面举例说明:
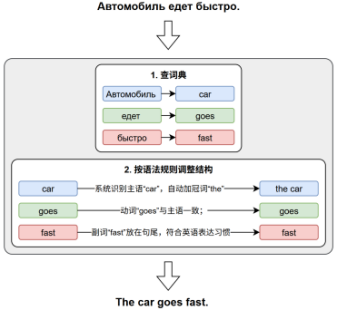
- Georgetown-IBM实验
该实验于1954年进行,由乔治城大学和IBM联合开发,实验演示了将60多个俄语句子完全自动翻译成英语。
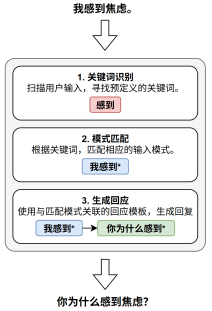
- ELIZA聊天机器人
ELIZA于1966年由约瑟夫·魏岑鲍姆(Joseph Weizenbaum)开发,目标是模拟一位心理医生,模仿“倾听式对话”,是世界上最早的“聊天机器人”。
1.3.2 统计方法阶段
90年代,随着计算能力的提升和语料资源的积累,统计方法逐渐成为主流。通过对大量文本数据进行概率建模,系统能够“学习”语言中的模式和规律。典型方法包括n-gram模型、隐马尔可夫模型(HMM)和最大熵模型。这一阶段标志着从“专家经验”向“数据驱动”方法的转变。
下面举例说明:
- N-gram模型
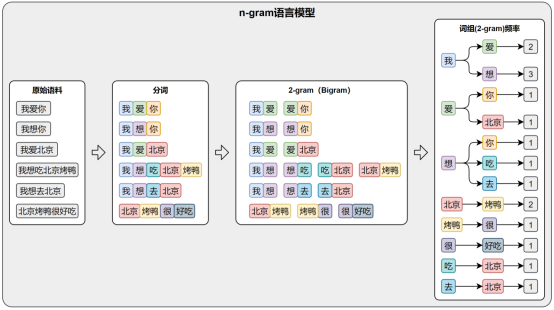
N-gram 模型是一种基于统计的方法,用于预测一个词在给定前几个词之后出现的可能性。它是自然语言处理中最早出现的语言建模方法之一。
该模型的核心思想是一个词出现的概率,只取决于它前面 N-1 个词。例如,在一个 Bigram(2-gram)模型 中,我们假设每个词只与它前面的一个词有关;而在 Trigram(3-gram)模型 中,我们考虑前两个词。
1.3.3 机器学习阶段
进入21世纪,NLP技术逐步引入传统机器学习方法,如逻辑回归、支持向量机(SVM)、决策树、条件随机场(CRF)等。这些方法在命名实体识别、文本分类等任务上表现出色。在此阶段,特征工程成为关键环节,研究者需要设计大量手工特征来提升模型性能。该阶段的特点是学习算法更为复杂,模型泛化能力增强。
下面举例说明:
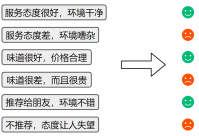
- 基于词袋模型与逻辑回归的文本分类示例
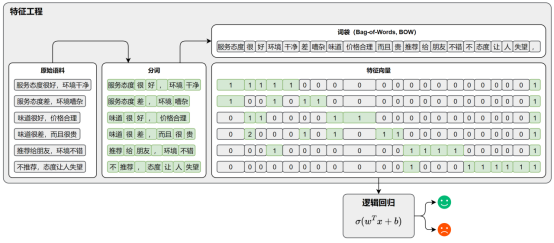
例子中提到的词袋模型,通过统计词频来表示文本,虽直接且简单,但它有一个明显的局限——它完全忽略了词语的顺序。
例如,如下两条完全相反的评论:
- 评论A:“服务很好但味道差劲”
- 评论B:“味道很好但服务差劲”
分词后结果分别是:
- “服务很好但味道差劲”à [“服务”,“很”,“好”,“但”,“味道”,“差劲”]
- “味道很好但服务差劲”à [“味道”,“很”,“好”,“但”,“服务”,“差劲”]
很明显,这两条评论在词袋模型中的特证向量是完全相同的。
为了解决这个问题,“古人”引入了n-gram。n-gram是将相邻的 n 个词作为一个整体来建模,这样就能保留一部分的词序信息。比如使用trigram(3-gram),上述两条评论就会变为如下:
- [“服务很好”,“很好但”,“好但味道”,“但味道差劲”]
- [“味道很好”,“很好但”,“好但服务”,“但服务差劲”]
其在词袋模型中的特征向量也就能够区分开了。
1.3.4 深度学习阶段
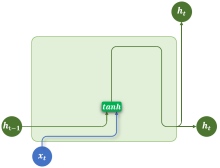
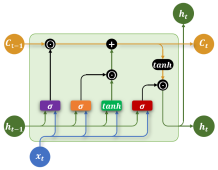
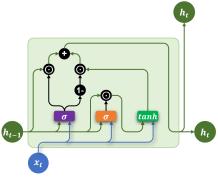
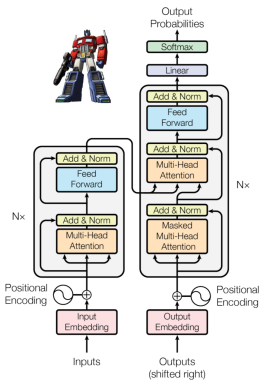
自2010年代中期开始,深度学习在NLP中迅速崛起。基于神经网络的模型RNN、LSTM、GRU等,取代了传统手工特征工程,能够从海量数据中自动提取语义表示。随后,Transformer架构的提出极大提升了语言理解与生成的能力,深度学习不仅在精度上实现突破,也推动了预训练语言模型(如GPT、BERT等)和迁移学习的发展,使NLP技术更通用、更强大。
- RNN(Recurrent Neural Network)
LSTM(Long Short-Term Memory)
GRU(Gated Recurrent Unit)
Transformer












请登录后查看评论内容