

尽管中文的语言结构与英文存在显著差异,我们仍可以借助“分词粒度”的视角,对中文的分词方式进行归类和分析。
- 字符级分词
字符级分词是中文处理中最简单的一种方式,即将文本按照单个汉字进行切分,文本中的每一个汉字都被视为一个独立的 token。

由于汉字本身通常具有独立语义,因此字符级分词在中文中具备天然的可行性。相比英文中的字符分词,中文的字符分词更加“语义友好”。
- 词级分词
词级分词是将中文文本按照完整词语进行切分的传统方法,切分结果更贴近人类阅读习惯。
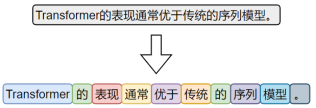
由于中文没有空格等天然词边界,词级分词通常依赖词典、规则或模型来识别词语边界。
- 子词级分词
虽然中文没有英文中的子词结构(如前缀、后缀、词根等),但子词分词算法(如 BPE)仍可直接应用于中文。它们以汉字为基本单位,通过学习语料中高频的字组合(如“自然”、“语言”、“处理”),自动构建子词词表。这种方式无需人工词典,具有较强的适应能力。
在当前主流的中文大模型(如通义千问、DeepSeek)中,子词分词已成为广泛采用的文本切分策略。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END











请登录后查看评论内容