


我们依然使用Digit Recognizer数据集来进行手写数字识别:https://www.kaggle.com/competitions/digit-recognizer。
文件train.csv中包含手绘数字(从0到9)的灰度图像,每张图像为28×28像素,共784像素。每个像素有一个0到255的值表示该像素的亮度。
文件第1列为标签,之后784列分别为784个像素的亮度值。
我们的任务,就是要搭建一个神经网络,实现它的前向传播;也就是要根据输入的数据(28×28 = 784数据点表示的图像),推断出它到底是哪个数字,这个过程也被称为“推理”。
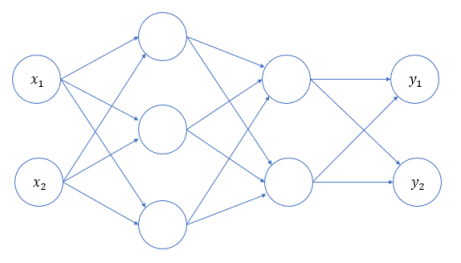
这里,我们构建的也是一个三层神经网络,输入层应该有784个神经元,输出层有10个神经元(表示0~9的分类结果);中间设置2个隐藏层,第一个隐藏层有50个神经元,第二个隐藏层有100个神经元。这里的参数是需要 学习 得到的;我们假设已经学习完毕,直接从保存好的文件nn_sample中进行读取即可。
具体代码如下:
import numpy as np
import pandas as pd
import joblib
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import MinMaxScaler
from common.functions import sigmoid, softmax

def get_data():
    # 加载数据集
data = pd.read_csv("../data/train.csv")
# 划分训练集和测试集
X = data.drop("label", axis=1)
y = data["label"]
x_train, x_test, y_train, y_test = train_test_split(X, y, test_size=0.3)
# 归一化
preprocessor = MinMaxScaler()
x_train = preprocessor.fit_transform(x_train)
x_test = preprocessor.transform(x_test)
return x_test, t_test

def init_network():
# 加载模型
network = joblib.load("../data/nn_sample")
return network

def predict(network, x):
    w1, w2, w3 = network['W1'], network['W2'], network['W3']
    b1, b2, b3 = network['b1'], network['b2'], network['b3']

    a1 = np.dot(x, w1) + b1
    z1 = sigmoid(a1)
    a2 = np.dot(z1, w2) + b2
    z2 = sigmoid(a2)
    a3 = np.dot(z2, w3) + b3
    y = softmax(a3)

    return y


x, t = get_data()
network = init_network()

batch_size = 100 # 批数量
accuracy_cnt = 0

for i in range(0, len(x), batch_size):
    x_batch = x[i:i+batch_size]
    y_batch = predict(network, x_batch)
    p = np.argmax(y_batch, axis=1)
    accuracy_cnt += np.sum(p == t[i:i+batch_size])

print("Accuracy:" + str(float(accuracy_cnt) / len(x)))
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END










请登录后查看评论内容