

深度学习模型训练中调整最频繁的当属学习率,好的学习率可以使模型逐渐收敛并获得更好的精度。较大的学习率可以加快收敛速度,但可能在最优解附近震荡或不收敛;较小的学习率可以提高收敛的精度,但训练速度慢。学习率衰减是一种平衡策略,初期使用较大学习率快速接近最优解,后期逐渐减小学习率,使参数更稳定地收敛到最优解。
- 等间隔衰减
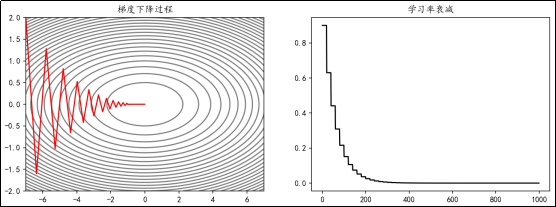
每隔固定的训练周期(epoch),学习率按一定的比例下降,也称为“步长衰减”。例如,使学习率每隔20 epoch衰减为之前的0.7:
2.指定间隔衰减
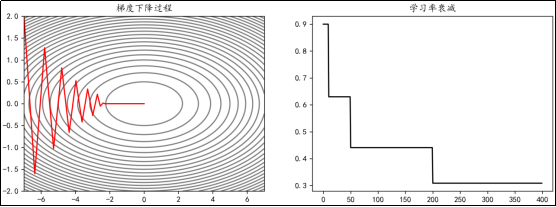
在指定的epoch,让学习率按照一定的系数衰减。例如,使学习率在epoch达到[10,50,200]时衰减为之前的0.7:
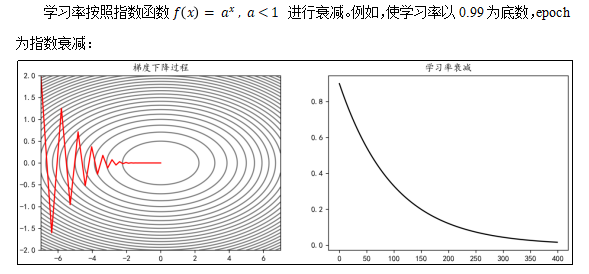
3. 指数衰减
5.2.4 AdaGrad
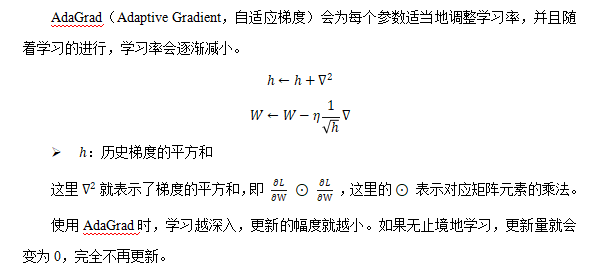
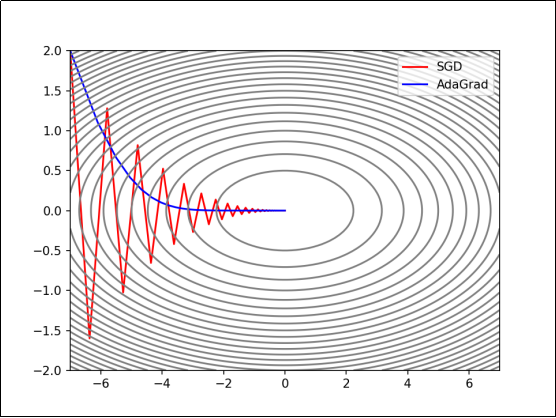
AdaGrad的代码实现如下:
class AdaGrad:

    def __init__(self, lr=0.01):
        self.lr = lr
        self.h = None

    def update(self, params, grads):
        if self.h is None:
            self.h = {}
            for key, val in params.items():
                self.h[key] = np.zeros_like(val)

        for key in params.keys():
            self.h[key] += grads[key] * grads[key]
            params[key] -= self.lr * grads[key] / (np.sqrt(self.h[key]) + 1e-7)
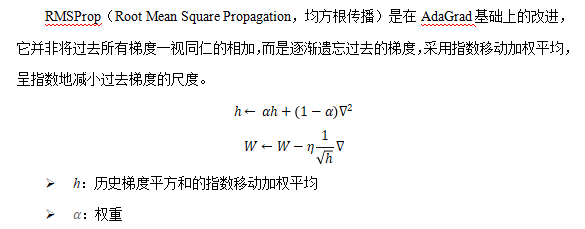
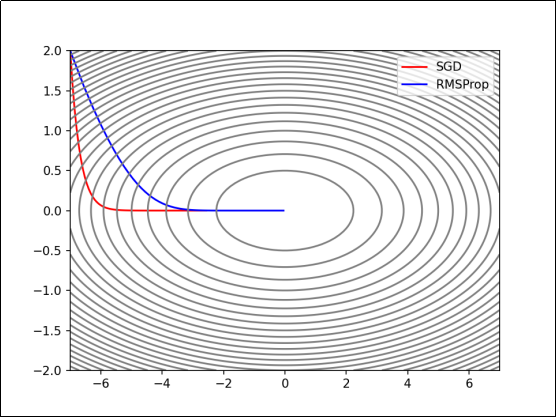
5.2.5 RMSProp
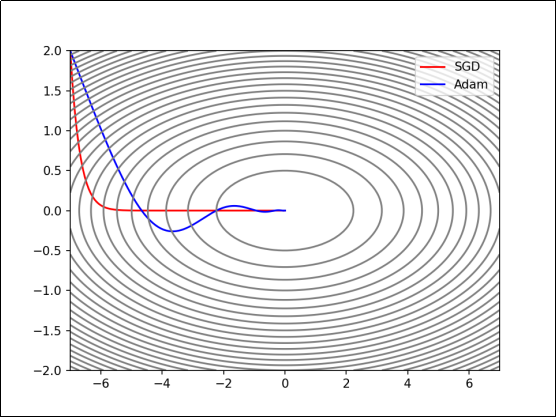
5.2.6 Adam
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END











请登录后查看评论内容