

机器学习的问题中,过拟合 是一个很常见的问题。
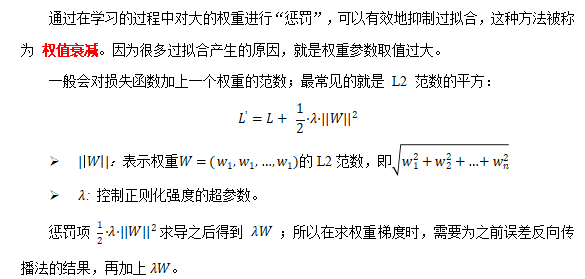
过拟合指的是能较好拟合训练数据,但不能很好地拟合不包含在训练数据中的其他数据。机器学习的目标是提高泛化能力,希望即便是不包含在训练数据里的未观测数据,模型也可以进行正确的预测。因此可以通过 正则化 方法来抑制过拟合。
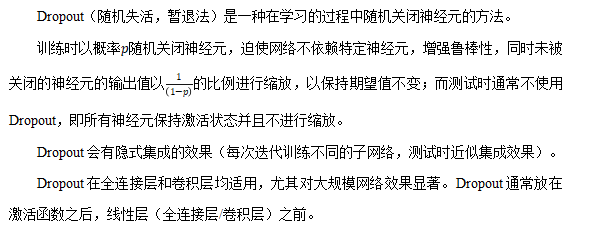
常用的正则化方法有Batch Normalization、权值衰减、Dropout、早停法等。
5.4.1 Batch Normalization批量标准化
Batch Normalization最重要的目的,其实是调整各层的激活值分布使其拥有适当的广度,BN层通常放在线性层(全连接层/卷积层)之后,激活函数之前。它有着以下优点:
- 可以使学习快速进行(允许更高的学习率)
- 不那么依赖初始值(对于初始值不用那么神经质)
- 抑制过拟合(降低Dropout等的必要性)
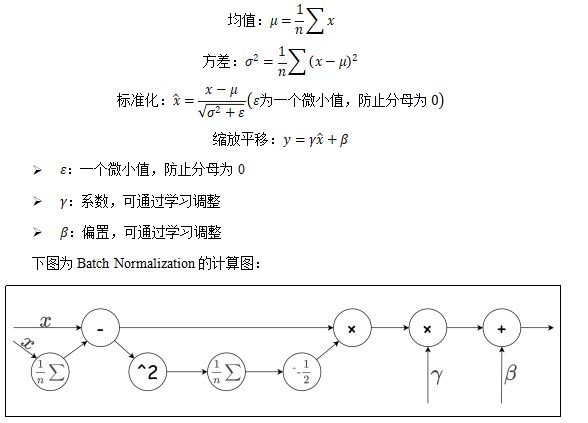
Batch Normalization会先对数据进行标准化,再对数据进行缩放和平移:
5.4.2 权值衰减
5.4.3 Dropout随机失活
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END











请登录后查看评论内容