

1)torch.cat()张量拼接,按已有维度拼接。除拼接维度外,其他维度大小须相同
import torch

tensor1 = torch.randint(1, 9, (2, 2, 5))
tensor2 = torch.randint(1, 9, (2, 1, 5))
print(tensor1)
print(tensor2)
print(torch.cat([tensor1, tensor2], dim=1))2)torch.stack()张量堆叠,按新维度堆叠。所有张量形状必须一致
import torch

torch.manual_seed(42)
tensor1 = torch.randint(1, 9, (3, 1, 5))
tensor2 = torch.randint(1, 9, (3, 1, 5))
print(tensor1)
print(tensor2)
tensor3 = torch.stack([tensor1, tensor2], dim=2)
print(tensor3)
print(tensor3.shape)
6.10 自动微分模块
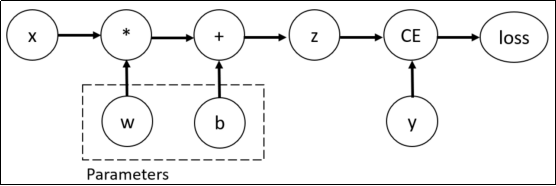
训练神经网络时,框架会根据设计好的模型构建一个计算图(computational graph),来跟踪计算是哪些数据通过哪些操作组合起来产生输出,并通过反向传播算法来根据给定参数的损失函数的梯度调整参数(模型权重)。
PyTorch具有一个内置的微分引擎torch.autograd以支持计算图的梯度自动计算。
考虑最简单的单层神经网络,具有输入x、参数w、偏置b以及损失函数:
import torch

# 输入x
x = torch.tensor(10.0)
# 目标值y
y = torch.tensor(3.0)

# 初始化权重w
w = torch.rand(1, 1, requires_grad=True)
# 初始化偏置b
b = torch.rand(1, 1, requires_grad=True)
z = w * x + b
# 设置损失函数
loss = torch.nn.MSELoss()
loss_value = loss(z, y)
# 反向传播
loss_value.backward()
# 打印w,b的梯度
print("w的梯度:\n", w.grad)
print("b的梯度:\n", b.grad)
该计算图中x、w、b为叶子节点,即最基础的节点。叶子节点的数据并非由计算生成,因此是整个计算图的基石,叶子节点张量不可以执行in-place操作。而最终的loss为根节点。
可通过is_leaf属性查看张量是否为叶子节点:
print(x.is_leaf)  # True
print(w.is_leaf)  # True
print(b.is_leaf)  # True
print(z.is_leaf)  # False
print(y.is_leaf)  # True
print(loss_value.is_leaf)  # False
自动微分的关键就是记录节点的数据与运算。数据记录在张量的data属性中,计算记录在张量的grad_fn属性中。
计算图根据搭建方式可分为静态图和动态图,PyTorch是动态图机制,在计算的过程中逐步搭建计算图,同时对每个Tensor都存储grad_fn供自动微分使用。
若设置张量参数requires_grad=True,则PyTorch会追踪所有基于该张量的操作,并在反向传播时计算其梯度。依赖于叶子节点的节点,requires_grad默认为True。当计算到根节点后,在根节点调用backward()方法即可反向传播计算计算图中所有节点的梯度。
非叶子节点的梯度在反向传播之后会被释放掉(除非设置参数retain_grad=True)。而叶子节点的梯度在反向传播之后会保留(累积)。通常需要使用optimizer.zero_grad()清零参数的梯度。
有时我们希望将某些计算移动到计算图之外,可以使用Tensor.detach()返回一个新的变量,该变量与原变量具有相同的值,但丢失计算图中如何计算原变量的信息。换句话说,梯度不会在该变量处继续向下传播。例如:
import torch

x = torch.ones(2, 2, requires_grad=True)
y = x * x
# 分离y来返回一个新变量u
u = y.detach()
z = u * x
# 梯度不会向后流经u到x
z.sum().backward()
# 反向传播函数计算z=u*x关于x的偏导数时将u作为常数处理,而不是z=x*x*x关于x的偏导数
x.grad == u
# tensor([[True, True],
#         [True, True]])










请登录后查看评论内容