

7.2.1 全连接层(nn.Linear)
在神经网络中,参数主要位于全连接层(仿射层Affine)中。
PyTorch提供了torch.nn模块,专门用于神经网络的构建和训练。其中全连接层被实现为Linear类,内部有两个属性:权重 weight和偏置bias;这就是神经网络的主要参数。
import torch.nn as nn

linear = nn.Linear(5, 2)
上面代码定义了一个有5个输入神经元、2个输出神经元的全连接层。
7.2.2 常数初始化
所有权重参数初始化为一个常数。
import torch.nn as nn

linear = nn.Linear(5, 2)

# 全部参数初始化为0
nn.init.zeros_(linear.weight)
print(linear.weight)

# 全部参数初始化为1
nn.init.ones_(linear.weight)
print(linear.weight)

# 全部参数初始化为一个常数
nn.init.constant_(linear.weight, 10)
print(linear.weight)
注意:将权重初始值设为0将无法正确进行学习。严格地说,不能将权重初始值设成一样的值。因为这意味着反向传播时权重全部都会进行相同的更新,被更新为相同的值(对称的值)。这使得神经网络拥有许多不同的权重的意义丧失了。为了防止“权重均一化”(瓦解权重的对称结构),必须随机生成初始值。
7.2.3 秩初始化
权重参数初始化为单位矩阵。
import torch.nn as nn

linear = nn.Linear(5, 2)

# 参数初始化为单位矩阵
nn.init.eye_(linear.weight)
print(linear.weight)
7.2.4 正态分布初始化
权重参数按指定均值与标准差正态分布初始化。
import torch.nn as nn

linear = nn.Linear(5, 2)

# 参数初始化为按指定均值与标准差正态分布
nn.init.normal_(linear.weight, mean=0.0, std=1.0)
print(linear.weight)
7.2.5 均匀分布初始化
权重参数在指定区间内均匀分布初始化。
import torch.nn as nn

linear = nn.Linear(5, 2)

# 参数初始化为在区间内均匀分布
nn.init.uniform_(linear.weight, a=0, b=10)
print(linear.weight)
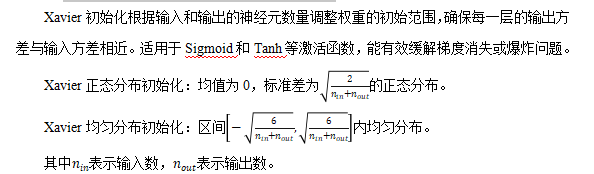
7.2.6 Xavier初始化(Glorot初始化)
import torch.nn as nn

linear = nn.Linear(5, 2)

# Xavier正态分布初始化
nn.init.xavier_normal_(linear.weight)
print(linear.weight)

# Xavier均匀分布初始化
nn.init.xavier_uniform_(linear.weight)
print(linear.weight)
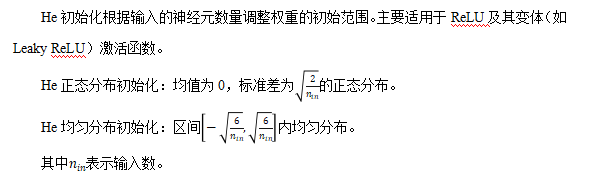
7.2.7 He初始化(Kaiming初始化)
import torch.nn as nn

linear = nn.Linear(5, 2)

# Kaiming正态分布初始化
nn.init.kaiming_normal_(linear.weight)
print(linear.weight)

# Kaiming均匀分布初始化
nn.init.kaiming_uniform_(linear.weight)
print(linear.weight)
7.2.8 Dropout随机失活
Dropout(随机失活,暂退法)是一种在学习的过程中随机关闭神经元的方法。
可以通过torch.nn.Dropout(p)来使用Dropout,并通过参数p来设置失活概率。
import torch

dropout = torch.nn.Dropout(p=0.5)
x = torch.randint(1, 10, (10,), dtype=torch.float32)
print("Dropout前:", x)
print("Dropout后:", dropout(x))
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END











请登录后查看评论内容