

9.4.1 数据预处理
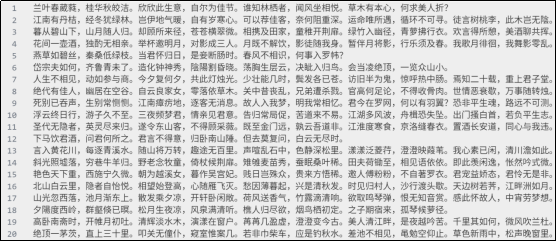
数据在.txt文件中,每行为一首诗。
首先将每个字作为一个词构建词表。并将原文转换为索引序列。
import re
import torch
from torch import nn, optim
from torch.utils.data import Dataset, DataLoader

# 数据预处理
def process_poems(file_path):
    poems = []  # 保存处理后的诗
    char_set = set()  # 保存所有不重复的字
    with open(file_path, "r", encoding="utf-8") as f:
        for line in f:
            # 逐行处理
            line = re.sub(r"[,。、?!:]", "", line).strip()  # 去掉标点符号与两侧空白
            # 按字分割并去重
            char_set.update(list(line))
            # 按字保存诗
            poems.append(list(line))

    # 构建词表
    vocab = list(char_set) + ["<UNK>"]
    # 创建词到索引的映射
    word2idx = {word: idx for idx, word in enumerate(vocab)}

    # 将诗转换为索引序列
    sequences = []
    for poem in poems:
        seq = [word2idx.get(word) for word in poem]
        sequences.append(seq)
    return sequences, word2idx, vocab

sequences, word2idx, vocab = process_poems("data/poems.txt")
9.4.2 自定义Dataset
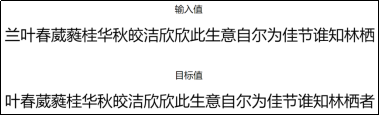
构建训练模型的数据集,将一个序列作为输入,另一个序列作为目标。
# 自定义Dataset
class PoetryDataset(Dataset):
    def __init__(self, sequences, seq_len):
        self.seq_len = seq_len
        self.data = []
        for seq in sequences:
            for i in range(0, len(seq) - self.seq_len):
                self.data.append((seq[i : i + self.seq_len], seq[i + 1 : i + 1 + self.seq_len]))

    def __len__(self):
        return len(self.data)

    def __getitem__(self, idx):
        x = torch.LongTensor(self.data[idx][0])
        y = torch.LongTensor(self.data[idx][1])
        return x, y

dataset = PoetryDataset(sequences, 24)
9.4.3 搭建模型
词嵌入层→RNN→全连接层。
# 搭建模型
class PoetryRNN(nn.Module):
    def __init__(self, vocab_size, embedding_dim=128, hidden_size=256, num_layers=1):
        super().__init__()
        self.embed = nn.Embedding(num_embeddings=vocab_size, embedding_dim=embedding_dim)
        self.rnn = nn.RNN(input_size=embedding_dim, hidden_size=hidden_size, num_layers=num_layers)
        self.linear = nn.Linear(in_features=hidden_size, out_features=vocab_size)

    def forward(self, input, hx=None):
        embed = self.embed(input)
        output, hidden = self.rnn(embed, hx)
        output = self.linear(output)
        return output, hidden

device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
model = PoetryRNN(len(vocab), 256, 512, 2).to(device)
9.4.4 模型训练
使用交叉熵损失函数,Adam优化方法。
# 模型训练
def train(model, dataset, lr, epoch_num, batch_size, device):
    model.train()  # 设置为训练模式
    dataloader = DataLoader(dataset, batch_size=batch_size, shuffle=True)
    loss = nn.CrossEntropyLoss()  # 损失函数
    optimizer = optim.Adam(model.parameters(), lr=lr)  # 优化器
    for epoch in range(epoch_num):
        loss_accumulate = 0  # 累加损失
        for batch_count, (x, y) in enumerate(dataloader):
            # 前向传播
            x, y = x.to(device), y.to(device)
            output, _ = model(x)
            # 反向传播
            loss_value = loss(output.transpose(1, 2), y)
            optimizer.zero_grad()
            loss_value.backward()
            optimizer.step()
            # 累加损失
            loss_accumulate += loss_value.item()
            print(f"\repoch:{epoch:0>2}[{'='*(int((batch_count+1) / len(dataloader) * 50)):<50}]", end="")
        print(f" loss:{loss_accumulate/len(dataloader):.6f}")

train(model=model, dataset=dataset, lr=1e-3, epoch_num=20, batch_size=32, device=device)
9.4.5 测试
输入一个起始词让模型开始生成。
# 生成
def generate_poem(model, word2idx, vocab, start_token, line_num=4, line_length=7):
    model.eval()  # 设置为预测模式
    poem = []  # 记录生成结果
    current_line_length = line_length  # 当前句的剩余长度
    start_token = word2idx.get(start_token, word2idx["<UNK>"])  # 起始token
    # 如果起始token在词典中,添加到结果中
    if start_token != word2idx["<UNK>"]:
        poem.append(vocab[start_token])
        current_line_length -= 1
    input = torch.LongTensor([[start_token]]).to(device)  # 输入
    hidden = None  # 初始化隐状态
    with torch.no_grad():  # 关闭梯度计算
        for _ in range(line_num):  # 生成的行数
            for interpunction in [",", "。\n"]:  # 每行两句
                while current_line_length > 0:  # 每句诗line_length个字
                    output, hidden = model(input, hidden)
                    prob = torch.softmax(output[0, 0], dim=-1)  # 计算概率
                    next_token = torch.multinomial(prob, 1)  # 从概率分布中随机采样
                    poem.append(vocab[next_token.item()])  # 将采样结果添加到结果中
                    input = next_token.unsqueeze(0)
                    current_line_length -= 1
                current_line_length = line_length
                poem.append(interpunction)  # 每句结尾添加标点符号
    return "".join(poem)  # 将列表转换为字符串

print(generate_poem(model, word2idx, vocab, start_token="一", line_num=4, line_length=7))
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END











请登录后查看评论内容