

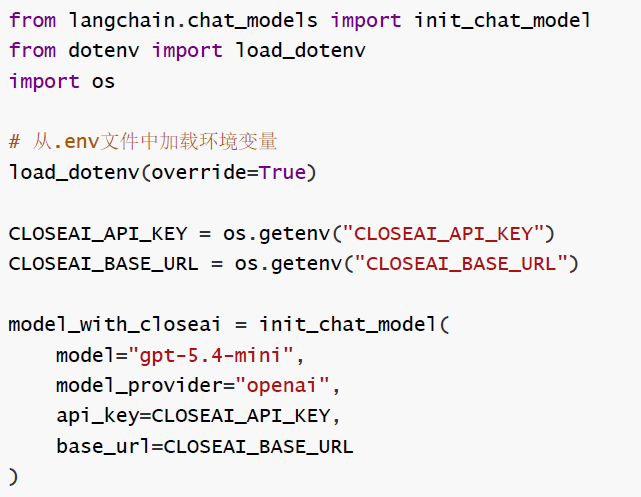
使用CloseAI平台的gpt模型:
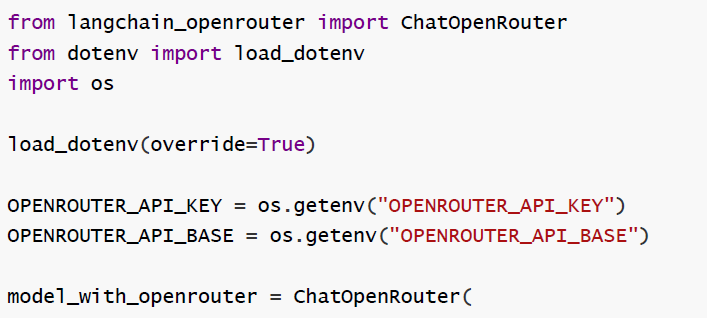
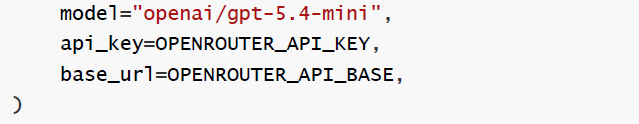
使用OpenRouter平台的gpt模型:
情况1:可选字段
问题:LLM 未填充某些字段怎么办?
使用Optional 指定字段为可选的。
举例:
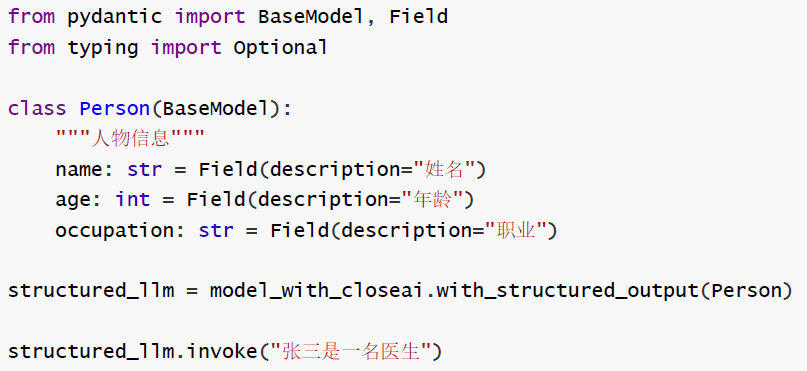
Person(name=’张三’, age=1 0, occupation=’医生’)
作为对比:
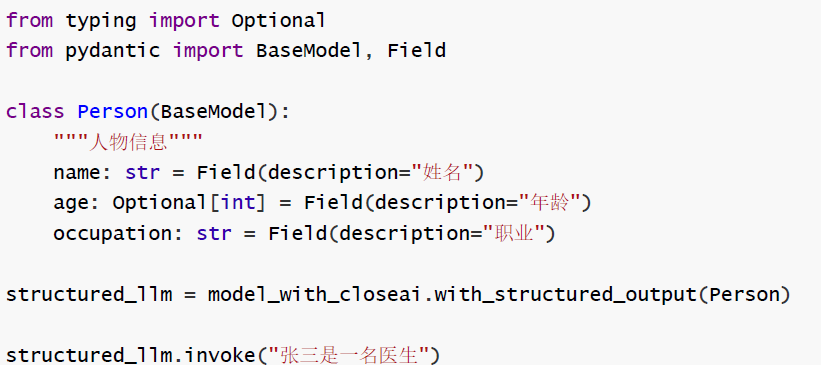
Person(name=’张三’, age=None, occupation=’医生’)
情况2:默认值
LLM 未提供的信息会使用默认值。格式如下:
Field(default=”默认值”, description=”描述”)
注意:不同模型提供商对default字段的支持是不同的。
举例1:
使用CloseAI平台的gpt模型:
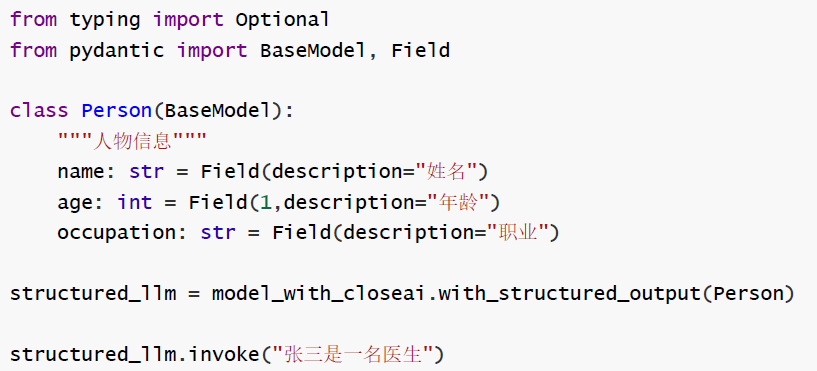
Person(name=’张三’, age=1 0, occupation=’医生’)
作为对比:
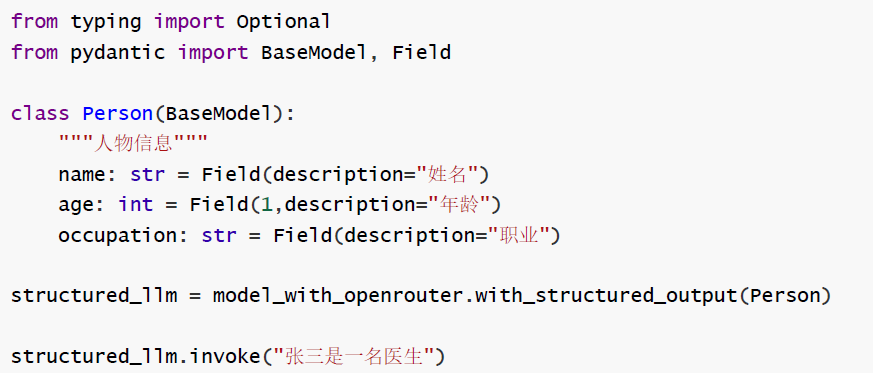
Person(name=’张三’, age=1, occupation=’医生’)
举例2:
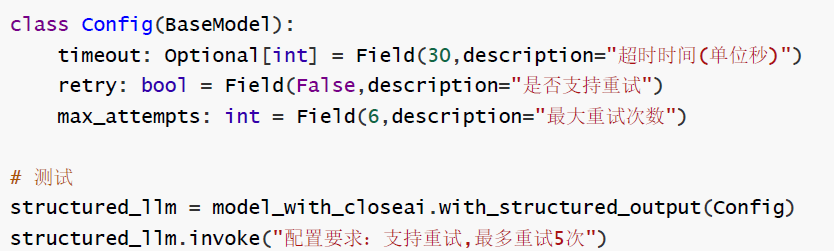
Config(timeout=None, retry=True, max_attempts=5)
作为对比:
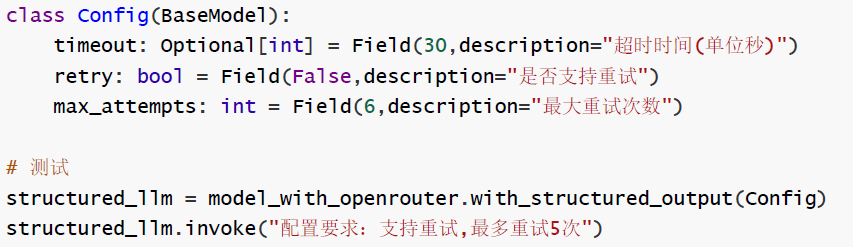
Config(timeout=None, retry=True, 1 max_attempts=5)
举例3:
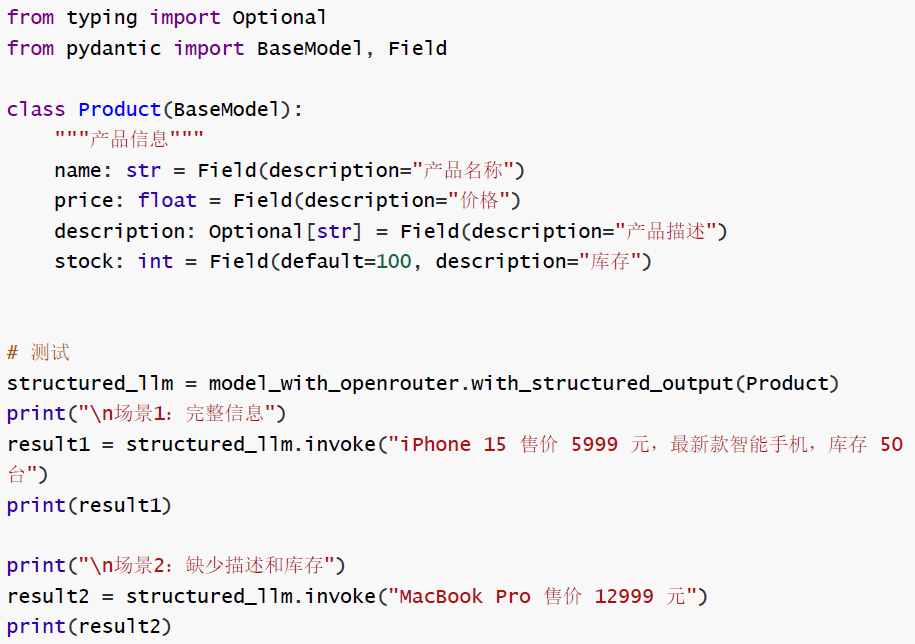
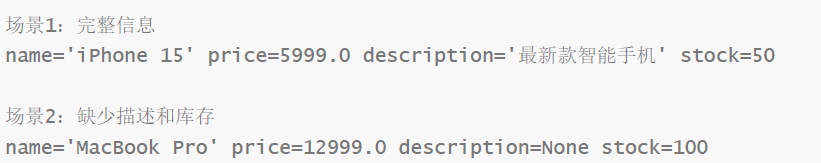
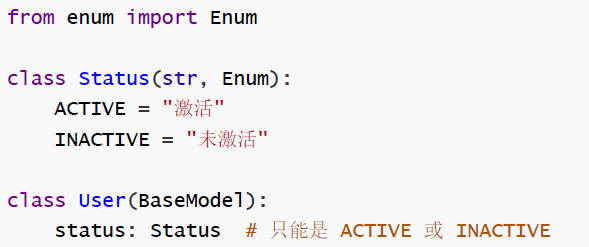
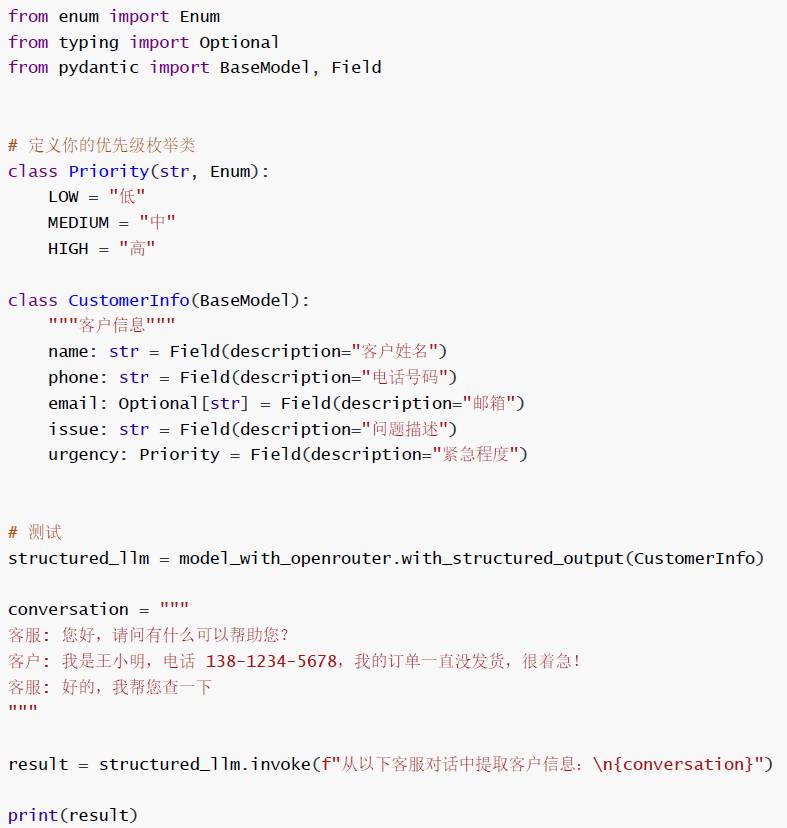
情况3:枚举类型
问题:如何限制字段的可选值?
回答:使用枚举。
举例1:
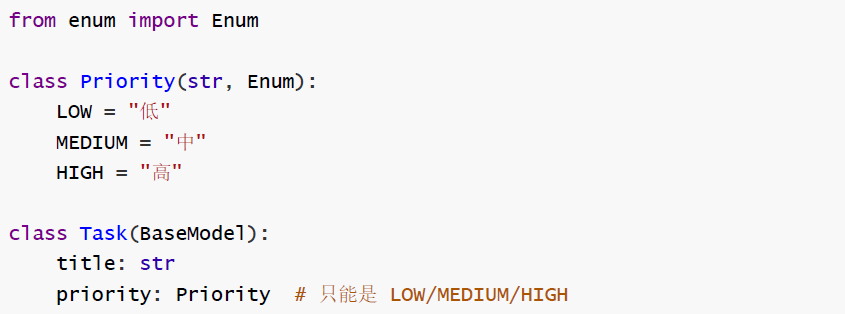
举例2:
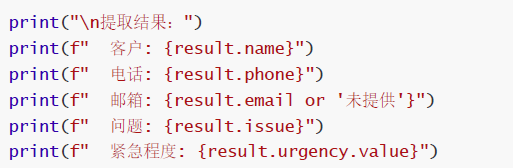
举例3:
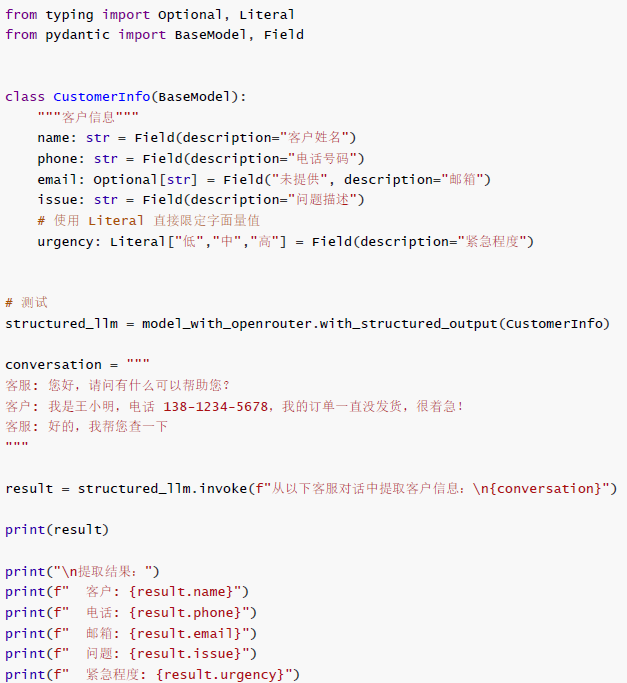
如果嫌单独定义一个 Enum 类太麻烦,也可以直接导入 typing 中的 Literal ,直接在字段里把允许的值写死。
- 应用场景:
- 自动填充 CRM 系统
- 工单自动分类
- 客服辅助
- 情况4:列表提取
- 举例1:
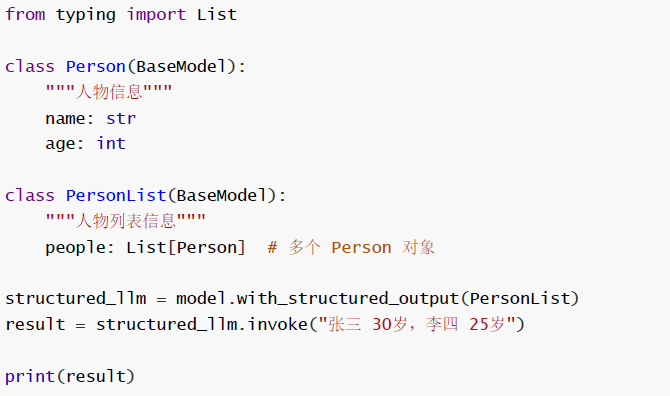
people=[Person(name=’张三’, age=30), Person(1 name=’李四’, age=25)]
举例2:产品评论分析
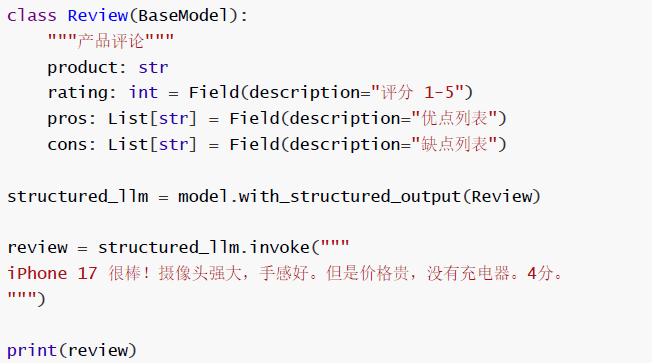
product=’iPhone 17′ rating=4 pros=[‘摄像头强大’, ‘手感好’] cons=[‘价格贵’,’没有充电器’]
- 应用场景:
- 批量处理用户评论
- 自动生成分析报告
- 发现产品改进点
- 举例3:文档信息提取
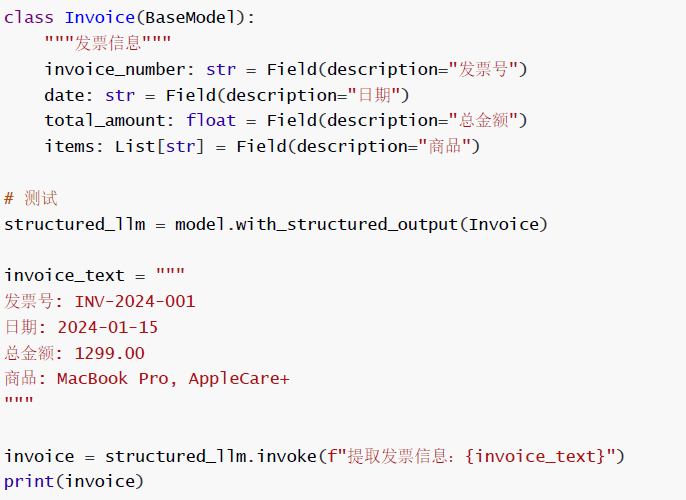
invoice_number=’INV-2024-001′ date=’2024-01-15′ total_amount=1299.0
items=[‘MacBook Pro’, ‘AppleCare+’]
- 应用场景:
- 自动化财务处理
- OCR 后结构化
- 数据录入
- 情况5:嵌套结构
- 举例1:
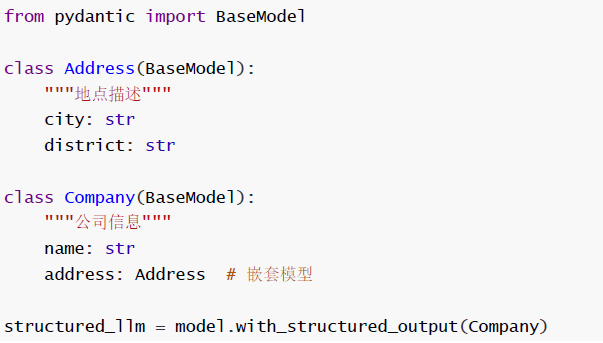
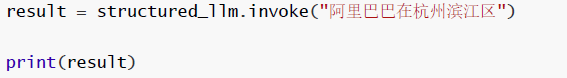
举例2:
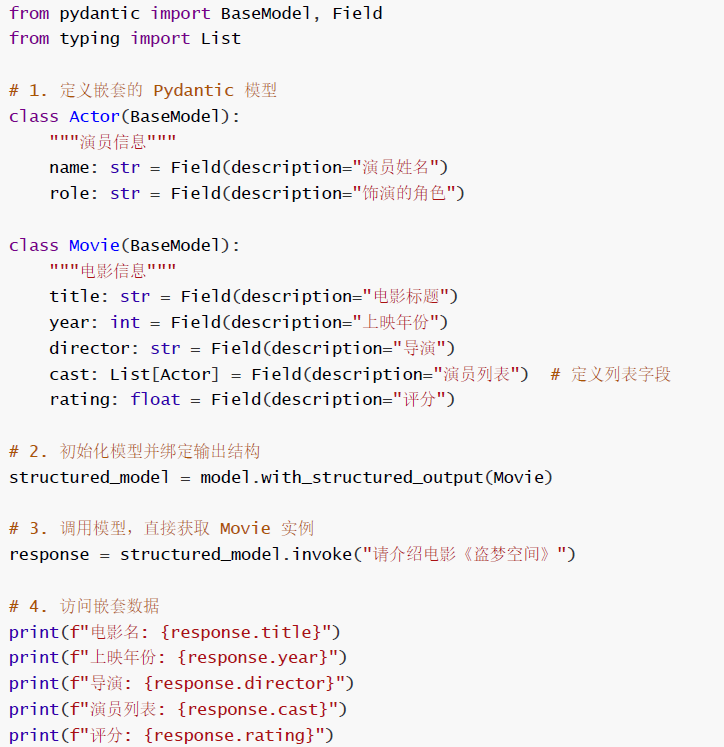
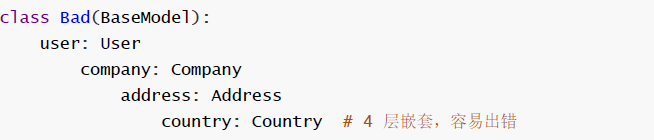
说明:LLM 能力有限,复杂嵌套结构可能会出错。所以建议:
嵌套层级 ≤ 3 层
使用清晰的 description
必要时拆分成多个调用
举例3:
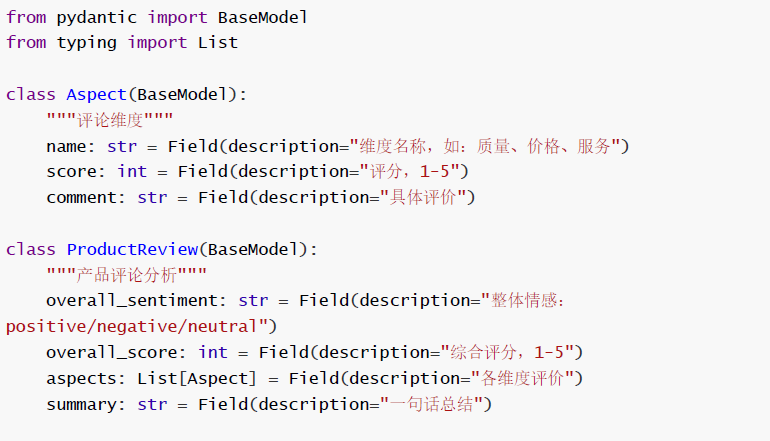
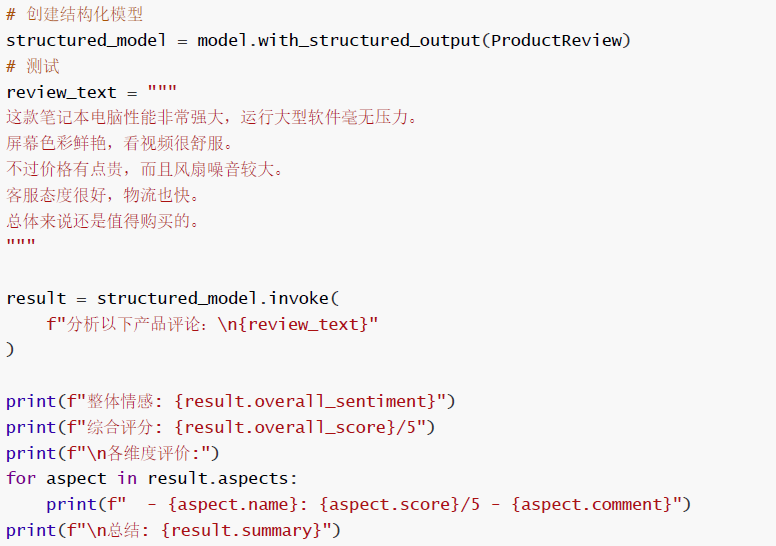
情况6:限制条件
举例1:
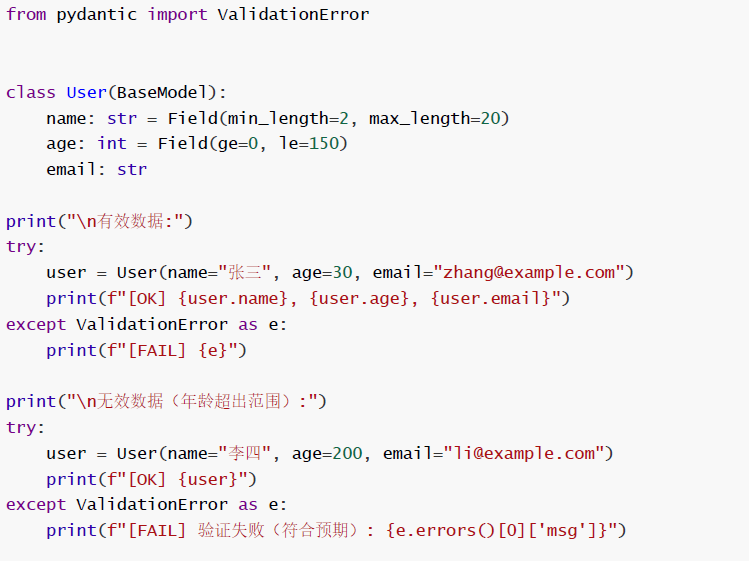
举例2:
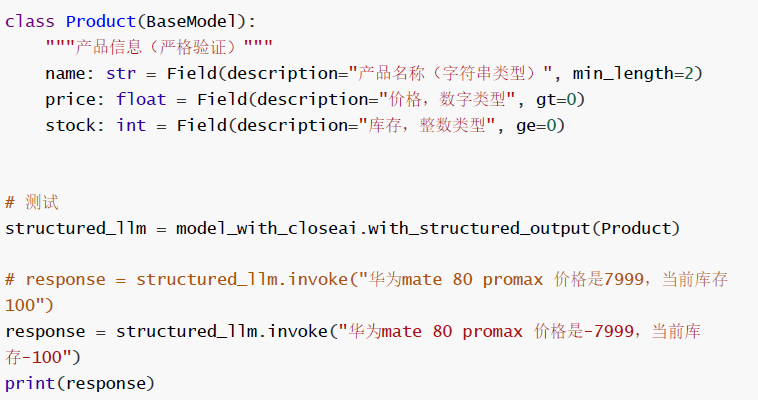
使用CloseAI平台模型
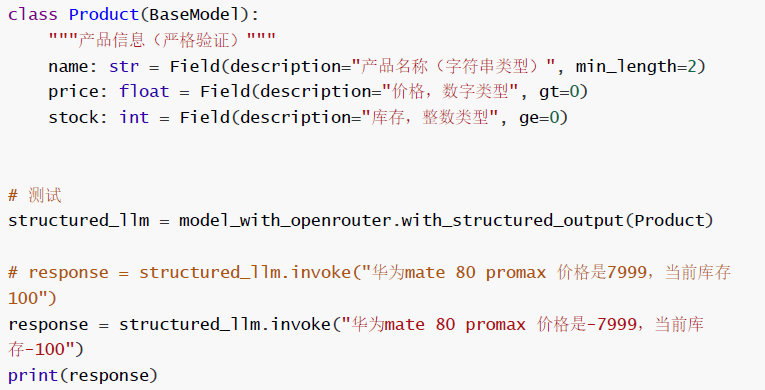
使用OpenRouter平台模型
2.1.3 工作流程图解
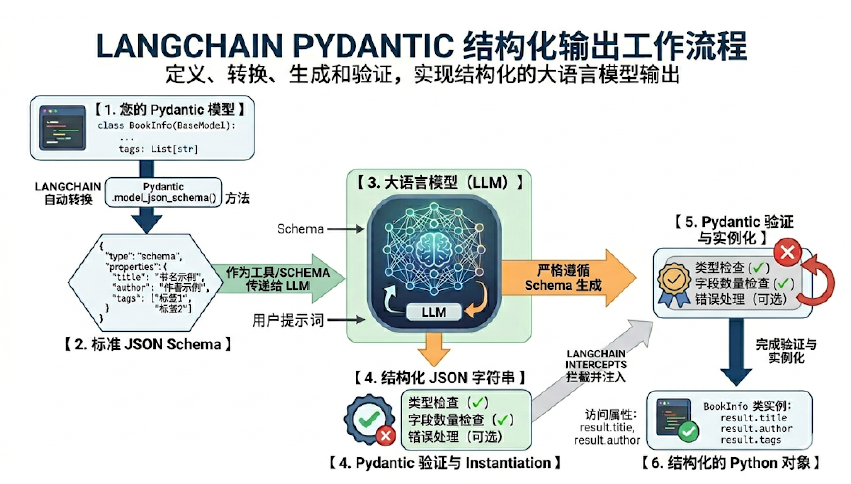
第2步:协议转换
LangChain 内部会调用 Pydantic 的底层方法(如 model_json_schema() ),将你写的 Python 代码自
动转换成标准的 JSON Schema。
这个 JSON Schema 是一段严格的 JSON 文本,详细描述了有哪些字段、字段类型是什么( string ,
array 等)以及字段的描述( description )。
第3步:模型交互与强约束
LangChain 会将这个 JSON Schema 包装进给大模型的 API 请求中。
- 现代方法( .with_structured_output ): 现代大模型(如 OpenAI、Anthropic、Gemini 等)普遍支持“函数调用/工具调用(Function/Tool Calling)”或“JSON Mode”。LangChain 会把 JSONSchema 作为 Tools 传入。
- 大模型侧的约束: 像 OpenAI 的 strict=True 参数,会启动模型的语法采样约束(Grammarbasedsampling)。大模型在解码生成 token 时,不是瞎猜,而是严格按照 JSON Schema 的语法树进行选择,从而在模型底层级保证了输出格式绝不走样。
第4步:自动解析与验证
当大模型返回符合 JSON 规范的字符串后,LangChain 的 PydanticStructuredOutputParser (解析
器)会接管工作:
- 解析(Parsing): 将字符串解析为 Python 字典。
- 验证(Validation): 将字典喂给你的 Pydantic 模型。Pydantic 会自动检查数据类型是否正确。
如果模型漏掉了必填字段,或者类型错误,这里会直接抛出验证错误(或者触发 LangChain 的重
试机制)。
- 返回(Return): 如果通过验证,你拿到的不再是冷冰冰的字符串,而是一个直接可以点出属性
的 Python Pydantic 对象(例如 result.title )。











请登录后查看评论内容