

随着对话的进行,历史消息不断累积, state会持续增长,为模型带来挑战:
- LLM的上下文窗口是有限的,完整历史可能无法装入LLM的上下文窗口,导致上下文丢失或错误。
- 即便模型的上下文窗口够大,多数LLM在长上下文场景仍然表现不佳。模型会被陈旧或离题的内容“分散注意力” 。
- 同时,会带来高昂的token花费。
此时需要对上下文进行管理:对历史记录进行压缩、清理、重组等。
2.4.1 消息裁剪
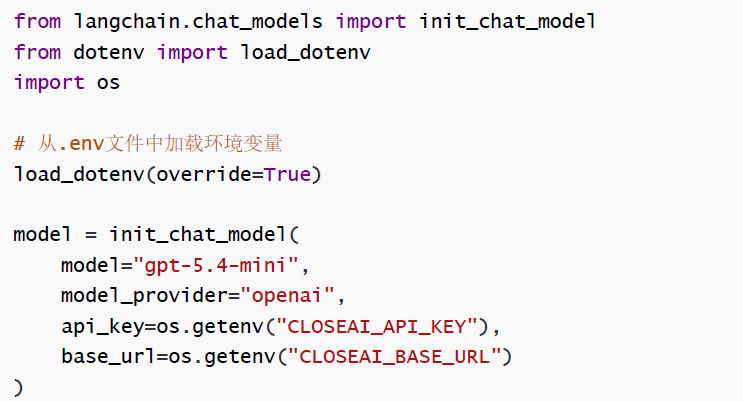
调用模型前裁剪上下文。
目标是控制token用量,通常保留系统初始消息和最近若干消息,或按token数保留末尾内容。
适合成本敏感、对旧上下文依赖不强的场景。
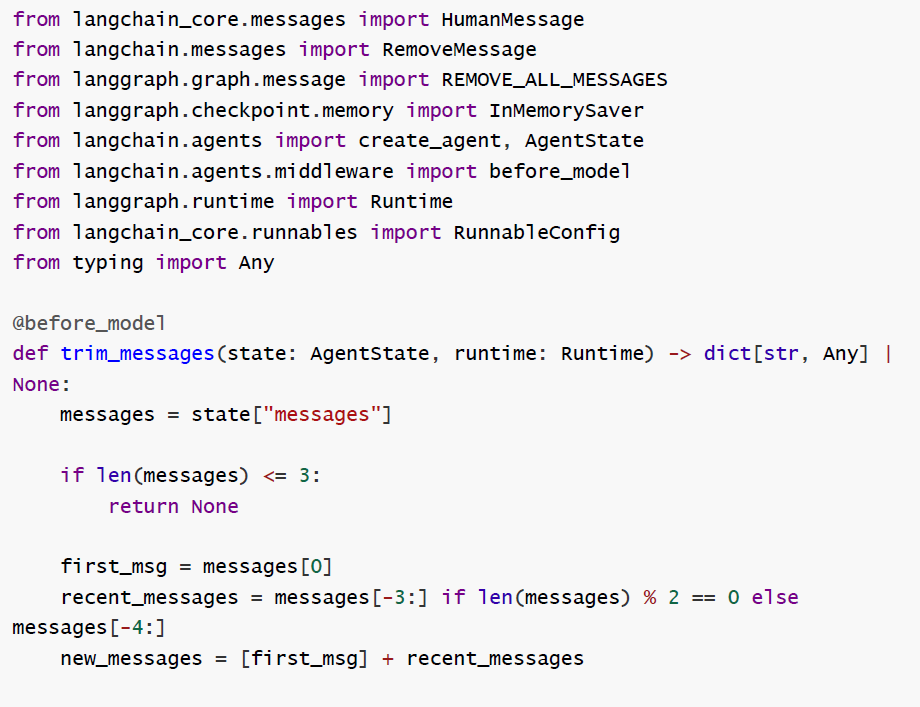
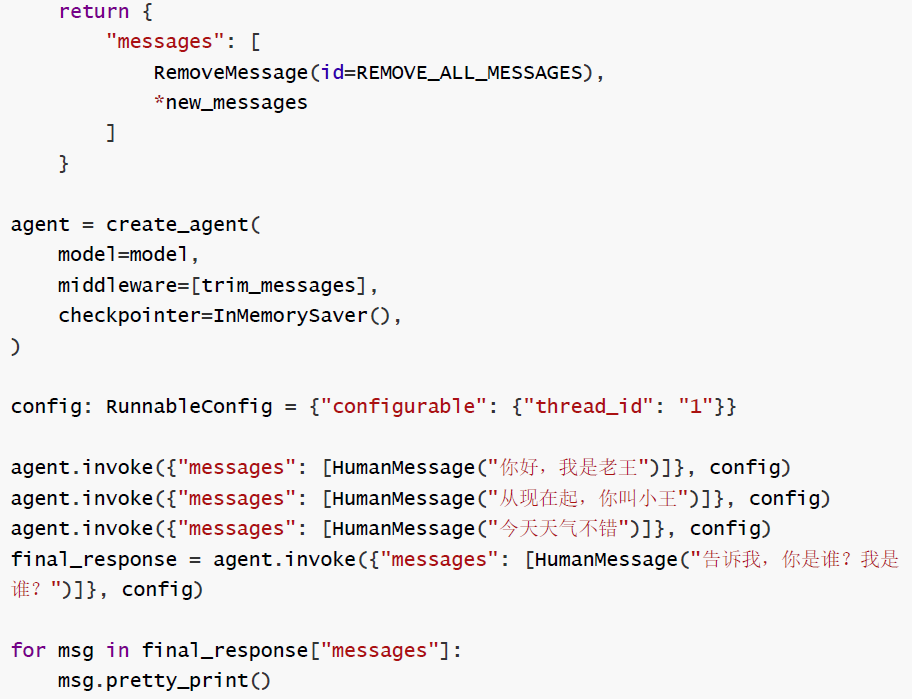
假设有 5 条消息: [H1, A1, H2, A2, H3] (当前总数 5,奇数)。
执行 messages[-4:] 取出 [A1, H2, A2, H3] 。加上第一条 H1 ,最终大模型看到的是 [H1, A1,H2, A2, H3] (相当于没剪掉什么)。
显然,裁剪生效了。
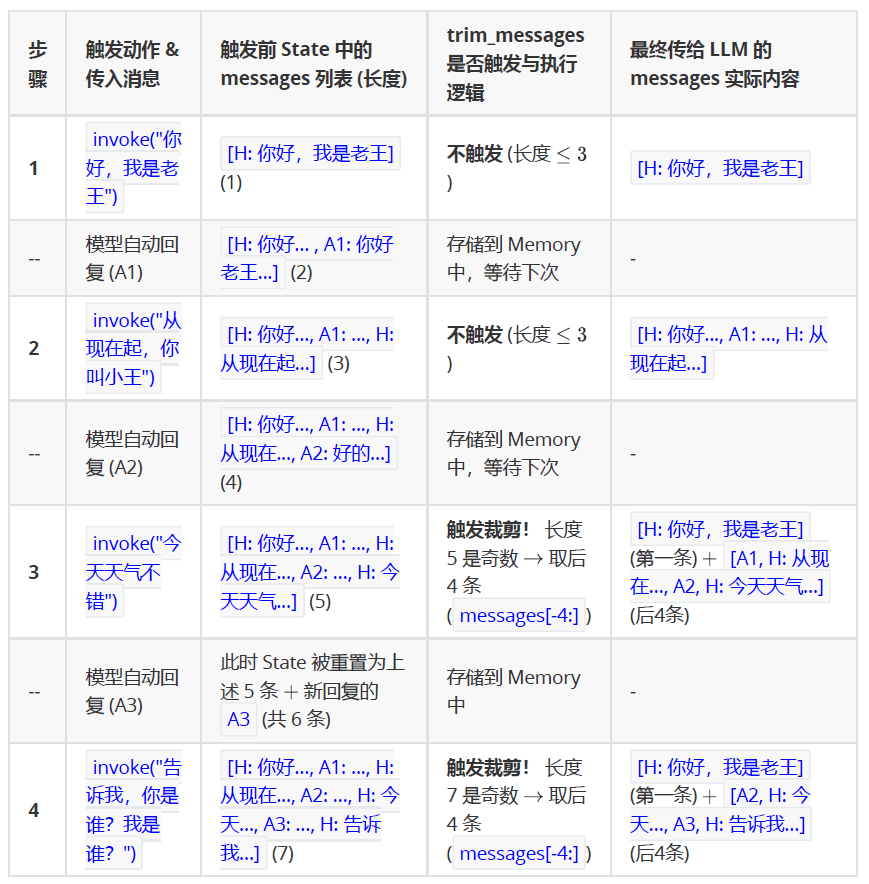
分析:
我们来看看连续 4 次 invoke 时,内存里到底发生了什么:
2.4.2 消息删除
消息裁剪强调“在模型调用前裁剪消息列表,控制模型可以看到的上下文范围”,而消息删除强调模型调用完成后将某些消息从消息列表中移除,永久更改状态。
适合明确要遗忘、清理、重置某些历史。
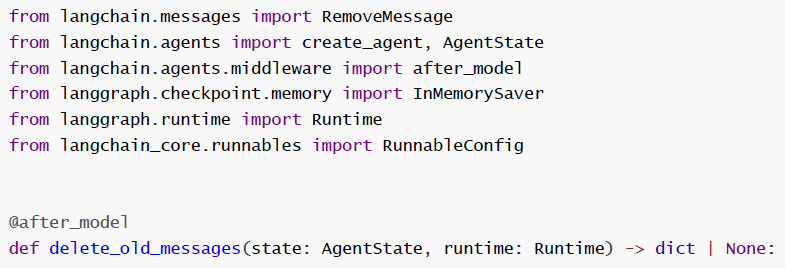
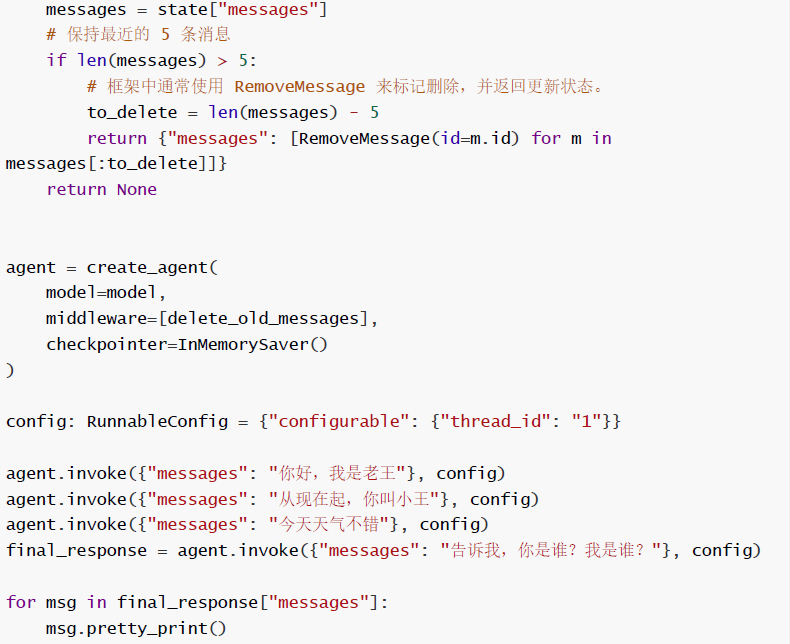
显然,模型调用后消息列表规模超过阈值触发了消息裁剪。
说明:只要消息总数超过 5 条,就计算超出几条( to_delete ),然后精准地删掉最老的那几条,使剩下的消息总数永远保持在 5 条。
分析消息列表 messages 的数量变化:
📥 第一轮:
- 用户说:”你好,我是老王”(第 1 条)
- AI 回复:”你好,老王!”(第 2 条)
- 数量:此时 len(messages) == 2 (不大于 5)。
- 结果:中间件不触发。(记忆:记住你是老王)
📥 第二轮:
- 用户说:”从现在起,你叫小王”(第 3 条)
- AI 回复:”好的,我是小王。”(第 4 条)
- 数量:此时 len(messages) == 4 (不大于 5)。
- 结果:中间件不触发。(记忆:记住你是老王、我是小王)
📥 第三轮:
- 用户说:”今天天气不错”(第 5 条)
- AI 回复:”是啊,天气好心情也好。”(第 6 条)
- 数量:此时 len(messages) == 6 。触发中间件条件 ( > 5 )!
- 清理发生:
- 计算 to_delete = 6 – 5 = 1 。
- 清理 messages[:1] ,也就是只删除了第 1 条消息(“你好,我是老王”)。
- 剩余消息(共 5 条):
- AI 回复:”你好,老王!”(第 2 条)
- 用户说:”从现在起,你叫小王”(第 3 条)
- AI 回复:”好的,我是小王。”(第 4 条)
- 用户说:”今天天气不错”(第 5 条)
- AI 回复:”是啊,天气好心情也好。”(第 6 条)
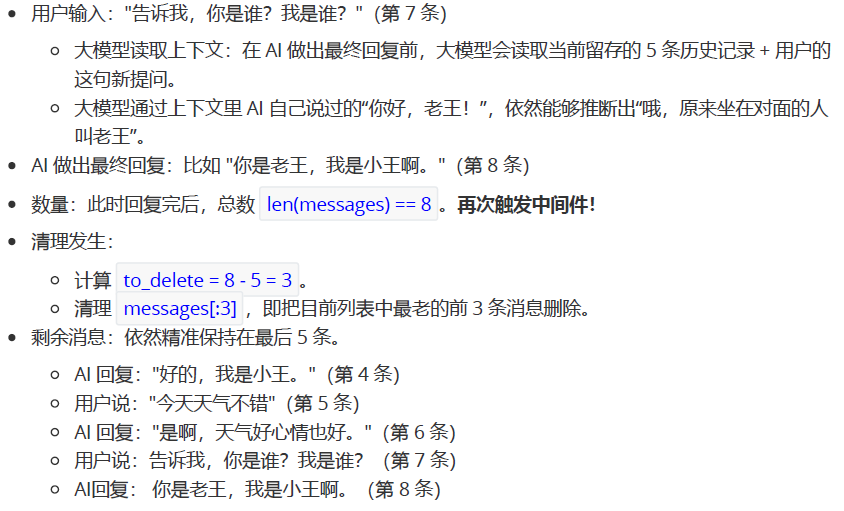
📥 第四轮(最终提问):
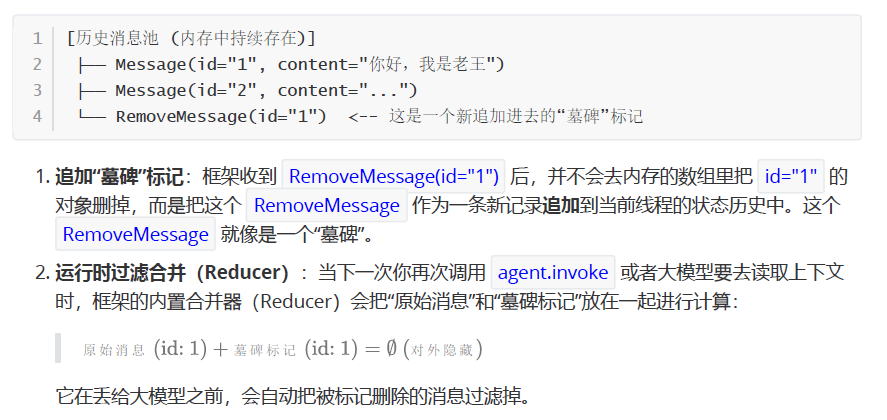
RemoveMessage到底干了什么?
当你在中间件里返回 [RemoveMessage(id=m.id)] 时,你实际上是向框架发送了一个删除指令。
框架的底层处理逻辑如下:
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END











请登录后查看评论内容