

前面三节,我们已经把 Agent 最基础的运行骨架搭起来了。
先是知道 Agent 和 Workflow 的区别,然后手写 Main Loop,再把 goal、messages、step、tool_history、status 这些信息收进 Agent State。
现在再往前一步,很自然会遇到一个工程问题,Agent 到底要不要和某一家模型厂商绑死?
比如我们一开始用 OpenAI,于是在 Main Loop 里直接写:
client.responses.create(...)过几天想换 Claude,又把 Main Loop 改成:
client.messages.create(...)以后再接本地模型,还要继续改。
很快你会发现,本来应该只关心“Agent 下一步做什么”的核心逻辑,开始被不同模型 SDK 的参数、响应对象、异常类型、模型名称、鉴权方式塞满。
这一节我们就把这个问题彻底拆开。
学完以后,你应该能做到:
- 让 Agent Engine 只认识一个统一接口,例如
provider.chat(messages, tools=None)。 - 不让 Main Loop 直接 import OpenAI、Anthropic 或某个本地推理 SDK。
- 把不同厂商的请求格式和响应格式统一成我们自己的内部结构。
- 在不修改 Agent 核心代码的情况下,切换 OpenAIProvider、ClaudeProvider、LocalModelProvider。
- 知道以后 Tool Calling、Tracing、Fallback、模型路由为什么都要建立在 Provider 抽象之上。
这一节可以先把 Provider 理解成“翻译层”。Agent Engine 使用课程内部约定的消息和响应;Provider 负责把它们翻译成某个模型服务认识的格式,再把外部响应翻译回来。只要这条边界守住,后面新增模型时,变化就会停在 Provider 内部。
有三个名字很容易混在一起。Model 是实际生成结果的模型;SDK 是某家服务提供的调用工具;Provider 是我们写在 Harness 里的适配层。Provider 可以使用 SDK,也可以直接发 HTTP 请求,但 Agent Engine 不应该直接依赖二者的细节。
开场引入
我们先想象一个非常常见的开发过程。
第一版 Agent 只为了跑通,所以直接写:
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="...",
    input=messages
)
程序跑通了,大家很开心。
过了一周,团队说,“有些任务 Claude 表现更好,能不能切 Claude?”
于是开始改。
再过一周,老板说,“公司有一些敏感数据,能不能支持本地模型?”
继续改。
再过一段时间,团队又希望:
- 简单任务用便宜模型;
- 复杂任务用更强模型;
- 云模型失败时自动切本地;
- 不同 Provider 统一统计 Token;
- 统一记录 latency;
- 统一处理 429、超时、网络异常;
- 统一支持 Tool Calling。
如果我们一开始把具体 SDK 直接写进 Agent Loop,后面会变成什么样?
大概率是:
if provider == "openai":
    ...
elif provider == "anthropic":
    ...
elif provider == "local":
    ...
然后每个分支里面又有:
if tools:
    ...
else:
    ...
再加上:
try:
    ...
except OpenAIError:
    ...
except AnthropicError:
    ...
except requests.Timeout:
    ...
最后你会发现,Agent Engine 里真正和“Agent 决策”有关的代码反而只剩一点点。
这就是典型的强耦合。
我们真正想要的结构应该是:
Agent Engine
     ↓
Provider Interface
     ↓
┌───────────────┬───────────────┬──────────────────┐
│ OpenAIProvider│ ClaudeProvider│ LocalModelProvider│
└───────────────┴───────────────┴──────────────────┘
Agent Engine 只知道:
response = provider.chat(messages, tools)它根本不关心底层是谁。
如果换模型:
provider = OpenAIProvider(...)改成:
provider = ClaudeProvider(...)或者:
provider = LocalModelProvider(...)Agent Main Loop 不动。
这就是 Provider 抽象真正的价值。
很多人第一次看到:
class LLMProvider:
    def chat(self, messages, tools=None):
        pass
会觉得,“不就是多包一层类吗?”
如果系统只有 50 行,确实看不出价值。
但 Agent 是一个会持续增长的工程系统。
后面还会加:
Tool Calling
Streaming
Tracing
Token Usage
Retry
Fallback
Rate Limit
Timeout
Model Routing
Structured Output
不同厂商的实现都可能不同。
如果没有 Provider 层,这些差异会一路污染到 Agent Engine。
所以这一节我们要建立的,不只是一个 Python 抽象类,而是一条非常重要的工程边界,Agent 负责“怎么做任务”,Provider 负责“怎么和具体模型说话”。
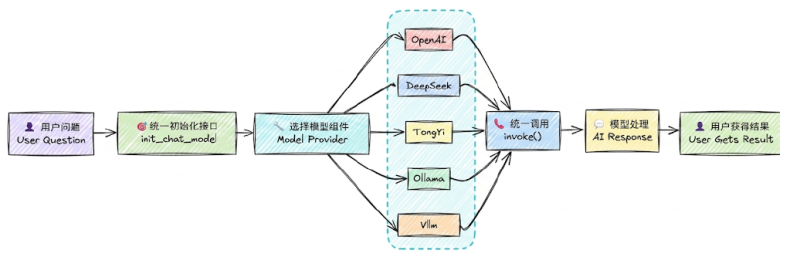
把依赖方向摊开看,Engine 下面只有一个 LLMProvider 接口;OpenAI、Claude 和本地模型各自在接口的另一侧处理自己的 SDK 或 HTTP 细节。
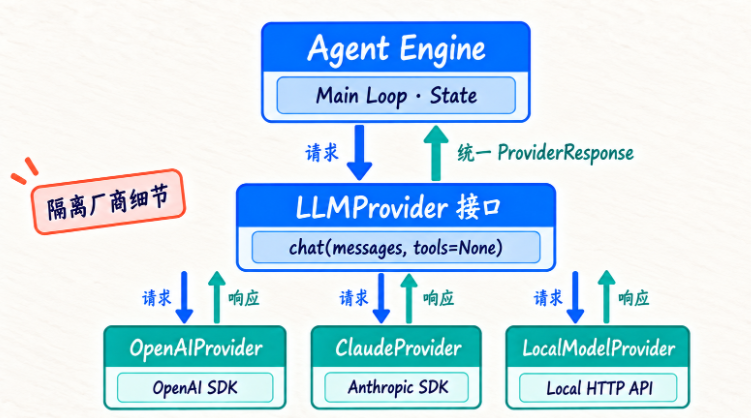
请求必须经过接口进入具体实现,响应也要先被适配成统一的 ProviderResponse 再返回。这样切换模型时,Main Loop 和 State 所在的上层就不必跟着认识新的厂商对象。
这句话后面会反复用到。
知识地图
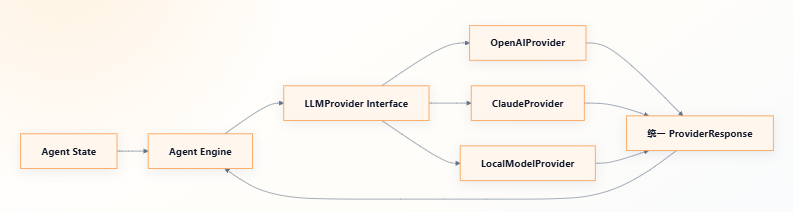
这一节在整个课程中的位置非常关键。前面我们已经有 Main Loop 和 State,现在要把“调用哪个模型”从 Loop 里抽出去。下一部分进入 Tool 系统以后,Tool Schema、Tool Call 也会经过 Provider 做适配。











请登录后查看评论内容