

先从最容易理解的“换模型”说起。
如果 Agent Engine 直接这样写:
from openai import OpenAI


class AgentEngine:
    def __init__(self):
        self.client = OpenAI()

    def think(self, messages):
        return self.client.responses.create(
            model="...",
            input=messages
        )
它当然能工作。
问题是,AgentEngine 已经知道 OpenAI 的 SDK 细节了。
这意味着:
- 知道客户端怎么初始化;
- 知道调用哪个方法;
- 知道参数名是什么;
- 知道返回对象长什么样;
- 知道工具调用怎么读取;
- 知道异常怎么捕获。
以后换 Provider,Agent Engine 就要改。
这叫“上层业务依赖下层具体实现”。
更理想的设计是:
class AgentEngine:
    def __init__(self, provider):
        self.provider = provider

    def think(self, messages):
        return self.provider.chat(messages)
现在 Engine 只知道,“我有一个可以 chat 的东西。”
至于这个东西背后是不是 OpenAI,完全不知道。
依赖抽象,而不是依赖实现
这其实是很经典的工程原则。
我们不是让:
Agent Engine → OpenAI SDK而是:
Agent Engine → LLMProvider具体实现再去依赖:
OpenAIProvider → OpenAI SDK
ClaudeProvider → Anthropic SDK
LocalModelProvider → Local HTTP API
这样依赖关系被切开。
Provider 要统一什么?
最基础至少统一四件事。
第一,输入。
例如:
messages
tools
第二,输出。
我们最好自己定义:
ProviderResponse而不是把 OpenAI 原始 Response 对象一路传到 Agent Engine。
第三,异常。
底层可能抛不同异常,但上层希望看到统一语义:
ProviderTimeoutError
ProviderRateLimitError
ProviderAuthError
ProviderUnavailableError
第四,能力信息。
有些模型支持:
Tool Calling
Vision
Structured Output
Long Context
有些不支持。
Provider 后面可以暴露能力。
不过“暴露能力”和“真正具备能力”是两回事。下面三张并列卡片列的是各项能力应有的实现证据:能传 Tool Schema 并保存调用 ID,才能可靠地承诺 Tool Calling;结构化输出与流式事件也各有自己的验收条件。
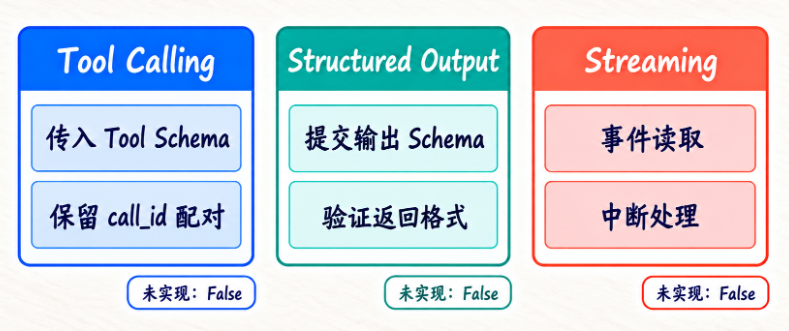
卡片下方的 False 表示“尚未实现时应如实关闭声明”,不是当前配套适配器的能力清单。本章后面会具体解释:某个响应结构里有 tool_calls 字段,并不自动证明这家模型支持工具调用。
先设计自己的内部消息格式
如果我们直接把某厂商的 Message 对象作为内部标准,还是会被绑住。
所以可以先用非常简单的结构:
from dataclasses import dataclass


@dataclass
class Message:
    role: str
    content: str
例如:
messages = [
    Message(
        role="user",
        content="帮我检查这个项目"
    )
]
后面 OpenAIProvider 自己转换。
ClaudeProvider 自己转换。
LocalModelProvider 自己转换。
ProviderResponse 也要统一
我们可以设计:
from dataclasses import dataclass, field
from typing import Any, Optional


@dataclass
class ProviderResponse:
    text: str = ""
    tool_calls: list[dict] = field(default_factory=list)
    finish_reason: Optional[str] = None
    usage: dict[str, Any] = field(default_factory=dict)
    raw: Any = None
现在 Agent Engine 看到的永远都是:
response.text
response.tool_calls
response.finish_reason
response.usage
而不是:
OpenAI 的某个字段
Claude 的 content block
本地模型的 response JSON
这叫“内部统一协议”。
课程示例为了读起来直观,会把主要文本字段写成 text;配套源码中的统一字段叫 content,与 Tool Calling 消息格式放在一起使用。字段叫什么并不是抽象的关键,关键是整个 Engine 只认一种内部名称。阅读示例时把 text 对应到项目里的 content 即可,不要在同一份实现里交替使用两个名字。
Provider 抽象到 Tool Calling 后,还要保留一次调用的身份。ToolCall 不能只有工具名和参数,支持工具协议的 Provider 通常还会返回 call_id。Harness 不需要理解这个 ID 是哪个厂商怎样生成的,但在发送 Tool Result 时必须原样带回,模型才能把结果和先前动作对应起来。
因此配套的 ToolCall 包含 name、arguments 和可选 call_id。OpenAI-compatible 适配器会从响应的 tool_calls[].id 解析它;手写的 CallableProvider 可以暂时不提供,Engine 会生成仅用于本轮消息配对的 ID。这个“可选”让离线 Fake Provider 保持简洁,同时保留真实协议需要的信息。
这里也别顺手做出另一个推断:数据结构里有 call_id,不代表所有模型都支持工具调用。是否向模型传入 Tool Schema,仍然要看 ProviderCapabilities.tool_calling,能力声明和消息字段解决的是两件不同的事。
现在把“内部格式进入不同厂商,再统一返回”的路画完整。左侧的 Message 只有 role 和 content,tools 是 chat() 的另一项可选输入;中间三个适配器是三种选择,并不是串行调用。
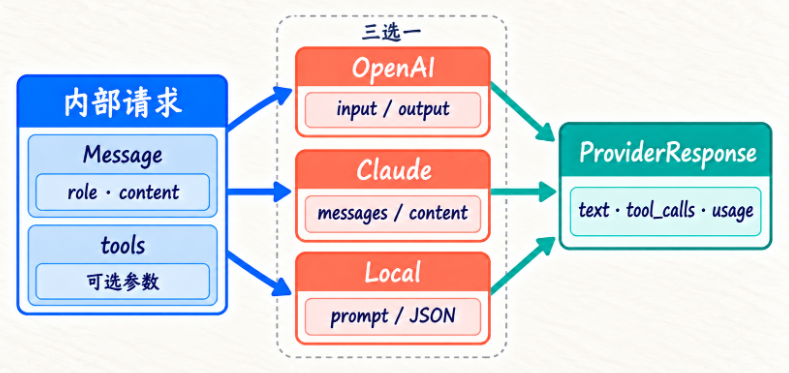
右侧的 ProviderResponse 是 Engine 读取的共同合同。某个 Provider 暂不支持工具时,相应工具请求可以为空;关键是不能把厂商原始结构直接穿透到 Engine。
一个完全可运行的抽象示例
先不用任何外部 API。
from abc import ABC, abstractmethod
from dataclasses import dataclass, field
from typing import Any, Optional


@dataclass
class Message:
    role: str
    content: str


@dataclass
class ProviderResponse:
    text: str = ""
    tool_calls: list[dict] = field(default_factory=list)
    finish_reason: Optional[str] = None
    usage: dict[str, Any] = field(default_factory=dict)


class LLMProvider(ABC):

    @abstractmethod
    def chat(
        self,
        messages: list[Message],
        tools: Optional[list[dict]] = None,
    ) -> ProviderResponse:
        raise NotImplementedError


class DemoProvider(LLMProvider):

    def chat(
        self,
        messages: list[Message],
        tools: Optional[list[dict]] = None,
    ) -> ProviderResponse:
        last_message = messages[-1]

        return ProviderResponse(
            text=f"DemoProvider 收到:{last_message.content}",
            finish_reason="stop",
            usage={
                "input_tokens": 10,
                "output_tokens": 8,
            },
        )


def run_agent_once(
    provider: LLMProvider,
    user_message: str,
) -> ProviderResponse:
    messages = [
        Message(
            role="user",
            content=user_message,
        )
    ]

    return provider.chat(messages)


if __name__ == "__main__":
    provider = DemoProvider()

    response = run_agent_once(
        provider,
        "解释 Agent Provider 是什么",
    )

    print(response.text)
    print(response.usage)
这个程序没有任何外部依赖,可以直接运行。
最重要的是:
run_agent_once()只依赖:
LLMProvider它不知道 DemoProvider 具体怎么实现。
这就是解耦的第一步。
核心小节二:设计 Provider Interface——接口应该“刚刚够用”,而不是把所有厂商参数揉成一个巨型方法
现在我们正式设计:
class LLMProvider:

    def chat(self, messages, tools=None):
        pass
这看起来很简单。
真正困难的是,这个接口到底应该放哪些东西?
很多人一上来会写:
def chat(
    messages,
    tools=None,
    temperature=0.7,
    top_p=0.9,
    max_tokens=4096,
    seed=None,
    response_format=None,
    thinking=None,
    cache=None,
    ...
):
    ...
然后越写越多。
问题是,不同 Provider 支持的参数根本不完全一样。
你为了“统一”,最后反而造出一个所有人都不完全适配的巨型接口。
更稳的思路是,统一 Agent 真正依赖的能力,不要强行统一所有厂商选项。
接口设计可以像图中这样收得很窄:chat(messages, tools=None) 服务于 Main Loop,模型名和超时放在 Provider 实例配置里,thinking、cache 一类专属选项则留在各自适配层。
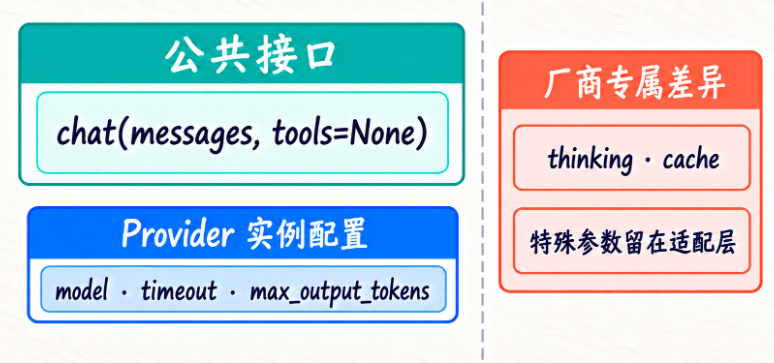
这不是说配置永远不能变化,而是不要让每次调用都背上所有厂商参数。随着真实需求出现再扩展公共合同,会比先做一个巨型方法更容易验证。
第一层:最小公共接口
可以是:
class LLMProvider(ABC):

    @abstractmethod
    def chat(
        self,
        messages: list[Message],
        tools: Optional[list[dict]] = None,
    ) -> ProviderResponse:
        ...
这已经足够让 Agent Main Loop 工作。
第二层:Provider 自己持有配置
例如:
OpenAIProvider(
    model=...,
    timeout=...
)
而不是每次 chat 都传 model。
因为 model 更像 Provider 实例配置。
例如:
class ProviderConfig:
    model: str
    timeout: float
    max_output_tokens: int
第三层:不要泄漏原始 SDK 对象
最典型的坏设计:
response = provider.chat(...)
print(response.output[0].content[0].text)
如果 Agent Engine 这样写,就说明抽象已经破了。
Engine 不应该知道原始返回结构。
应该:
response = provider.chat(...)
print(response.text)
统一响应的完整设计
from dataclasses import dataclass, field
from typing import Any, Optional


@dataclass
class ToolRequest:
    id: str
    name: str
    arguments: dict[str, Any]


@dataclass
class TokenUsage:
    input_tokens: int = 0
    output_tokens: int = 0


@dataclass
class ProviderResponse:
    text: str = ""
    tool_calls: list[ToolRequest] = field(default_factory=list)
    finish_reason: Optional[str] = None
    usage: TokenUsage = field(default_factory=TokenUsage)
    provider_name: str = ""
    model_name: str = ""
    raw: Any = None
为什么保留 raw?
有时候调试时需要查看原始响应。
但 Agent Engine 正常运行不应该依赖它。
这就是一个很实用的原则,raw 可以留作逃生舱,但不能成为主接口。
从返回对象的角度看,上层需要的是文本、工具请求、结束原因和用量这些标准化字段;raw 即便保留,也只适合调试时追溯具体厂商响应。
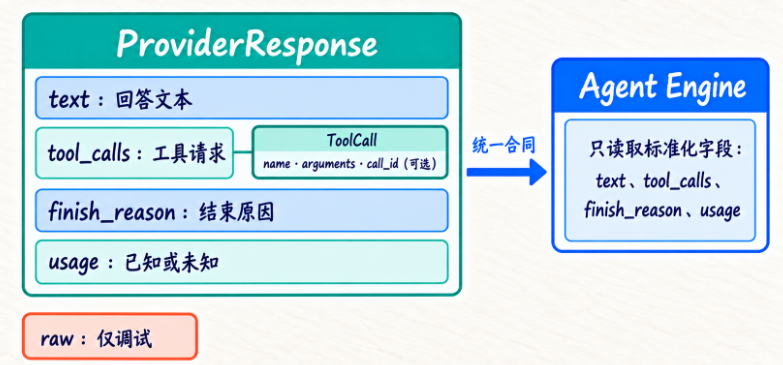
图中的 call_id 用于把工具结果配回原请求;离线 Fake Provider 可以暂时省略,但真实工具协议中的 ID 不能随意丢掉。usage 若没有返回,应标记未知或估算,别把“未知”展示为真实的 0。
Provider 的错误也应该统一
可以设计:
class ProviderError(Exception):
    pass


class ProviderAuthError(ProviderError):
    pass


class ProviderTimeoutError(ProviderError):
    pass


class ProviderRateLimitError(ProviderError):
    pass


class ProviderUnavailableError(ProviderError):
    pass
这样 Agent Engine 不需要写:
except 某厂商异常:只处理:
except ProviderTimeoutError:后面要做 Fallback 时就非常方便。
Provider 不应该负责什么?
这一点也要讲清楚。
Provider 不应该负责:
- Agent 什么时候停止;
- 下一步 Tool 是否安全;
- 是否需要人工审批;
- Working Memory 怎么更新;
- Tool 真正怎么执行;
- Session 怎么保存。
这些都不是“和模型说话”的职责。
Provider 只做三件事:
统一输入
 ↓
调用具体模型
 ↓
统一输出
必要时加:
统一异常
统一基础 usage
边界越清楚,后面越好维护。
Tool Calling 很能检验这条边界:Provider 只把模型意图翻译成统一的 ToolRequest;Harness 校验参数与审批要求,真正访问文件、数据库或 API 的仍是 Tool Executor。
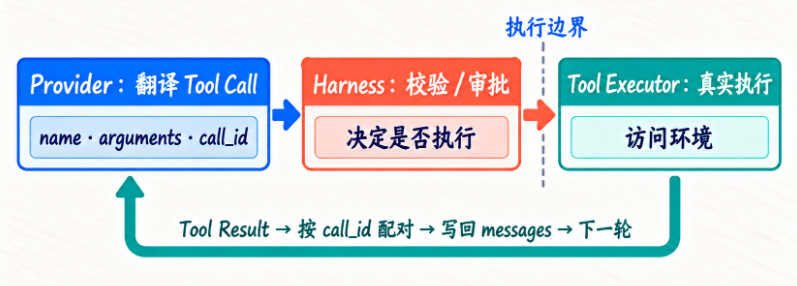
工具返回后,再按 call_id 配对结果并写回 messages,下一轮模型才会看到 Observation。图中的执行边界也说明了为什么 Provider 不该顺手接管工具权限控制。
一个完整“接口 + 两个假 Provider”示例
下面代码可以直接运行,也很适合你自己做单元测试。
from abc import ABC, abstractmethod
from dataclasses import dataclass
from typing import Optional


@dataclass
class Message:
    role: str
    content: str


@dataclass
class ProviderResponse:
    text: str
    provider_name: str
    model_name: str


class LLMProvider(ABC):

    @abstractmethod
    def chat(
        self,
        messages: list[Message],
        tools: Optional[list[dict]] = None,
    ) -> ProviderResponse:
        raise NotImplementedError


class FakeOpenAIProvider(LLMProvider):

    def __init__(self, model: str):
        self.model = model

    def chat(
        self,
        messages: list[Message],
        tools: Optional[list[dict]] = None,
    ) -> ProviderResponse:
        return ProviderResponse(
            text="这是 FakeOpenAIProvider 的回答",
            provider_name="openai",
            model_name=self.model,
        )


class FakeClaudeProvider(LLMProvider):

    def __init__(self, model: str):
        self.model = model

    def chat(
        self,
        messages: list[Message],
        tools: Optional[list[dict]] = None,
    ) -> ProviderResponse:
        return ProviderResponse(
            text="这是 FakeClaudeProvider 的回答",
            provider_name="anthropic",
            model_name=self.model,
        )


def agent_ask(
    provider: LLMProvider,
    question: str,
) -> str:
    messages = [
        Message(
            role="user",
            content=question,
        )
    ]

    response = provider.chat(messages)

    return (
        f"[{response.provider_name}/"
        f"{response.model_name}] "
        f"{response.text}"
    )


if __name__ == "__main__":
    openai_provider = FakeOpenAIProvider(
        model="model-a"
    )

    claude_provider = FakeClaudeProvider(
        model="model-b"
    )

    print(
        agent_ask(
            openai_provider,
            "什么是 Agent?",
        )
    )

    print(
        agent_ask(
            claude_provider,
            "什么是 Agent?",
        )
    )
你会发现:
agent_ask()完全没改。
只换:
provider这就是我们追求的结果。
















请登录后查看评论内容