

场景背景
业务问,“为什么昨天收入下降了?”
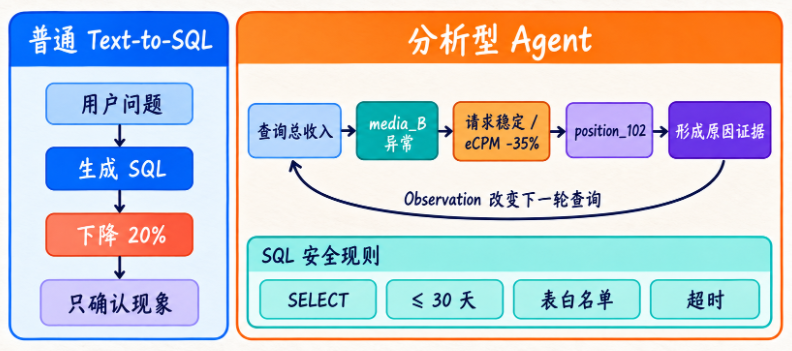
普通 Text-to-SQL 可能只执行一条:
查询昨天与前天总收入得到:
昨天:80 万
前天:100 万
这只能回答,“确实下降了 20%。”
并没有解释为什么。
问题矛盾
真正分析需要一层一层缩小范围:
总收入下降
 ↓
是哪个媒体?
 ↓
media_B
 ↓
是流量还是价格?
 ↓
请求稳定、eCPM 下降
 ↓
哪个广告位?
每一轮结论都依赖上一轮数据。
输入与前置条件
可用工具:
query_total_revenue
query_by_media
query_media_metrics
query_by_position
固定边界:
只允许查询近 30 天
只允许 SELECT
限制返回行数
解决过程
第一轮:
Action:
query_total_revenue()
Observation:
收入下降 20%第二轮:
Reason:
需要判断下降集中在哪里

Action:
query_by_media()
Observation:
media_A:-2%
media_B:-32%
media_C:+1%
第三轮:
Reason:
media_B 是主要异常点

Action:
query_media_metrics(media_B)
Observation:
请求:+1%
曝光:-3%
eCPM:-35%
第四轮:
Reason:
流量基本稳定,价格下降明显,需要继续看广告位

Action:
query_by_position(media_B)
Observation:
position_102 的 eCPM 降幅最大最终:
Finish这四轮查询形成了一条由总量到局部的证据链。每次 Observation 都缩小下一轮查询范围,最终把异常定位到具体媒体、指标和广告位。

图中请求量与曝光量基本稳定,而 eCPM 明显下滑,因此最终结论指向变现价格而非整体流量。下方的时间范围、只读查询和行数限制,也对应课程中对数据工具的安全约束。
输出结果
结论:
收入下降主要来自 media_B。
media_B 请求量基本稳定,但 eCPM 下降约 35%。
其中 position_102 的 eCPM 降幅最大。

因此当前证据更支持:
变现价格下降,而不是整体流量下降。
复盘与迁移
这就是 Main Loop 与“一次性生成 SQL”的区别。
真正的数据分析不是:
Question → SQL → Answer而是:
Question
 ↓
Action
 ↓
Observation
 ↓
Reason
 ↓
Next Action
 ↓
Next Observation
 ↓
Conclusion
后面的 Data Analysis Agent 会把这套 Loop 真正做成 Flask 服务。
常见误区
误解: Main Loop 就是把 llm.chat() 放进 while True,所以它其实很简单。
正解: 循环本身确实只有几行,但真正困难的是循环控制:每轮给模型看什么、Tool Call 如何解析、Tool Error 如何回传、什么时候结束、怎么避免重复、最大运行多少步、Observation 是否真的进入下一轮。一个没有这些控制的 while True 很容易变成“无限烧 Token”的循环。因此 Main Loop 的核心不是语法,而是决策闭环和边界管理。
误解: 模型已经生成 Tool Call,就说明 Tool 已经执行成功。
正解: Tool Call 只是模型产生的动作意图。真正执行工具的是 Harness。执行过程可能失败、超时、被权限拦截、返回空结果,甚至工具名本身不存在。只有 Harness 真正执行后拿到结果,我们才得到 Observation。因此必须区分“模型想做什么”和“环境实际发生了什么”。
误解: Tool 执行完以后,把结果打印出来就够了。
正解: 打印给开发者看,并不会自动让下一轮模型知道结果。Tool Result 必须被加入模型下一轮能看到的 Context,通常就是 messages 或由 Context Builder 组装进去。否则模型很可能重复请求同一个 Tool,因为在它看来上一轮根本没有得到任何反馈。Observation 回流,是 Agent Loop 能连续工作的关键。
误解: 有了完整 Planner,就不需要 Main Loop。
正解: Planner 只能给出初始计划,但真实环境可能随时打破计划,例如文件不存在、SQL 为空、测试失败、接口超时。Main Loop 的作用是每一轮都根据 Observation 修正行为。Planner 是一种增强能力,而 Main Loop 是运行底座。后面我们会专门讲 Plan,但不会用 Plan 替代反馈闭环。
误解: Tool 失败意味着 Agent 任务失败。
正解: Tool Error 本身也是 Observation。FILE_NOT_FOUND 可以推动 Agent 先 list_files,SQL 空结果可以让 Agent 换维度,测试失败可以让 Agent继续检查代码。真正成熟的 Harness 会尽量把可恢复错误结构化后反馈给模型,而不是让一个普通异常直接终止整个任务。当然,权限错误和高风险操作可能需要直接阻断,这属于后续安全控制。
误解: Agent 只要还想继续,就应该允许它一直执行。
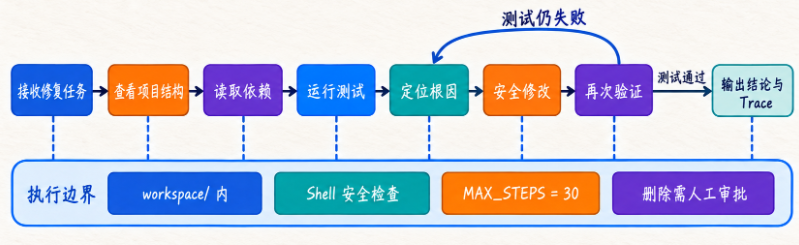
正解: LLM 决策具有概率性,任何 Loop 都必须有硬边界。最基础的是 MAX_STEPS,真实系统还会有 Timeout、Token Budget、Tool Call 上限和成本限制。即使模型认为“再查一点可能更好”,系统也必须有能力终止任务。Agent 的自主性永远是在 Harness 边界内的自主性。













请登录后查看评论内容