


题目 1:为什么最终项目不能只写成一个 agent.py 文件?
假设我们完全可以在一个 agent.py 中同时写 Flask Route、模型调用、工具执行、文件操作、Session 保存和日志记录,而且这个程序短期内也能运行。请解释为什么课程仍然要把它拆成 API、Agent、Tool、Memory、Tracing 等不同模块。回答时请从复用、测试、维护、权限和后续扩展几个角度分析。
单文件并不是“不能运行”,真正的问题是职责混在一起以后,系统会越来越难演进。Flask Route 应该只负责 HTTP 请求与响应;Agent Engine 负责执行循环;Tool 层负责真实动作;Memory 管理状态;Tracing 记录执行轨迹。拆开以后,CLI 也能复用同一个 Agent Engine,Tool 可以独立测试,安全校验可以统一放在 Middleware,而不需要每个 Route 重复实现。随着后面加入 Streaming、Session、SubAgent 和 Evaluation,如果仍然把所有代码堆在
agent.py中,修改一个模块很容易影响另一个模块,因此工程化分层本身就是 Harness 的一部分。
题目 2:判断题——LLM 可以直接执行 Python 函数,对吗?
有人说:“模型在 Tool Calling 里已经调用了 read_file(),所以文件其实是 LLM 读取的。”请判断这个说法是否正确,并完整说明 Tool Calling、Harness 和 Tool Execution 三者之间的关系。
这个说法不正确。LLM 通常只是生成一个结构化的工具调用意图,例如工具名是
read_file、参数是{"path":"app.py"}。真正接收这个结构、检查工具是否存在、校验参数、检查权限并执行 Python 函数的,是 Agent Harness。函数执行以后产生的文件内容或错误信息,再作为 Observation 返回给模型。也就是说,LLM 负责“决定想做什么”,Harness 负责“这个动作是否允许、如何执行”,Tool 才真正与外部环境交互。理解这层分工,是后面安全控制的基础。
题目 3:代码阅读——下面 Flask 写法有什么工程问题?
观察下面结构:
@app.post("/agent")
def agent():
    # 调模型
    # 解析 Tool
    # 执行 Shell
    # 管理上下文
    # 写 SQLite
    # 记录 Trace
    return {"ok": True}
请至少指出三个工程问题,并给出一个更合理的调用层次。
题目 4:编程实现——写一个最小的 Agent Harness 骨架
请不用真实大模型 API,写一个完整可运行的 Python 程序,包含 State → Decision → Action → Observation 循环。要求提供至少一个 Tool,并设置最大执行步数,最终能够输出一个明确结果。
下面是一种最小实现。我们用固定决策模拟 LLM,重点是把 Harness 的控制结构写完整:State 保存过程,Decision 产生动作,Tool 真正执行,Observation 更新状态,最大步数负责兜底。
from dataclasses import dataclass, field


@dataclass
class State:
    goal: str
    step: int = 0
    observations: list[str] = field(default_factory=list)


def get_project_name() -> str:
    return "agent-harness-demo"


def decide(state: State) -> dict:
    if state.step == 0:
        return {"action": "get_project_name"}

    return {
        "action": "finish",
        "answer": f"项目识别完成:{state.observations[-1]}"
    }


def run(goal: str, max_steps: int = 5) -> str:
    state = State(goal=goal)

    while state.step < max_steps:
        decision = decide(state)

        if decision["action"] == "get_project_name":
            result = get_project_name()
            state.observations.append(result)
            state.step += 1
            continue

        if decision["action"] == "finish":
            return decision["answer"]

    return "超过最大执行步数"


if __name__ == "__main__":
    print(run("识别当前项目"))
这段代码没有真实 LLM,但 Harness 结构已经存在。后面只要把
decide()替换为模型调用,再加入 Tool Registry、Context 和安全控制,就会逐步接近真正 Agent。
题目 5:综合应用——为什么一个 Data Analysis Agent 仍然需要固定 Workflow?
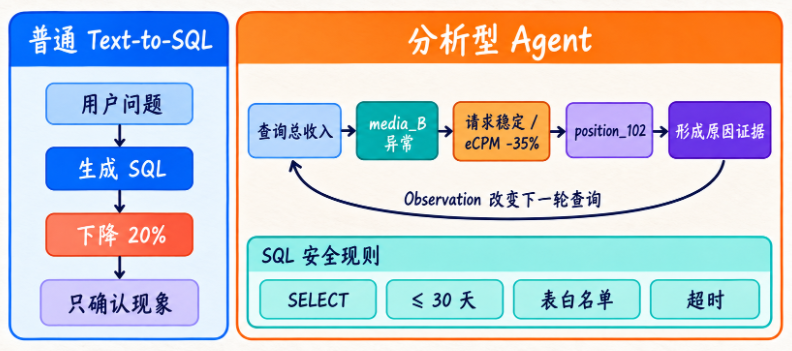
假设模型能够自己生成 SQL、执行 SQL、分析结果并继续下钻。既然已经这么智能,为什么我们还要额外做“查询时间限制、只允许 SELECT、表白名单、超时和审计日志”这些确定性规则?请解释 Agent 和 Workflow 在这个场景里的职责边界。
因为动态分析和系统安全是两类问题。模型适合决定“接下来按哪个维度查”“哪一个指标值得继续下钻”,这些动作高度依赖语义和上一轮结果;但查询时间限制、只读 SQL、表权限、超时和审计属于稳定业务规则,必须由确定性程序保证。不能让模型自己判断“这次是否允许 DROP TABLE”。因此成熟设计通常是 Workflow / Middleware 负责边界,Agent 负责受控范围内的动态决策。两者组合后既保留 Agent 灵活性,也保留系统可控性。
题目 6:对比分析——“会聊天”和“会做事”的系统差在哪里?
请比较普通 Chatbot 与本课程要做的 Agent Harness。要求至少从执行环境、Tool、Observation、State、任务持续时间和服务化六个方面进行说明,不要只回答“Agent 可以调用工具”。查看参考答案
普通 Chatbot 的核心通常是一次或多轮文本输入输出,它可能保存对话历史,但不一定真正操作外部环境。Agent Harness 则需要把模型决策变成真实 Action,通过 Tool 读取文件、执行代码或查询数据,再把结果作为 Observation 返回模型。因为任务可能跨越很多 Step,所以还需要 State 管理当前过程;因为任务可能持续几十秒甚至更久,所以需要 Run、状态与 Streaming;因为它要被网页或其他系统调用,所以还需要 Flask API 等服务边界。两者最大差别不是“能不能说得更聪明”,而是是否具备受控执行闭环。
题目 7:概念理解——为什么这门课强调“先手搓,再用框架”?
请解释这种学习顺序的价值,并说明它不等于“拒绝成熟框架”。如果后续真正工作中使用 LangChain、LangGraph 或其他框架,前面手写 Main Loop、Tool Registry、Context 和 Tracing 的经历会带来什么帮助?
先手搓的价值在于建立稳定心智模型。我们亲手写过 Main Loop,就知道框架里的 Executor 为什么需要循环;写过 Tool Registry,就知道工具注册和参数 Schema 解决什么问题;处理过 Context,就能理解为什么框架需要状态与压缩;实现过 Tracing,就知道 Agent 出错时应该查什么。之后使用成熟框架,不再只是记 API,而是能够判断框架提供了哪些抽象、哪些默认行为适合自己的系统。手写是为了理解,框架是为了提高生产效率,两者并不冲突。
进一步阅读
- ReAct: Synergizing Reasoning and Acting in Language Models:非常适合建立“Reason → Action → Observation”这一经典 Agent 循环的直觉。
- OpenAI Tools / Function Calling 文档:重点观察模型如何表达工具调用意图,不必在开篇阶段记住所有 API 参数。
- Flask 官方 Quickstart:用于提前熟悉路由、请求、JSON 响应等最基本服务化概念,后面我们会围绕 Agent 场景重新组织。
- LangGraph Concepts:推荐等学完 Main Loop 和 State 后再看,会更容易理解为什么 Agent 常被建模成有状态图。
- Temporal Workflow Concepts:适合观察生产级长任务系统如何看待状态、重试、失败恢复和持久化。
- Agent Observability / Tracing 相关资料:先建立“每一步都应该可追踪”的意识,后面会专门实现自己的 Tracer。
- Python
dataclasses官方文档:后续我们会频繁使用数据类表达 Agent State、Tool Result、Run 等结构。 - SQLite 官方文档或 Python
sqlite3文档:后面服务化阶段会用它保存 Session、Run、Step 与 Trace。
术语表
- 智能体承载层(Agent Harness):围绕 LLM 构建的一套运行基础设施,负责把模型的决策连接到真实工具、状态、上下文、安全、日志和服务接口。它是本课程真正要亲手实现的主体。
- 大语言模型(Large Language Model, LLM):在 Agent 系统中主要承担理解任务、分析上下文和选择下一步动作的角色。它很重要,但不是整个 Agent,外部执行与控制仍然需要 Harness。
- 工具(Tool):Agent 可以请求执行的外部能力,例如读取文件、执行 Python、运行 Shell、查询数据库。Tool 必须由程序真实执行,而不是由模型“想象执行”。
- 工具调用(Tool Call):模型生成的结构化动作意图,通常包含工具名称和参数。Harness 会解析 Tool Call、做参数和权限检查,再决定是否允许真正执行对应 Tool。
- 观察结果(Observation):Tool 执行以后得到的真实反馈,例如文件内容、命令输出、错误信息、SQL 结果。Observation 会进入下一轮 Context,帮助模型调整后续决策。
- 状态(State):Agent 多步执行过程中需要持续保存的信息,包括目标、当前 Step、消息、工具历史、错误、任务状态等。没有 State,就很难构建可持续、可恢复的 Agent 执行过程。
- 上下文(Context):每次调用模型时提供给它的有效信息集合,可能包括 System Prompt、用户任务、历史消息、Memory、Tool Result 和当前状态。Context 的质量直接影响 Agent 决策。
- 运行实例(Run):一次具体 Agent 任务的执行记录。它通常拥有唯一
run_id,并记录开始时间、结束时间、状态、Step、错误和 Trace,是服务化 Agent 的重要概念。 - 追踪(Tracing):记录 Agent 每一步模型调用、Tool Call、Tool Result、耗时、Token 与状态的机制。它让我们能够复盘 Agent 为什么做出某个动作,也是后续 Evaluation 的基础。
- Server-Sent Events(SSE):一种服务器向浏览器持续推送事件的技术。后面我们会用它把 Agent 的执行进度实时展示给前端,而不是让用户一直等待最终响应。
本章总结
这一节我们没有急着教你调用任何 Agent 框架,而是先把整门课的终点摆在桌面上。
我们最终要造的不是一个简单的“LLM 聊天脚本”,而是一套真正能够执行任务的 Agent Harness。它会通过 Flask 接收外部请求,把任务交给 Agent Engine;模型根据当前 Goal、State 和 Context 决定下一步动作;Harness 解析 Tool Call、检查权限并执行真实工具;Tool 返回 Observation;Observation 再进入下一轮决策;这个循环一直持续到任务完成、失败、超时或等待人工确认。
这条链路里,LLM 很重要,但它只是其中一个组件。
真正决定系统能不能从 Demo 走向工程的,是周围这些能力:
Main Loop
State
Tool Registry
Context
Memory
Session
Run
Middleware
Safety
Human Approval
Tracing
Evaluation
Flask API
所以这门课不从 LangChain 开始,并不是因为框架没有价值,而是因为我们希望先知道框架替我们做了什么。只有亲手写过最小 Loop、自己实现 Tool Registry、自己处理过 Tool Error、自己碰过 Context 变长和状态管理问题,后面再看到任何框架,你才有能力判断它的抽象是不是适合你的项目,而不是只能照着示例复制。
这一节最容易犯的错有两个。
第一个,是把“LLM”直接等同于“Agent”。实际上模型只负责决策,真实 Action 仍然必须由程序执行。
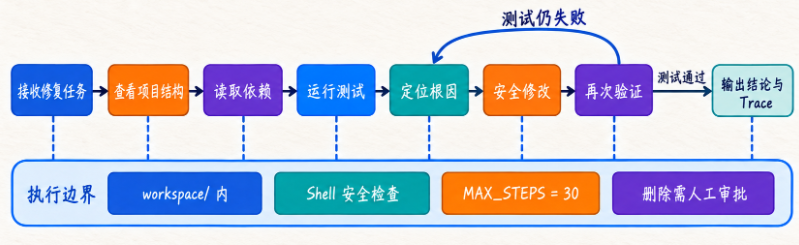
第二个,是把“自主”理解成“无限权限”。真正成熟的 Agent 不是越自由越好,而是在 Harness 设定的安全边界内拥有动态决策空间。路径限制、SQL 安全、最大步数、超时、审批、审计,这些确定性东西都应该留在程序里。
如果你想验证自己已经学会这一节,可以不看上面的图,自己拿纸画一遍:
用户
 ↓
Flask
 ↓
Agent Harness
 ↓
LLM
 ↓
Tool Call
 ↓
Tool
 ↓
Observation
 ↓
LLM
然后尝试解释每一个箭头是谁负责的、为什么存在。
如果你能进一步说清,“为什么 Flask 不应该和 Agent Loop 混在一起?”
“为什么 Tool Call 不等于 Tool 已经执行?”
“为什么 Agent 必须保存 State?”
“为什么 Tool Result 必须回到 Context?”
那么这一节最重要的地基就已经搭好了。
接下来,我们进入第1部分:真正理解 Agent。
第 02 节会专门解决一个很多人第一次做 Agent 都会问的问题,既然以前已经有 Chain、DAG 和 Workflow,为什么还需要 Agent?
我们会从固定执行路径开始,一直讲到运行时动态决策。等这个问题想明白以后,再进入 Main Loop,代码就不会只是“照着写”,而是在实现你已经理解的机制。













请登录后查看评论内容