

上一节我们已经把 Chain、DAG、Workflow 和 Agent 的差别讲清楚了。真正决定 Agent 味道的,不是“有没有大模型”,也不是“有没有工具”,而是模型是否能够在运行过程中,根据当前任务和执行反馈,继续决定下一步。
这一节我们就把这个“继续决定下一步”真正写成代码。
学完以后,你应该能做到:
- 看懂一个 Agent 为什么不是一次
llm.chat()调用,而是一个持续运行的决策循环。 - 能把
Reason → Action → Observation → Reason从概念翻译成真正的 Python 控制流。 - 能解释 Tool Call 为什么只是模型给出的“动作意图”,真正执行必须由程序完成。
- 能手写一个最小 Agent Loop,让它连续完成“看目录 → 读文件 → 根据结果继续判断 → 最终回答”这类多步任务。
- 能知道一个 Main Loop 最少需要哪些防护:停止条件、最大步数、异常结果回传和重复动作控制。
这一节可以沿着一条线往下读
Main Loop 看起来像一个 while,真正需要理解的却不是循环语法,而是信息怎样走完一圈。我们会依次回答四个问题:模型根据什么决定下一步,Tool Call 由谁执行,执行结果怎样回到下一轮,以及循环凭什么结束。
阅读代码时,可以先盯住这四个变量,不必一开始就展开所有类:
messages   当前交给模型的信息
response   模型这一轮给出的决定
result     工具在真实环境中的执行结果
step       循环已经推进了多少轮
只要能说清它们在一轮中怎样变化,Main Loop 的骨架就立住了。Tool Registry、State、Context Builder 和 Tracing 暂时可以看成后面要装上去的组件;这一节先把发动机转起来。
开场引入
如果上一节我们只是知道了 Agent 与 Workflow 的本质差别,那么这一节,就是整门课第一次真正碰到 Agent 的“发动机”。
很多人刚开始写 Agent 时,最容易把它想成这样:
用户问题
  ↓
LLM
  ↓
最终答案
这个结构当然很常见,而且很多聊天机器人本来就是这么工作的。
但你仔细想一下,如果用户提出的是,“帮我检查这个 Python 项目为什么启动失败。”
模型第一次调用时,手里可能只有一句用户任务。它并不知道项目目录结构,也没看过 app.py,更不知道测试会报什么错。
它最多能说,“我想先看看项目文件。”
问题来了。
它“想看”,然后呢?
它自己并不能直接打开你的磁盘。
于是模型需要产生一个动作:
Action:
list_files()
Python 程序真正执行以后,得到:
Observation:
["README.md", "pyproject.toml", "src/main.py", "tests/"]
模型这时才知道,“原来入口可能在 src/main.py,那我下一步应该先读它。”
于是第二轮:
Action:
read_file("src/main.py")
执行后又得到:
Observation:
from flask import Flask
import requests
...
模型继续判断,“我还要看看 pyproject.toml 有没有声明 requests。”
于是第三轮。
你会发现,这个任务不是“模型一次回答”完成的,而是:
模型判断
  ↓
执行动作
  ↓
拿到真实结果
  ↓
把结果重新交给模型
  ↓
模型继续判断
不断循环。
这就是 Main Loop。
最朴素的代码,甚至可以写成:
while True:

    response = llm.chat(messages)

    if response.tool_call:
        result = execute_tool(response.tool_call)
        messages.append(result)
    else:
        return response.answer
这段代码是用来观察控制流的骨架,还不是可以直接放进真实服务的版本。它暂时省略了最大步数、异常处理、调用 ID、超时和重复检测。这里先看清“结果如何回流”,后面再逐层补护栏;如果一开始就把所有工程细节塞进来,反而容易看丢循环本身。
看起来只有几行,但它其实藏着 Agent 最关键的机制。
llm.chat(messages) 负责做决策。
response.tool_call 表示模型认为当前还不能直接结束,它希望先执行一个动作。
execute_tool(...) 负责真正与环境交互。
messages.append(result) 则把真实世界反馈重新放回模型上下文。
下一轮 llm.chat(messages) 时,模型看到的不再只是用户最开始说的话,还看到了刚才的工具结果。
于是路径开始“长出来”。
这就是:
Reason
  ↓
Action
  ↓
Observation
  ↓
Reason
所以这一节特别重要。
如果 Main Loop 没理解,后面学习 Tool Registry、Context Builder、Memory、Planner、SubAgent、Tracing,很容易把它们看成一堆分散模块。
但只要 Main Loop 理解了,你会发现后面几乎所有模块都是在回答,“怎么让这个循环运行得更稳、更安全、更聪明、更可观察?”
State 是为了让 Loop 知道自己做到哪一步。
Tool Registry 是为了让 Loop 能执行不同动作。
Context 是为了决定每一轮给模型看什么。
Memory 是为了让 Loop 不要每次从零开始。
Middleware 是为了在 Tool 真正执行前加控制。
Tracing 是为了把每轮发生了什么完整记录下来。
Evaluation 是为了判断这个 Loop 最终到底做得好不好。
因此,这一节确实是整门课程最重要的一节之一。
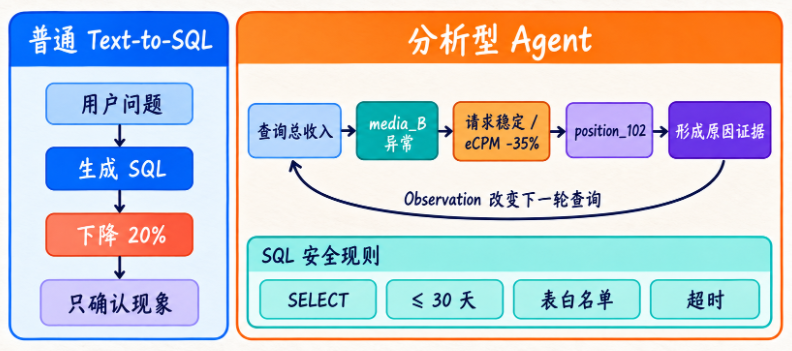
先把“一次调用”和真正的 Main Loop 并排看一遍。左侧的链路在模型回答后立刻结束;右侧则会把工具返回的 Observation 写回 messages,再带着新增证据进入下一轮。

右侧那条回到上下文的反馈箭头,正是 Agent 能够持续行动的关键:每一轮都不是原地重来,而是在上一轮结果之上重新决策。
知识地图
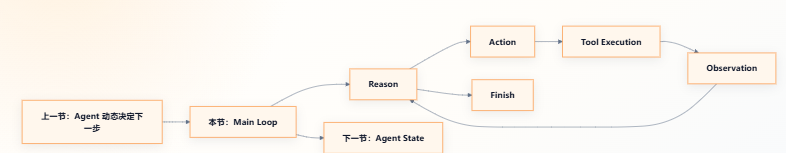
这一节承接上一节“动态决策”的概念,把它真正落成一个运行闭环。下一节我们会进一步把 Loop 里的状态抽出来,形成正式的 Agent State。













请登录后查看评论内容