

我们先从 Chain 开始。
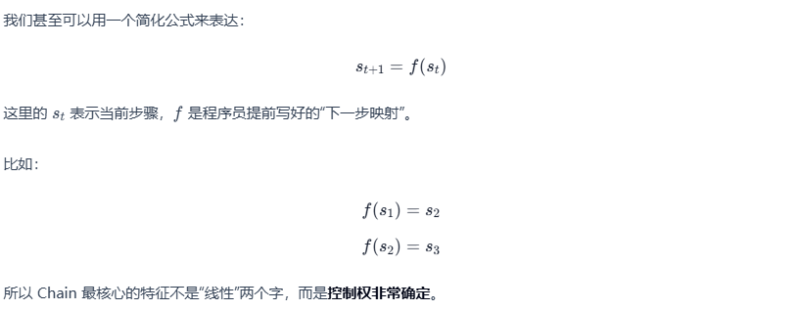
Chain 的直觉非常简单:一件事做完,接着做下一件。
例如:
读取 CSV
  ↓
去重
  ↓
填补缺失值
  ↓
计算指标
  ↓
输出结果这里最重要的不是“有几个步骤”,而是,下一步在任务开始前已经知道。
只要第一步完成,就一定执行第二步;第二步完成,就一定执行第三步。
我们写一个最简单的 Python 例子:
def normalize_text(text: str) -> str:
    return " ".join(text.lower().split())


def count_words(text: str) -> int:
    return len(text.split())


def build_result(text: str, word_count: int) -> dict:
    return {
        "normalized_text": text,
        "word_count": word_count
    }


def run_chain(raw_text: str) -> dict:
    normalized = normalize_text(raw_text)
    word_count = count_words(normalized)
    result = build_result(normalized, word_count)
    return result


if __name__ == "__main__":
    user_text = "Agent   Harness   Is   Interesting"
    print(run_chain(user_text))
运行结果:
{'normalized_text': 'agent harness is interesting', 'word_count': 4}这个例子没有任何神秘的地方,但它非常适合帮助我们理解 Chain。
执行结构就是:
raw_text
  ↓
normalize_text
  ↓
count_words
  ↓
build_result
  ↓
return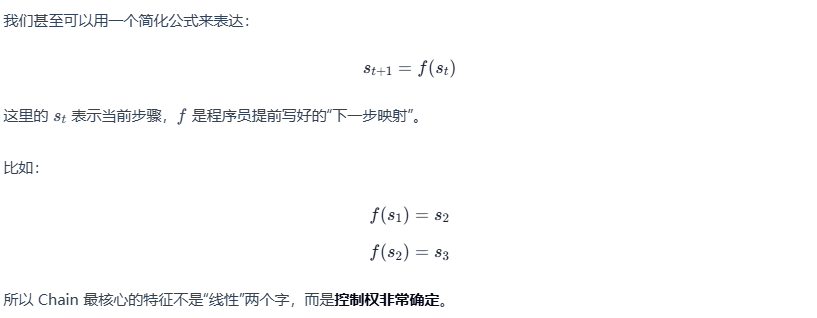
为什么 Chain 反而很可靠?
很多同学学了 Agent 以后,会下意识觉得固定流程“太传统”。
但真实工程里,确定性就是价值。
Chain 有几个非常实用的优点。
第一,容易测试。
每一步输入输出都很明确。
第二,容易估算成本。
执行几步、调用几次接口、运行多久,大致可控。
第三,容易定位错误。
如果第三步挂了,我们就查第三步。
第四,容易审计。
尤其是数据处理、支付、审批、风控,流程越确定越让人放心。
所以如果任务本来就是:
A → B → C你却改成:
 A
 ↓
LLM 思考一下
 ↓
也许 B
 ↓
再思考一下
 ↓
可能 C
这不是“更智能”,而是在主动引入不确定性。
用了 LLM,也仍然可能只是 Chain
这是初学者特别容易混淆的一点。
假设我们做一个文章处理流程:
原文
  ↓
LLM 摘要
  ↓
LLM 分类
  ↓
LLM 生成标题
  ↓
输出
这里用了三次大模型。
是不是 Agent?
不是。
因为:
摘要 → 分类 → 标题顺序仍然是程序员提前写死的。
我们可以写成:
def fake_llm_summary(text: str) -> str:
    return f"摘要:{text[:20]}..."


def fake_llm_category(summary: str) -> str:
    return "技术"


def fake_llm_title(summary: str, category: str) -> str:
    return f"{category}文章:Agent 学习笔记"


def run_llm_chain(text: str) -> dict:
    summary = fake_llm_summary(text)
    category = fake_llm_category(summary)
    title = fake_llm_title(summary, category)

    return {
        "summary": summary,
        "category": category,
        "title": title
    }


if __name__ == "__main__":
    article = "Agent 的核心不是简单调用模型,而是根据状态动态决定下一步。"
    print(run_llm_chain(article))
这里的 LLM 只是“节点执行器”。
它并没有决定,“摘要做完以后,我觉得信息不够,我先去搜索一下。”
也没有决定,“这个任务不需要分类,我直接生成标题。”
因此,这仍然是 Chain。
这给我们一个特别重要的判断,有没有 LLM,不是判断 Agent 的标准。
真正要看的是,LLM 有没有进入控制路径。
下面这张图把这个判断说得很直白。即使连续调用三次 LLM,只要摘要、分类、生成标题的顺序仍由程序预先安排,模型就只是每个节点里的执行器。
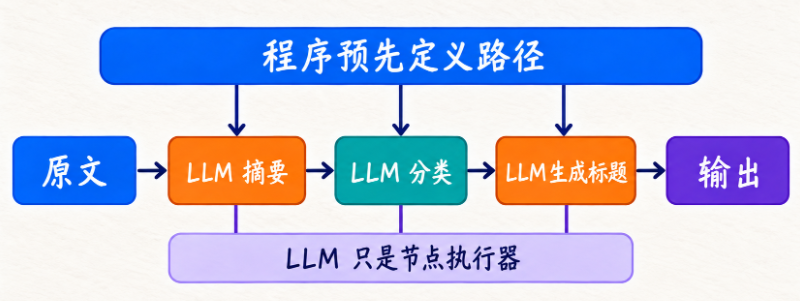
这里没有可选动作,也没有 Observation 反馈回来改变下一步,因此它依旧是一条固定 Chain。判断 Agent 时,我们要看的不是流程里有多少个模型,而是模型有没有获得选择路径的权力。
Chain 什么时候开始不够用?
我们再看一个故障诊断流程:
查 CPU
  ↓
查内存
  ↓
查磁盘
  ↓
查网络
  ↓
输出结论
如果所有故障都按这个模板检查,Chain 当然能跑。
但如果真实故障是,数据库连接池耗尽。
前四步可能全部正常。
这时固定 Chain 的问题不是“执行失败”,而是路径与真实问题不匹配。
你可以继续加:
查数据库
查线程池
查依赖服务
查最近发布
查日志
……
最后变成一个超级长 Chain。
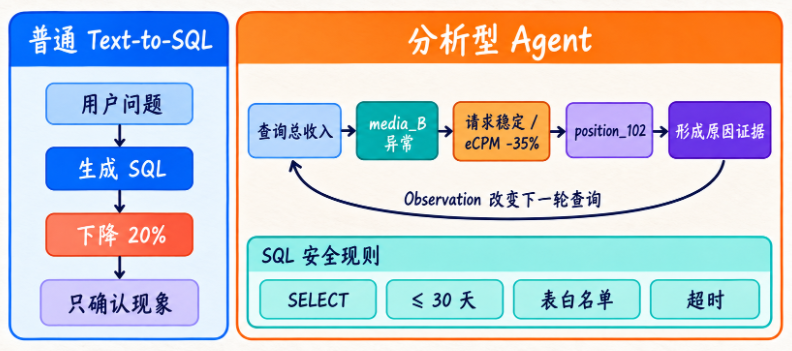
这就开始暴露固定路径的边界,只要你无法提前确定“下一步最值得查什么”,固定 Chain 就会越来越低效。
但注意,我们还没有直接跳到 Agent。
因为中间还有 DAG 和 Workflow。
它们可以处理大量“流程复杂但仍然可提前设计”的情况。













请登录后查看评论内容