

Chain 是一条线。
但真实工程里,很多任务不是线性的。
例如一个模型训练任务:
              ┌→ 数据质量检查 ─┐
数据加载 ─────┼→ 特征统计 ─────┼→ 模型训练
              └→ 标签检查 ─────┘
数据质量检查、特征统计、标签检查可以并行,只有它们全部完成以后才能训练。
这时 Chain 虽然也能做,但表达得不够自然。
DAG,也就是 Directed Acyclic Graph,有向无环图,就很适合描述这种依赖。
我们可以抽象成:
      → B →
A           → E
      → C → D
A 完成以后,B 和 C 可以同时做。
C 完成以后才能做 D。
B 和 D 都完成以后才能做 E。
DAG 解决的是“依赖复杂”,不是“路径未知”
这句话特别重要。
DAG 可以很复杂。
节点可以有几十个、几百个。
可以并行、分叉、汇合。
但它依然有一个前提,节点和边大体上在执行前就已经确定。
是谁定义的?
还是开发者。
我们知道有哪些任务,知道谁依赖谁,也知道什么时候应该开始下一个节点。
下面用标准库模拟一个简单 DAG:
from concurrent.futures import ThreadPoolExecutor


def check_quality(data: list[int]) -> str:
    return f"质量检查完成,共 {len(data)} 条数据"


def calc_statistics(data: list[int]) -> str:
    avg = sum(data) / len(data)
    return f"均值={avg:.2f}"


def check_range(data: list[int]) -> str:
    return f"最小值={min(data)},最大值={max(data)}"


def train_model(results: list[str]) -> str:
    return "训练开始,前置检查:" + " | ".join(results)


def run_dag(data: list[int]) -> str:
    with ThreadPoolExecutor(max_workers=3) as executor:
        futures = [
            executor.submit(check_quality, data),
            executor.submit(calc_statistics, data),
            executor.submit(check_range, data),
        ]
        results = [future.result() for future in futures]

    return train_model(results)


if __name__ == "__main__":
    dataset = [10, 20, 30, 40, 50]
    print(run_dag(dataset))
这里三个检查并行执行。
全部结束以后进入训练。
它已经比 Chain 更灵活,但仍然不是 Agent。
为什么?
因为不管数据是什么:
质量检查
统计
范围检查
训练
都会执行。
模型并不会在看到统计结果以后突然决定,“方差异常,我临时增加一个异常值分析步骤。”
除非我们提前把这个分支写进去。
Workflow 比 DAG 更贴近业务
实际业务中,我们不只需要依赖,还需要:
- if/else;
- 状态;
- 重试;
- 审批;
- 超时;
- 人工节点;
- 异常分支。
所以通常会再往上抽象成 Workflow。
例如退款:
这是典型 Workflow。
它有分支。
甚至运行时才知道走哪条分支。
但注意,所有分支仍然是提前定义好的。
我们可以写成:
def refund_workflow(
    order_status: str,
    amount: float,
    manager_approved: bool,
) -> str:
    if order_status != "paid":
        return "拒绝退款:订单状态不允许"

    if amount <= 10000:
        return "自动退款"

    if manager_approved:
        return "主管审批通过,执行退款"

    return "等待或拒绝退款"


if __name__ == "__main__":
    print(refund_workflow("paid", 8000, False))
    print(refund_workflow("paid", 15000, True))
这就是一个很重要的区分,Workflow 可以动态分支,但它的动作空间与规则空间通常是提前定义的。
“复杂”不等于“需要 Agent”
这个误区必须在这里彻底拆掉。
有些系统非常复杂,但依然应该坚决使用 Workflow。
例如:
- 支付;
- 风控;
- 审批;
- 订单状态流转;
- 数据治理流程;
- 生产发布流程。
它们可能有很多节点、很多异常处理、很多人工审核,但核心流程必须确定。
反过来,有些任务看起来很简单,“帮我修这个 Bug。”
只有一句话。
却高度适合 Agent。
因为“修 Bug”背后的调查路径无法提前列完整。
所以判断是否需要 Agent,不应该看,“流程复杂不复杂?”
而应该看,运行时是否需要大量开放式语义决策?
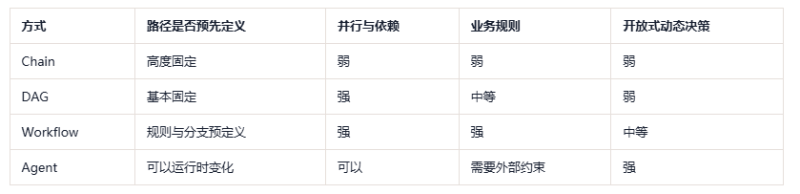
我们可以用一个表快速比较:
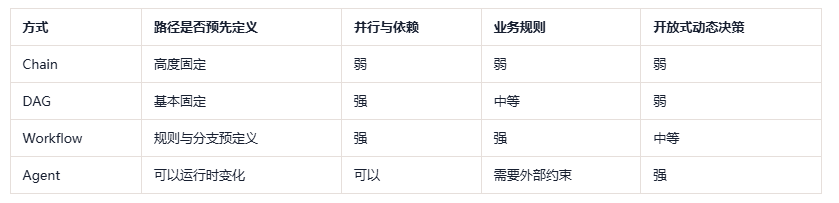
这里 Workflow 的“动态”与 Agent 的“动态”必须再区分一下。
Workflow:
if score > 0.8:
    do_a()
else:
    do_b()
虽然运行时才知道走 A 还是 B,但 A/B 两条路已经写好了。
Agent 则可能面对:
错误日志
 ↓
模型判断:
- 读配置?
- 查依赖?
- 搜索代码?
- 运行测试?
- 查看目录?
它从多个动作里根据语义选择下一步。
这才是 Agent 真正进入舞台的位置。
如果把“流程复杂度”和“路径不确定性”拆成两个维度,很多架构争论会立刻简单下来:
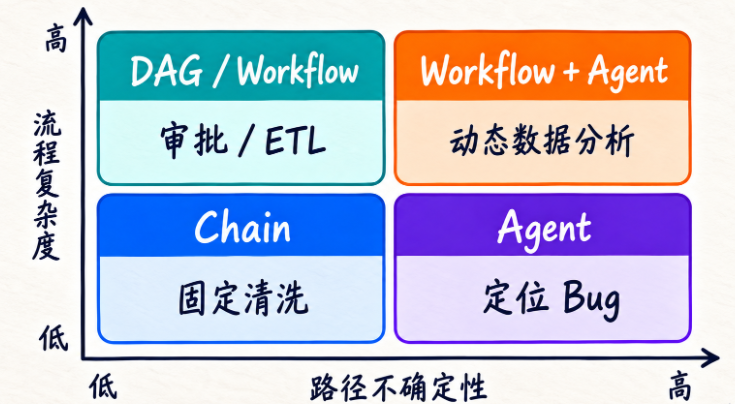
左上角的审批与 ETL 可以很复杂,但路径不确定性低,DAG 或 Workflow 反而更稳;定位 Bug 看起来只是一句话,却因为调查路径未知而适合 Agent。真正推动我们引入 Agent 的,通常不是节点变多,而是执行前无法确定最值得走的路径。














请登录后查看评论内容