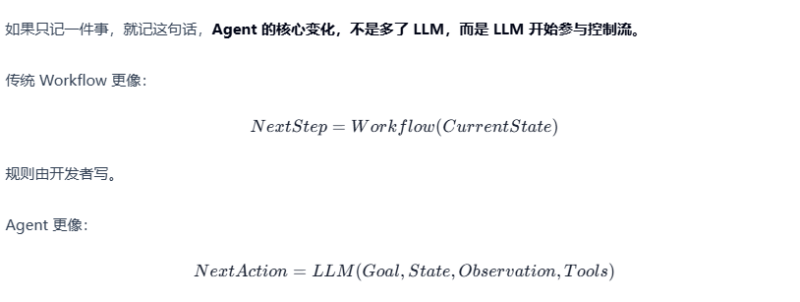


现在我们正式进入 Agent。
先看一个最短版本:
当前状态
   ↓
LLM 判断下一步做什么
   ↓
Action
   ↓
执行
   ↓
Observation
   ↓
再次判断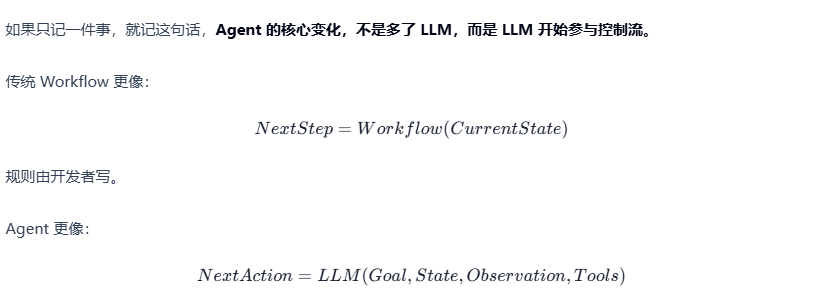
这里有四个关键输入。
Goal:最终要完成什么。
State:现在执行到哪里。
Observation:刚刚发生了什么。
Tools:目前有哪些动作可以选择。
模型不是单纯回答问题,而是在这些信息基础上决定下一步。
Observation 为什么这么重要?
我们举个最典型的例子。
模型决定:
Action:
read_file("app.py")
工具执行以后返回:
Observation:
FILE_NOT_FOUND
如果是固定 Workflow,可能下一步仍然照计划:
继续读取 requirements.txt但 Agent 可以重新判断,app.py 不存在,那我应该先看目录结构。
于是下一步变成:
Action:
list_files()
结果发现:
src/main.py再继续:
Action:
read_file("src/main.py")
这就是“环境反馈改变下一步”。
也是 Agent 与一次性计划最大的区别。
把刚才的文件读取过程展开以后,Observation 的作用会更加直观:
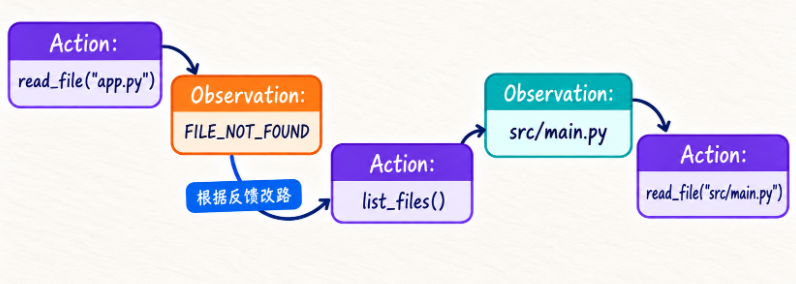
FILE_NOT_FOUND 不是一句需要记录下来就结束的报错,而是下一轮决策的新输入。Agent 因此放弃继续猜入口文件,先调用 list_files() 获取真实目录,再转向 src/main.py。所谓动态决策,落到代码里就是这一次次“根据真实反馈改路”。
一个最小 Agent 骨架
我们先不接真实 LLM。
先写一个“模拟决策器”,把结构看清楚。
from dataclasses import dataclass, field
from typing import Any


@dataclass
class AgentState:
    goal: str
    step: int = 0
    observations: list[str] = field(default_factory=list)
    finished: bool = False


def list_files() -> list[str]:
    return [
        "src/main.py",
        "requirements.txt",
        "README.md",
    ]


def read_file(path: str) -> str:
    fake_files = {
        "src/main.py": "from flask import Flask\nimport missing_package",
        "requirements.txt": "Flask==3.0.0",
        "README.md": "Run: python3 src/main.py",
    }
    return fake_files.get(path, "FILE_NOT_FOUND")


def decide_next_action(state: AgentState) -> dict[str, Any]:
    if state.step == 0:
        return {"action": "read_file", "path": "app.py"}

    if state.step == 1:
        last = state.observations[-1]
        if "FILE_NOT_FOUND" in last:
            return {"action": "list_files"}

    if state.step == 2:
        return {"action": "read_file", "path": "src/main.py"}

    if state.step == 3:
        return {"action": "read_file", "path": "requirements.txt"}

    return {
        "action": "finish",
        "answer": "src/main.py 导入 missing_package,但 requirements.txt 未声明该依赖。"
    }


def run_agent(goal: str, max_steps: int = 10) -> str:
    state = AgentState(goal=goal)

    while not state.finished and state.step < max_steps:
        decision = decide_next_action(state)
        action = decision["action"]

        if action == "read_file":
            result = read_file(decision["path"])
            state.observations.append(
                f'read_file("{decision["path"]}") -> {result}'
            )
            state.step += 1
            continue

        if action == "list_files":
            result = list_files()
            state.observations.append(f"list_files() -> {result}")
            state.step += 1
            continue

        if action == "finish":
            state.finished = True
            return decision["answer"]

    return "任务未在最大步数内完成"


if __name__ == "__main__":
    print(run_agent("检查项目为什么启动失败"))
这段代码的 decide_next_action() 依然是我们写死的,所以它还不是真正由 LLM 驱动的 Agent。
但它已经把 Agent 结构拆得非常清楚:
下一节讲 Main Loop 时,我们会真正把这里抽象成可扩展结构。
Agent 的核心不是 Tool Calling
我们必须再强调一次。
很多资料会把 Agent 简化成,LLM + Tools
这个说法方便,但不够准确。
普通 Workflow 也能调用工具。
例如:
def workflow():
    data = query_database()
    result = analyze_data(data)
    send_email(result)
这里也有:
- 数据库工具;
- 分析工具;
- 邮件工具。
但路径写死了:
查数据库 → 分析 → 发邮件所以它仍然是 Workflow。
真正关键的是,谁决定什么时候调用哪个 Tool。
如果程序提前规定:
query → analyze → send是 Workflow。
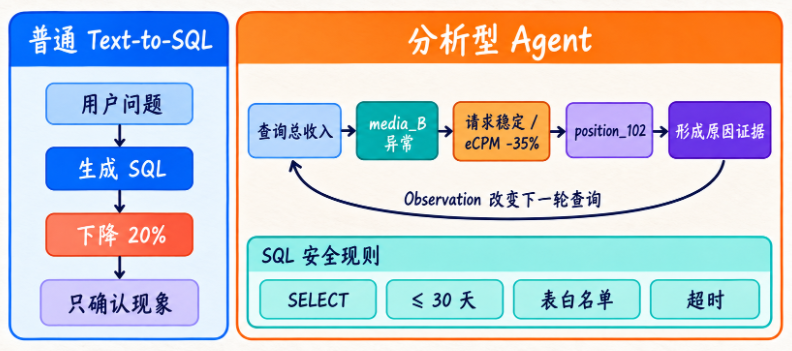
如果模型根据第一条查询结果决定:
先拆媒体
 ↓
发现媒体 B 异常
 ↓
只查媒体 B
 ↓
发现 eCPM 异常
 ↓
继续拆广告位
 ↓
结束
这才开始具备典型 Agent 特征。
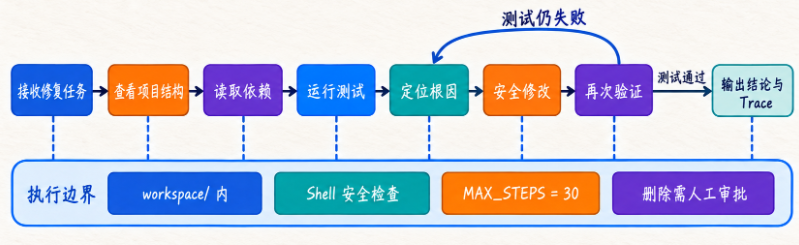
Agent 的“动态决策”并不等于“自由发挥”
这里还有一个特别重要的边界。
Agent 可以决定:
- 读哪个文件;
- 查哪个指标;
- 是否继续下钻;
- 是否需要重新测试。
但不应该让它自己决定:
- 是否允许访问
/etc/; - 是否能读
~/.ssh/; - SQL 是否可以
DROP TABLE; - 最大运行多少步;
- 是否拥有生产发布权限。
所以我们说,把部分决策权交给模型。
而不是,把所有控制权交给模型。
这也正是 Agent Harness 存在的原因。
模型负责“任务层决策”。
Harness 负责“系统级约束”。














请登录后查看评论内容