

学到这里,很容易走向另一个极端,“既然 Agent 能动态决策,那以后所有 Workflow 都可以不要了。”
这恰恰是很多 Agent Demo 一进入生产就出问题的原因。
真正靠谱的做法通常是,确定的事情写死,不确定的事情交给 Agent。
我们用一个 Data Analysis Agent 来看。
用户问,“为什么昨天广告收入下降?”
系统里有一批东西是绝对确定的:
校验用户身份
限制查询时间
限制数据库与表
禁止 SELECT *
限制 SQL 类型
设置超时
设置返回行数
记录审计日志
这些事情千万不要让模型每次“思考一下”。
它们应该由 Workflow / Middleware 写死。
但分析方向可以动态:
先查哪个指标?
是否按媒体拆?
是否继续按广告位拆?
需要看请求还是 eCPM?
什么时候证据已经足够?
这些才适合 Agent。
于是系统变成:
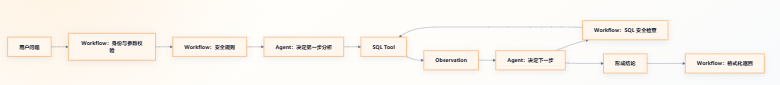
你会发现,Agent 不是外层全部接管,而是嵌进 Workflow 中负责最有价值的动态决策。
把两者组合起来看,生产系统更像是一条确定性通道包住一个动态循环:
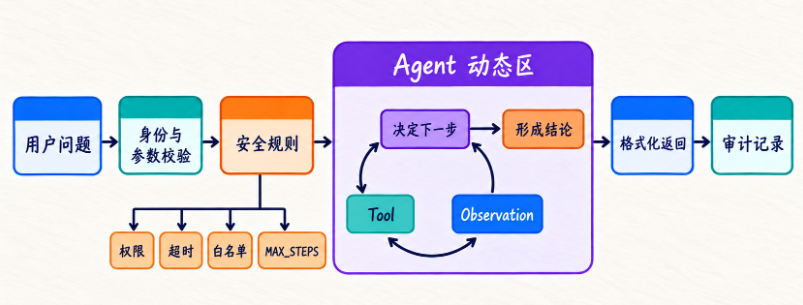
身份、参数、安全、格式化和审计都沿固定路径执行;只有“下一步查什么、何时形成结论”进入 Agent 动态区。这样既保留模型依据 Observation 调整动作的能力,也不会让权限、超时或白名单跟着模型一起变化。
Coding Agent 也一样
固定部分:
创建 workspace
限制目录
加载规则
启动 tracing
设置 MAX_STEPS
任务结束后生成 Run Summary
动态部分:
先读哪个文件?
先搜索还是先运行测试?
这个错误更像依赖问题还是配置问题?
修改以后需要验证什么?
一个实用的五问判断法
以后遇到任何任务,不要先问,“能不能上 Agent?”
先问五个问题。
第一问:完整步骤能不能提前列出来?
如果可以,优先 Chain / Workflow。
比如:
读取 CSV → 去重 → 聚合 → 写数据库没必要 Agent。
第二问:分支虽然多,但规则是否明确?
如果明确,优先 Workflow。
例如:
金额 > 1 万 → 人工审批
否则 → 自动处理
这不是 Agent 的强项。
第三问:下一步是否依赖上一步的语义结果?
如果是,Agent 价值开始出现。
例如,根据错误日志,判断下一步应该查哪个文件。
第四问:候选动作是否很多,很难提前穷举?
如果是,Agent 更值得考虑。
例如 Coding Agent 可选:
read_file
list_files
search_files
run_test
run_python
edit_file
每个工具还有不同参数。
第五问:任务是否允许一定程度的不确定性?
如果答案是否定的,就必须保留强 Workflow 约束。
支付、删库、生产发布、权限变更,都不能让模型直接掌权。
这五个问题并不是给项目机械打分,而是在帮助我们把三类选择快速分开:
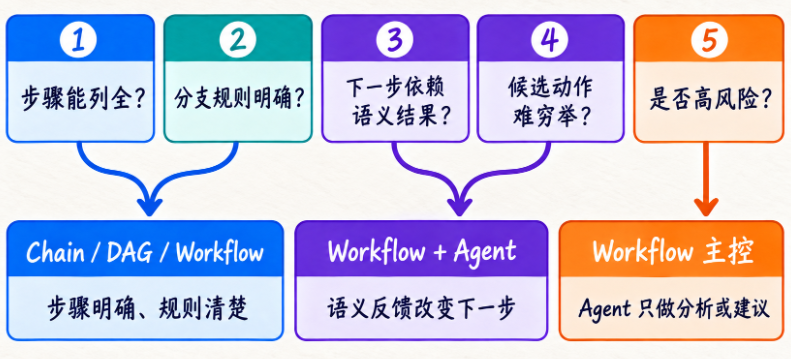
步骤能列全、规则又清楚时,优先选择确定性方案;语义反馈会改变下一步、候选动作又难穷举时,再考虑把 Agent 放进 Workflow;只要涉及高风险操作,就应先让 Workflow 掌握控制权,Agent 至多负责分析与建议。
把判断框架写成代码
我们甚至可以写一个小工具帮助自己形成习惯:
def recommend_architecture(
    steps_known: bool,
    rules_clear: bool,
    semantic_branching: bool,
    many_possible_actions: bool,
    high_risk: bool,
) -> str:
    if high_risk:
        return (
            "优先 Workflow;如使用 Agent,"
            "只让 Agent 负责分析与建议,高风险动作必须由确定性规则控制。"
        )

    if steps_known and rules_clear and not semantic_branching:
        return "优先 Chain / DAG / Workflow。"

    if semantic_branching and many_possible_actions:
        return "适合考虑 Workflow + Agent。"

    return "先使用简单 Workflow,再评估是否真的需要 Agent。"


if __name__ == "__main__":
    coding_agent = recommend_architecture(
        steps_known=False,
        rules_clear=False,
        semantic_branching=True,
        many_possible_actions=True,
        high_risk=False,
    )

    payment_system = recommend_architecture(
        steps_known=True,
        rules_clear=True,
        semantic_branching=False,
        many_possible_actions=False,
        high_risk=True,
    )

    print("代码修复任务:", coding_agent)
    print("支付系统:", payment_system)
这段代码当然不是一个万能架构决策器。
它真正的价值,是把本节最重要的思考固定下来,不要问“这个项目能不能用 Agent”,而要问“这个项目里哪些决策值得交给 Agent”。
后面学 Flask 服务化、安全控制、Human Approval、Tracing 时,你会不断看到这个原则回来。
用同一个排查任务,比较三种控制方式
我们继续看“项目启动失败”这个任务。如果原因始终是缺少同一个配置项,固定执行检查、补充配置、重启就足够了。如果需要并行检查依赖、配置和端口,再按明确规则合并结果,可以用 DAG 或 Workflow。只有下一步调查明显依赖报错的具体含义、难以事先穷举时,才值得让模型参与决策。
选择 Agent 之后,我们仍要限定它能做什么。查日志与修改生产配置的权限不同;模型判断“需要改配置”,不会自动获得写入权。这里可以把业务步骤分为探索和提交:探索允许动态选择读取工具,提交则由确定性校验和必要的审批保障。混合方案适合这种任务,但对于路径简单的任务,直接使用固定流程也完全合理。
比较方案时,我们同时记录正确率、调用次数、耗时和维护复杂度。一个多做十轮调查才完成的 Agent,未必比三步固定流程更适合当前业务。模型的灵活性只有解决了具体的不确定性,才值得承担额外开销。
动手比较:把决定权标出来
请分别画出“每天生成固定日报”和“排查陌生服务异常”的流程,在每个分支旁标出由代码还是模型决定。参考思路是:日报的时间范围、指标计算和发送规则通常适合固定下来;异常排查中的下一条查询可以交给模型。若你能指出交权的位置和原因,就比单纯记住几种架构名称更进一步。














请登录后查看评论内容