

我们先从最简单的 LLM 应用开始。
假设现在有一个函数:
def chat(prompt: str) -> str:
    return "模型回答"
用户输入一句话,我们调用一次模型,然后直接返回答案。
这种结构可以完成很多任务:
- 翻译;
- 摘要;
- 改写;
- 分类;
- 普通知识问答;
- 根据已知上下文写一段内容。
因为这些任务通常不需要和外部环境反复交互。
但是,一旦任务变成,“帮我看看项目里为什么报错。”
问题就变了。
模型缺少环境信息。
它必须先获取信息。
于是它需要 Tool。
这时最朴素的 Agent 结构可以写成:
while True:
    response = llm.chat(messages)

    if response.tool_call:
        result = execute_tool(response.tool_call)
        messages.append(result)
    else:
        return response.answer
我们先别急着讨论不同模型厂商具体 Tool Calling API 长什么样。这里最重要的是控制流。
第一层:为什么一定要 while?
因为你无法提前知道这个任务需要几步。
可能一步:
读配置
 ↓
发现问题
 ↓
结束
也可能五步:
看目录
 ↓
读入口
 ↓
跑测试
 ↓
查依赖
 ↓
重新验证
 ↓
结束
甚至可能二十步。
所以 Agent Loop 通常不能写成:
step1()
step2()
step3()
因为步骤数量与顺序本来就是运行时动态产生的。
while 的本质就是,只要任务还没结束,就继续让模型判断下一步。
这和普通循环很像。
例如我们计算某个值直到满足条件:
value = 1

while value < 100:
    value *= 2

print(value)
区别只是,普通算法的下一步由确定性代码决定,而 Agent Loop 的下一步会由模型结合当前上下文决定。
第二层:messages 为什么会越来越重要?
第一次模型调用时:
messages:
- user: 帮我检查项目为什么运行失败
模型返回:
tool_call:
list_files()
工具执行以后,我们不能只把结果打印到终端。
必须把它加入:
messages:
- user: 帮我检查项目为什么运行失败
- assistant: 我要调用 list_files
- tool: ["src/main.py", "pyproject.toml"]
第二次调用模型时,它才能知道,“刚才我已经看过目录,而且确实有 src/main.py。”
如果你没有把 Tool Result 放回 messages,下一轮模型就像失忆了一样。
它可能继续问,“我需要先看看目录。”
于是再次调用 list_files()。
这就是很多 Agent 重复 Tool Call 的根源之一。
不是模型“傻”,而是 Harness 没把 Observation 正确放回上下文。
第三层:为什么模型不能自己执行 Tool?
假设模型返回:
{
  "tool": "read_file",
  "arguments": {
    "path": "src/main.py"
  }
}
这只是一个结构化建议。
模型本身没有操作系统权限,也没有 Python 文件句柄。
真正执行的是:
result = read_file("src/main.py")因此实际链路是:
LLM
 ↓
产生 Tool Call
 ↓
Harness 解析
 ↓
Python 函数执行
 ↓
真实结果
 ↓
Observation
这个边界很重要。
后面我们做安全控制时,就会利用这个边界,模型可以“请求”执行,但 Harness 可以拒绝。
模型提出的 Tool Call 和真实环境中的执行动作,中间隔着一层明确的工程边界。把这层关系展开后,就能看清权限、参数与异常究竟由谁负责。
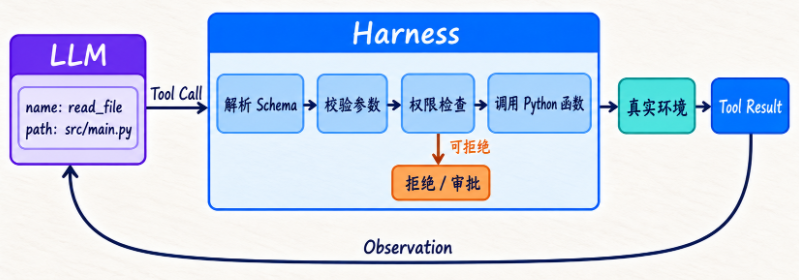
图中的 Harness 既负责解析和校验,也决定动作是否获准执行;只有真实 Tool Result 被包装成 Observation 后,模型才会在下一轮看到环境发生了什么。
一个完整可运行的最小 Loop
下面我们不用任何外部模型 API,先用一个模拟 LLM 把完整流程跑通。
from dataclasses import dataclass
from typing import Optional


@dataclass
class ToolCall:
    name: str
    arguments: dict


@dataclass
class LLMResponse:
    answer: Optional[str] = None
    tool_call: Optional[ToolCall] = None


def list_files() -> list[str]:
    return [
        "README.md",
        "requirements.txt",
        "src/main.py",
    ]


def read_file(path: str) -> str:
    files = {
        "README.md": "Run with: python3 src/main.py",
        "requirements.txt": "Flask==3.0.0",
        "src/main.py": "from flask import Flask\nimport requests",
    }
    return files.get(path, "FILE_NOT_FOUND")


def execute_tool(tool_call: ToolCall):
    if tool_call.name == "list_files":
        return list_files()

    if tool_call.name == "read_file":
        return read_file(tool_call.arguments["path"])

    return f"UNKNOWN_TOOL: {tool_call.name}"


def fake_llm_chat(messages: list[dict]) -> LLMResponse:
    tool_messages = [
        message
        for message in messages
        if message["role"] == "tool"
    ]

    if len(tool_messages) == 0:
        return LLMResponse(
            tool_call=ToolCall(
                name="list_files",
                arguments={}
            )
        )

    if len(tool_messages) == 1:
        return LLMResponse(
            tool_call=ToolCall(
                name="read_file",
                arguments={"path": "src/main.py"}
            )
        )

    return LLMResponse(
        answer=(
            "已经读取项目结构和 src/main.py。"
            "代码中导入了 requests,下一步真实项目里还应检查依赖声明。"
        )
    )


def run_agent(user_message: str) -> str:
    messages = [
        {
            "role": "user",
            "content": user_message
        }
    ]

    while True:
        response = fake_llm_chat(messages)

        if response.tool_call is not None:
            tool_call = response.tool_call

            messages.append({
                "role": "assistant",
                "content": f"TOOL_CALL: {tool_call.name} {tool_call.arguments}"
            })

            result = execute_tool(tool_call)

            messages.append({
                "role": "tool",
                "content": str(result)
            })

            continue

        return response.answer or "模型没有返回答案"


if __name__ == "__main__":
    answer = run_agent("帮我检查这个项目")
    print(answer)
这段代码已经有了真正的 Main Loop 结构。
只是“决策器”还是 fake_llm_chat()。
后面接真实模型时,Main Loop 的骨架不会发生本质变化。
配套项目中的第一个阶段已经把这条链路放进可复用的 AgentEngine。
完成环境准备后,可以直接运行:
cd agent_harness_course_projects
python3 projects/01_main_loop/main.py
你会先看到最终答案“工具返回 42,任务完成”,随后看到一次 double 工具调用的历史记录。这里值得多看一眼顺序:模型第一次请求工具,Harness 执行 double(21) 得到 42,第二次模型调用才给出最终答案。输出很短,但两轮决策已经完整发生。
如果运行时出现 ModuleNotFoundError: agent_harness,通常不是 Main Loop 写错了,先确认命令是在 agent_harness_course_projects 目录中执行,并且使用的是课程要求的 Python 3.9。阶段入口已经自动加入项目的 src 目录,不需要再手动设置 PYTHONPATH。
把上面的代码折叠成一张运行结构图,会发现每一轮其实都有稳定的七个环节,而 Finish 只是其中一条退出分支。
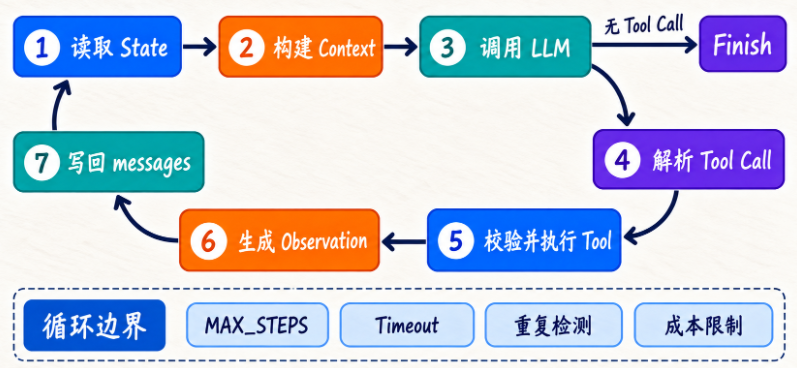
沿着编号阅读即可对应代码:从读取 State、构建 Context 到执行 Tool、写回 Observation;只有写回完成,下一次 LLM 调用才拥有新的事实。下方的护栏则提醒我们,循环还必须受步数、超时、重复与成本限制。
如何验证你真的理解了这段代码?
可以做一个很简单的实验。
把:
messages.append({
    "role": "tool",
    "content": str(result)
})
暂时注释掉。
然后观察模型逻辑会发生什么。
真实 LLM 场景中,很容易出现:
一直重复请求同一个工具因为它看不到工具执行结果。
这就是 Main Loop 的第一个关键结论,循环不是简单地重复调用 LLM,而是每次都要把真实执行结果带进下一轮。














请登录后查看评论内容