


先把最基础概念讲清楚。
什么是 Context Window?
Context Window 可以直观理解成,模型一次调用能够“看见并处理”的最大上下文容量。
这个上下文通常包括:
System Prompt
User Messages
Assistant Messages
Tool Calls
Tool Results
其他输入内容
+
模型即将生成的输出预算
可以把它想象成一个固定大小的工作台。
你每放进去一段文字,就占一块空间。
最后模型还需要留下空间生成答案。
所以:
Input
+
Output
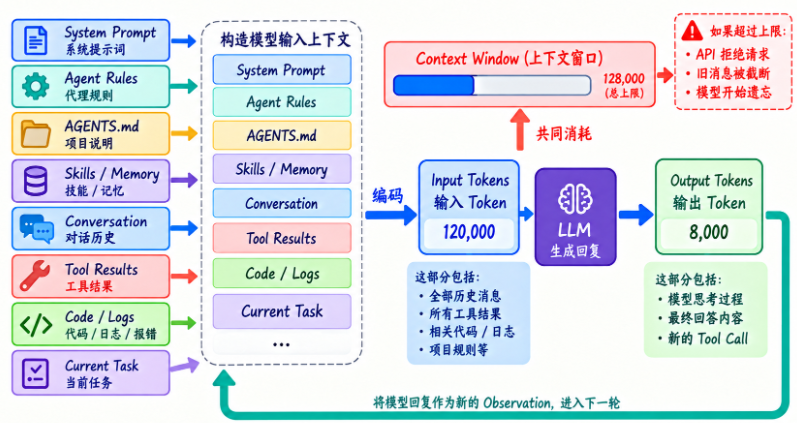
共同受模型上下文能力约束。
先把这个“总预算”关系放到一张图里看,会比单独记 Input、Output 两个概念更直观。左侧不同来源最终都要进入 Input,模型还必须预留 Output 和安全余量,因此真正能塞进历史、代码和 Tool Result 的空间永远小于标称窗口。
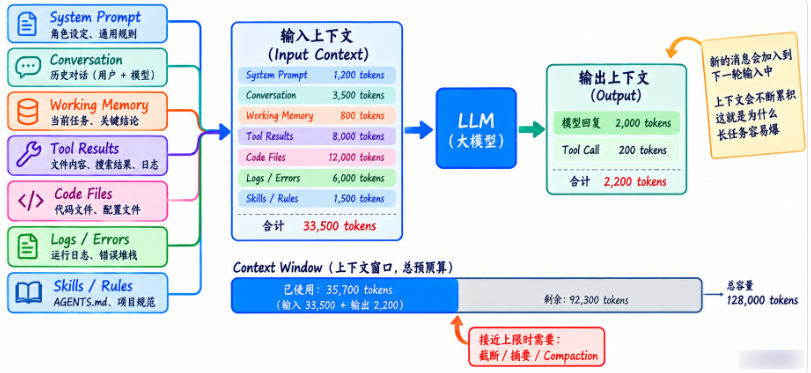
后面做 ContextBuilder 时,可以一直用这张图检查预算:不是“Input 没超过上限就安全”,而是本轮完整请求加上输出预留以后仍然要留有余量。
什么是 Token?
模型不是按“字数”精确计算上下文。
它处理的是,Token。
Token 可以理解成模型文本处理的基础单位。
一个 Token 不一定等于一个汉字,也不一定等于一个英文单词。
中文、英文、代码、JSON、标点的切分方式都不同。
所以:
1000 个字符并不固定等于:
1000 Token课程这里不要求你背具体比例。
只需要形成一个非常重要的工程意识,Context Budget 最终应该按 Token 管理,而不是只按字符数。
我们前面 ContextBuilder 用字符预算,是为了教学简单。
真实 Agent 更适合使用模型 tokenizer 或 Provider usage 数据。
Input Token 是什么?
Input Token 指,模型这一轮收到的所有输入所占 Token。
例如:
System Prompt
Agent Rules
Working Memory
Conversation
Tool Results
Current Task
Tool Schema
全部都算 Input Token。
注意,Tool Schema 也可能占很大一块。
如果你有:
50 个 Tool每个 Tool Schema 都有名称、说明、参数类型、required、enum 等字段,光工具描述本身就会形成一块固定输入成本。
这也是为什么 Tool 越多,并不一定越好。
Output Token 是什么?
Output Token 指,模型这一轮生成内容所占 Token。
例如模型返回:
自然语言答案
Tool Call
结构化 JSON
计划
这些都属于输出。
通常你还会给模型设置一个最大输出预算。
工程上真正要考虑的是,Input 已经很大时,还要给 Output 留多少空间。
为什么 Input 和 Output 要一起考虑?
假设一个模型总 Context Window 为:
100K Token如果当前 Input 已经占:
98K但你还希望模型生成:
5K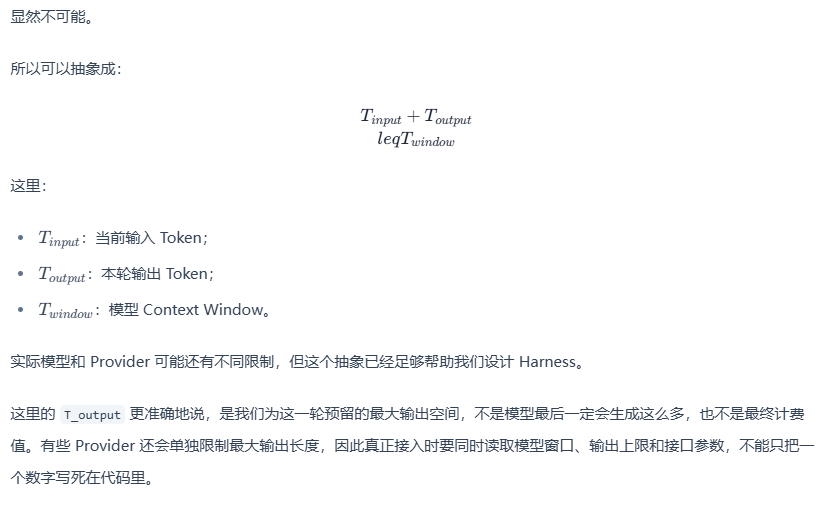
单次窗口和 Run 累计 Token 不要混在一起
Context Window 约束的是某一次模型调用。如果第 1 步用了 5K Token,第 2 步用了 7K,Trace 里的 Run 累计用量可以是 12K;这不代表第 2 步的 Context 一定是 12K,也不代表一个 10K 窗口必然超限。只有第 2 步确实重新携带了第 1 步内容,那部分才会再次进入这一轮 Input。
所以我们通常保留两组指标:current_input_tokens 用来判断下一次请求能不能安全发出,run_total_tokens 用来观察整段任务的成本。一个是容量问题,一个是累计消耗问题,名字很像,处理方式却不同。
这里建议把两个指标彻底分开记。current_input_tokens 回答的是“下一次请求还能不能安全发出去”,而 run_total_tokens 回答的是“这个任务到目前为止一共消耗了多少 Token”。
所以一个 Run 累计已经 80K,并不代表 16K 的单次窗口一定爆了;真正判断超限时,还是看当前这一次 Input、预留 Output 和安全余量的合计。
Tool Schema 也要算账
很多人做 Agent 时只监控 messages,忽略:
tools但 Tool Schema 每一轮也可能发给模型。
例如:
read_file
write_file
edit_file
run_shell
query_sql
search_web
...
如果一个 Agent 直接暴露几十个大 Schema,就算 Conversation 还很短,Input Token 也可能已经很高。
所以未来更成熟的做法可能是:
Task
 ↓
Relevant Tool Selection
 ↓
只暴露当前需要的一部分工具
而不是,“工具越多越强,全给模型。”
一个简单 Token 趋势估算器
下面代码不是精确 tokenizer,只用于教学观察。
def rough_token_estimate(
    text: str,
) -> int:
    if not text:
        return 0

    chinese_chars = sum(
        1
        for char in text
        if "\u4e00" <= char <= "\u9fff"
    )

    other_chars = (
        len(text)
        - chinese_chars
    )

    estimated = (
        chinese_chars
        + other_chars // 4
    )

    return max(
        estimated,
        1,
    )


if __name__ == "__main__":
    samples = [
        "这是一个中文测试。",
        "This is an English sentence.",
        "def add(a, b): return a + b",
    ]

    for item in samples:
        print(
            item,
            "≈",
            rough_token_estimate(
                item
            ),
            "tokens",
        )
不要把这个结果当成精确账单。
真正生产环境优先:
使用 Provider 返回的 usage
或对应 tokenizer
但它已经足够帮助我们理解,Context 是在持续消耗资源。
请求前,Harness 只能根据 tokenizer 或估算器做 Preflight;请求完成后,Provider 返回的 usage 才是这一轮更可靠的实测值。两者都值得记录,并标清 estimated 还是 actual。如果长期偏差很大,我们应校准估算规则,而不是悄悄把安全余量吃掉。
另外,消息角色、结构化字段和 Tool Schema 的序列化也可能带来协议开销,图片、音频等输入还有各自的计量方式。只统计 content 字符长度容易漏算,所以估算器至少要把完整消息结构和工具 Schema 一起纳入。
Token 为什么应该进入 Trace?
因为以后你会想回答:
这个 Run 为什么这么贵?
哪一步 Input 突然暴涨?
哪个 Tool Result 最占上下文?
Compaction 前后节省多少?
这些都离不开 Token 指标。
所以:
input_tokens
output_tokens
total_tokens
后面会成为 AgentOps 的正式指标。















请登录后查看评论内容