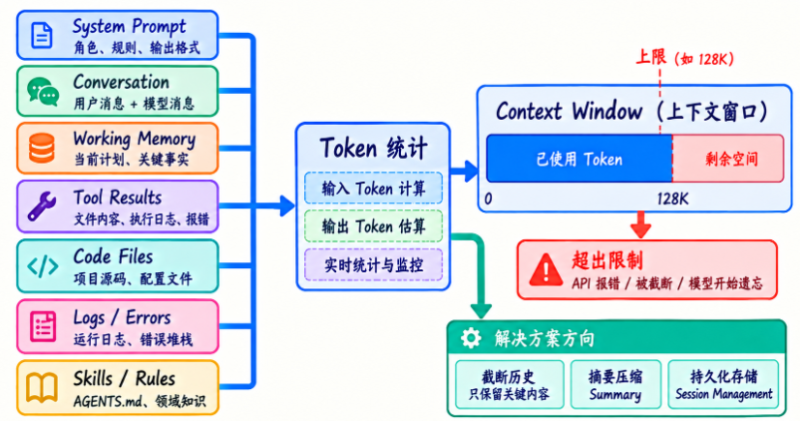


普通 Chatbot 一般是:
User
Assistant
User
Assistant
每轮新增一些对话。
但 Agent 不一样。
Agent 每一轮可能同时新增:
Assistant Tool Call
Tool Result
Working Memory Update
日志
文件内容
错误
下一轮 Assistant
所以增长速度会快很多。
Agent 的 Context 更像滚雪球,而不是普通聊天那样每轮只多一问一答。每一次 Tool Call 都可能带回文件、日志、SQL 结果和错误信息,这些内容如果继续原样进入下一轮,就会持续叠加。
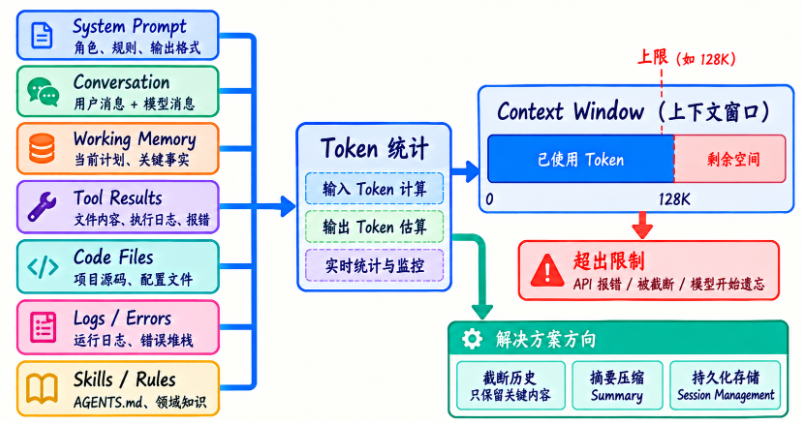
这也是为什么长任务不能等到第 30、40 轮才第一次考虑压缩。真正应该关注的是每一轮新增了多少“环境信息”,以及这些信息是否还值得继续携带。
模拟一个 20 轮 Agent
假设每一轮:
模型输出:300 Token
Tool Result:1500 Token
那么一轮新增大约:
1800 Token20 轮就是:
36000 Token还没有算:
System Prompt
AGENTS.md
Skills
Working Memory
Tool Schema
用户消息
只要其中某几轮读到大文件,增长会更快。
一个可运行的 Context Growth 模拟器
如果你把:
tool_per_step从 1500 改成 5000,再看结果,会非常直观。
Tool Result 为什么是最大风险之一?
因为 Tool Result 的长度通常不由模型直接控制。
比如:
read_file可能返回 100 行,也可能 5000 行。
run_shell可能返回 20 行,也可能 10000 行。
query_sql可能返回 10 行,也可能几千行。
所以 Tool Result 是,Agent Context 中最不稳定、最容易突然膨胀的来源。
这也是为什么前面基础 Tool 已经加入:
max_chars
max_results
output truncation
这些限制不是“后期优化”。
它们本质上是 Context Safety。
把不同来源放在一起比较,会发现 Tool Result、代码文件和运行日志的危险性不只在于“长”,更在于长度很难提前稳定预测。一次 read_file 或 run_shell 就可能突然把本轮输入抬高很多。
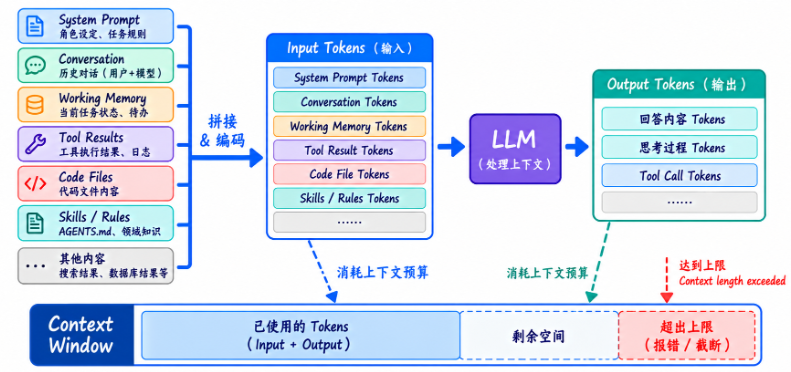
所以前面 Tool 层做的 max_chars、max_results、输出截断,本质上已经是在给后面的 Context Engineering 提前减压,而不是单纯的界面优化。
代码文件为什么很危险?
Coding Agent 很容易出现:
read_file("service.py")
read_file("models.py")
read_file("repository.py")
read_file("tests/test_service.py")
每个文件都可能几千 Token。
更麻烦的是,文件读过以后如果一直原样留在 Context,后面每一轮模型调用都会重复携带它们。
这意味着,一个 5000 Token 文件,不是只付一次成本。
如果后面还有 10 次模型调用,而你每轮都带它,它就会被反复计入 Input。
这就是 Agent 成本为什么会快速上升。
如果 Provider 支持 Prompt Caching,重复前缀可能在费用或延迟上更便宜,但它仍然属于模型需要处理的逻辑上下文,通常也不会凭空扩大 Context Window。缓存解决的是“重复传输和计算能不能更省”,Compaction 解决的是“这一轮到底还要不要带这么多内容”,两者不要混为一谈。
Error Trace 也很危险
一个 Python traceback 可能几百行。
如果依赖栈很深:
framework
middleware
service
db driver
输出会非常长。
真正给模型的 Error Observation 应该优先结构化:
error_type
关键错误行
核心 message
少量上下文
完整 traceback 放 Trace。
这样既不丢证据,也不污染 Context。
Tool Schema 是“固定增长成本”
随着 Agent 工具越来越多:
read_file
write_file
edit_file
list_files
search_files
run_python
run_shell
query_metric
query_sql
...
如果每次都把全部 Schema 发给模型,即使 Tool Result 没增长,固定输入也会越来越高。
因此未来还可以引入:
Relevant Tool Selection和 Skills 类似,只给当前任务相关工具。
Conversation History 也是累积项
用户每轮说一句。
模型每轮答一句。
长期也会变大。
尤其模型每次如果输出很长的解释文字,内部 Agent 会话会越来越重。
所以成熟 Agent 往往会尽量:
让 Tool Call 和状态结构化而不是每一步都生成很长的自然语言中间说明。
















请登录后查看评论内容