

现在正式回答本节最核心问题。
Agent 比普通 Chatbot 更容易把 Context Window 撑爆。
原因至少有六个。
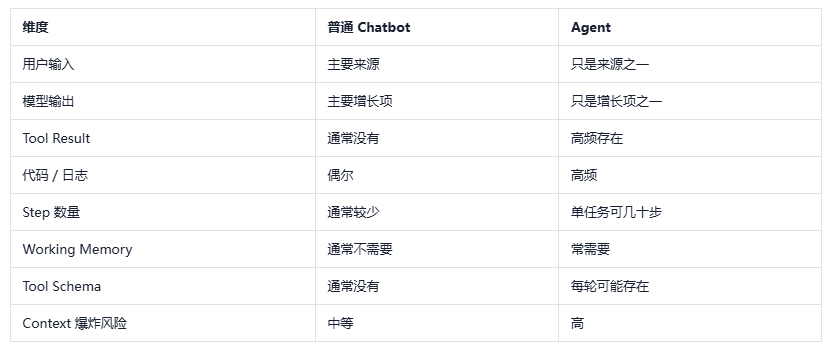
原因一:Agent 会产生 Tool Result
普通 Chatbot:
User
Assistant
Agent:
User
Assistant Tool Call
Tool Result
Assistant Tool Call
Tool Result
...
每一步都多一层环境反馈。
原因二:一个用户请求内部就可能有很多 Step
普通聊天:
问一句
答一句
Agent:
用户只问一句
内部跑 20 个 Step
所以 Agent 的“轮数”不能只看用户交互次数。
原因三:Tool Result 通常比聊天消息长
代码、日志、SQL、网页、文件内容都很大。
尤其 Coding Agent:
代码文件
测试日志
diff
异常栈
都是高 Token 内容。
原因四:Agent 还要额外带 Rules、Memory、Skills
普通 Chatbot 可能只有简单 System Prompt。
Agent 还需要:
AGENTS.md
Working Memory
Relevant Skills
Project Rules
Tool Schemas
Current Task
这些形成每轮固定预算。
原因五:Agent 为了自主性,需要保留更多证据
普通聊天里某些旧对话很快可以忽略。
Agent 却需要知道:
为什么得出某结论
哪个 Tool 已经执行
哪个错误已经排除
哪些文件已修改
所以历史不能粗暴全部丢。
原因六:Agent 更容易产生重复信息
如果 State 或 Working Memory 设计不好,会出现:
read app.py
read app.py
read app.py
重复 Tool Result 会进一步撑大 Context。
所以减少重复 Tool Call,也是在控制 Context Growth。
普通 Chatbot vs Agent
一个极端例子
用户只说,“帮我修这个 Bug。”
但 Agent 内部可能发生:
read 8 个文件
run 4 次 pytest
search 5 次
edit 3 个文件
read diff
run full test
用户消息很短。
内部 Context 却可能已经几十万字符。
所以判断 Agent Context 不能看,“用户聊了几轮。”
而要看,整个 Run 产生了多少环境信息。
这也是 Agent 和普通 Chatbot 最大的差异之一。Chatbot 主要累积对话,而 Agent 会在一个用户问题内部自行展开很多 Step,代码、日志、Tool Result、Memory 和 Rules 都会一起参与下一轮输入。
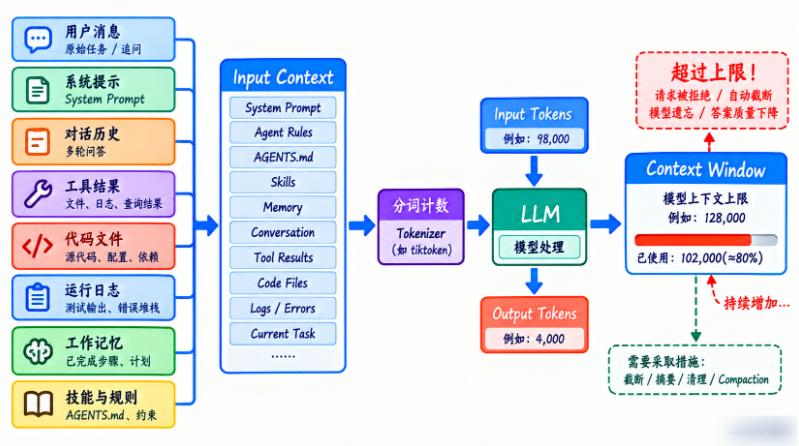
因此“用户只问了一句话”并不能说明 Context 很小。判断风险时要看整个 Run 内部到底产生了多少 Observation,以及这些 Observation 被重复带了多少轮。
Context 过长即使没超限也可能变差
这是很重要的一点。
硬上限之外,还有,有效注意力问题。
当上下文里同时存在:
10 个旧错误
20 个文件
100 个日志片段
3 个 Skill
一堆过期计划
模型需要从里面重新找当前真正重点。
即使技术上没超过窗口,也可能:
忽略关键规则
被旧错误误导
重复调查
选错 Tool
所以 Context Engineering 的目标不是,“只要不超窗口就行。”
而是,让重要信息始终清晰、相关、可行动。
















请登录后查看评论内容