

真正工程里不能等:
ContextLengthExceeded出现以后再想办法。
应该提前监控。
至少监控什么?
建议最少有:
current_input_tokens
reserved_output_tokens
safety_margin_tokens
context_window
usage_ratio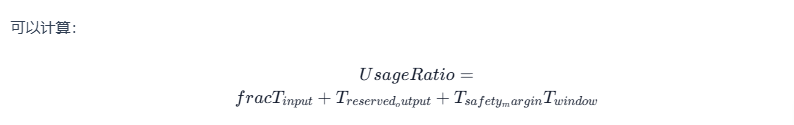
例如:
Input = 70K
Reserved Output = 8K
Safety Margin = 2K
Window = 100K
那么:
Usage = 80%这时就应该开始准备压缩。安全余量不是浪费,它用来吸收估算误差、协议开销和模型配置变化;如果每次都把窗口算到刚好等于上限,线上请求会非常脆弱。
一个实用阈值
可以先这样设计:
< 60%
NORMAL

60% ~ 80%
WATCH

80% ~ 90%
COMPACT_SOON

>= 90%
CRITICAL
具体数值以后按模型和业务调整。
这些阈值最好不要只存在文档里,而是进入 Runtime 的监控逻辑。把 Input + Reserved Output + Safety Margin 放进同一条预算尺,可以在 API 真正拒绝请求之前就提前识别风险。
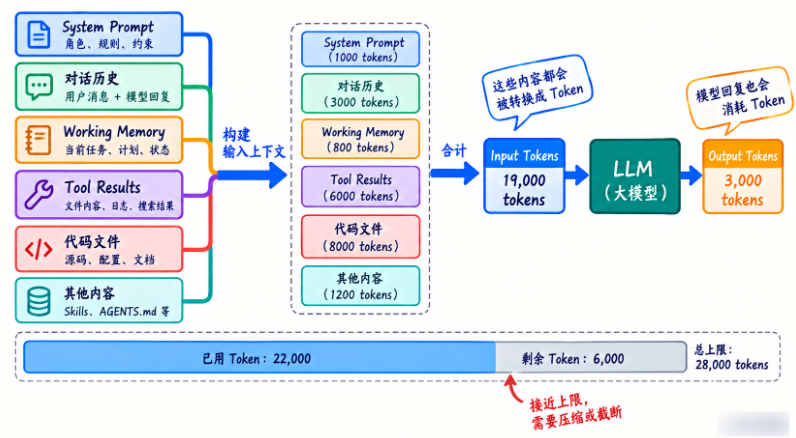
例如进入 WATCH 时先观察增长来源,进入 COMPACT_SOON 就准备裁剪或摘要,到了 CRITICAL 则应该阻止继续无条件堆内容。这样 Context 管理才是主动控制,而不是事后救火。
一个简单 ContextUsageMonitor
这段代码已经可以接进 ContextBuilder。
ContextBuilder 应该返回 Usage Report
上一节我们已经有:
BuildReport现在可以继续加:
estimated_tokens
included_sections
skipped_sections
例如:
{
  "estimated_input_tokens": 74200,
  "context_window": 100000,
  "reserved_output_tokens": 8000,
  "usage_ratio": 0.822,
  "included": [
    "system",
    "project_rules",
    "working_memory",
    "recent_messages"
  ],
  "skipped": [
    "old_tool_results"
  ]
}
以后 Tracing 就能看到,这一轮为什么触发压缩。
哪些内容优先保留?
通常:
System Rules
Safety Rules
Current Task
Working Memory
关键项目规则
最近关键 Observation
优先压缩或丢弃:
很老的 Conversation
重复 Tool Result
完整 traceback
大型日志
已解决问题的细节
不相关 Skill
已读过的大文件全文
这里再次强调,“不进入当前 Context”不等于“从系统永久删除”。
原始内容仍然可以放在:
Trace
Session Store
File Store
需要时再次检索。
这就是,Context 与 Storage 的区别。
这部分最容易被误解成“压缩就是删数据”。实际上,当前 Context 只是模型这一轮真正需要看到的工作集,原始日志、完整 SQL 结果和旧文件内容完全可以继续保存在 Trace、Session Store 或 File Store。
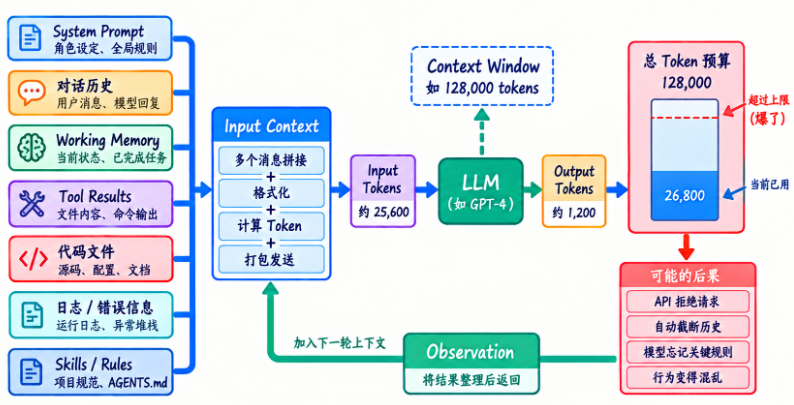
真正要减少的是“每轮重复发送给模型的内容”。高优先级规则、Current Task、Working Memory 和关键 Observation 应该稳定保留,而旧日志、重复结果和已解决细节更适合摘要后按需取回。
为什么不能只保留最近 N 条消息?
简单策略:
messages[-20:]确实能减小 Context。
但可能误删非常重要的旧信息。
例如用户最开始说:
绝对不要修改 tests/这句话可能在第1轮。
到第30轮只保留最近20条,它就没了。
所以更好的架构是:
高优先级 Rules 独立保存
+
Working Memory 保留关键认知
+
Conversation 只保留最近部分
+
旧内容后续 Compaction
这也是我们前几节为什么提前把 Context 拆成不同来源。
简单滑窗的问题就在这里:它只知道“新旧”,不知道“重要不重要”。第 1 轮的项目约束可能比第 29 轮的一段普通日志重要得多,但 messages[-20:] 会毫不犹豫地把前者删掉。
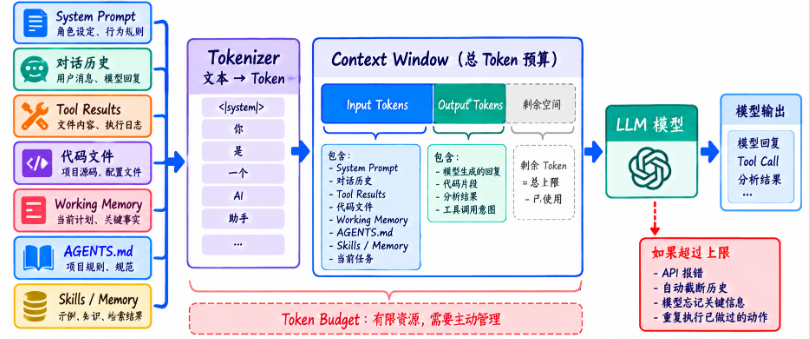
所以成熟一点的 Context 结构要把规则、Working Memory 和 Conversation 分开管理。对话可以按时间裁剪,但关键约束需要按语义重要性和生命周期稳定保留。
先算预算,再决定保留哪些材料
我们假设一个教学模型的窗口是 16000 Token,计划为输出预留 2000,再留 1000 作为估算余量,那么输入最多安排 13000。这里的数字只是练习配置,实际窗口和计费应以使用的模型为准。输入预算还包含系统规则、工具 Schema、历史和新结果,不能只计算用户问题。
中文字符数、文件字节数和 Token 数并不相等。早期可以用估算器做预警,但要标明估算来源,并用实际接口 usage 校准。工具目录很长时,即使尚未执行工具,其描述也可能已经占用大量输入预算。优先减少无关工具和重复结果,往往比压缩关键规则更稳妥。
窗口未超限也可能出现质量下降。我们需要对照相同任务观察约束遵守、重复查询和正确率,不能看到一次失误就归因于“模型忘了”。先确认内容是否真的进入请求、是否被截断、是否被其他信息冲突覆盖,再决定调整策略。
动手计算:还可以读多少
假设规则占 1500、工具 Schema 占 2500、历史占 7000 Token,按上面的输入预算,还能加入多少新内容?参考答案是 2000。若新日志需要 6000,我们可以先搜索关键片段,再保留原日志引用;直接把整个日志追加进去会突破预算。
在配套项目里观察一次预算
这一节对应的实现位于:
src/agent_harness/context/usage.py
projects/05_context_memory_session/main.py
estimate_context_tokens() 会把消息结构和 Tool Schema 一起纳入粗略估算,ContextUsage 再把输入、预留输出和安全余量放进同一份报告。进入 agent_harness_course_projects 后运行:
python3 --version
python3 projects/05_context_memory_session/main.py
输出中的 estimated_input_tokens 是请求前预警值,usage_ratio 表示本轮预留后的窗口比例,level 给出当前处理建议。这个 Demo 没有调用真实模型,因此拿不到 Provider usage;接入线上 Provider 后,应把响应中的实际 Input / Output Token 写入 Trace,用来校准估算器和统计 Run 成本。
你可以把示例里的 context_window 改小,或者向 Session 追加一段长日志,再观察 NORMAL、WATCH、COMPACT_SOON、CRITICAL 如何变化。这里值得留意:进入 CRITICAL 只说明必须采取动作,并不代表可以静默丢掉 System Rules 或用户约束。
















请登录后查看评论内容