


上一节我们的 Tool Executor 已经做了类似处理:
try:
    result = tool.func(**arguments)

    return {
        "ok": True,
        "result": result,
    }

except Exception as exc:
    return {
        "ok": False,
        "error_type": type(exc).__name__,
        "error": str(exc),
    }
这个结构非常重要。
因为它把:
Python Exception变成:
Agent 能理解的 Observation为什么不能直接让 Exception 冒出去?
假设:
read_file("config.py")抛:
FileNotFoundError如果异常直接冒到 Main Loop 外面:
Agent Run
 ↓
Python Exception
 ↓
进程中断
那 Agent 根本没有机会看到,“文件不存在。”
更没有机会修正。
所以对于可恢复错误,更好的流程是:
Exception
 ↓
捕获
 ↓
结构化
 ↓
写入 messages
 ↓
下一轮 LLM 继续判断
Error Observation 应该包含什么?
最基础可以是:
{
  "ok": false,
  "tool": "read_file",
  "error_type": "FileNotFoundError",
  "error": "config.py"
}
进一步可以加:
retryable
attempt
max_retries
suggestion
真实系统里还建议保留 tool_call_id 或 trace_id,这样模型看到的是一条精简错误,开发者仍能从 Trace 找回完整上下文。error_type 最好使用稳定的业务错误码,例如 INVALID_ARGUMENTS、PATH_NOT_FOUND、PERMISSION_DENIED,而不是完全依赖某个 SDK 的异常类名;否则替换底层库后,模型看到的协议也会跟着变化。
例如:
{
  "ok": false,
  "tool": "read_file",
  "error_type": "FileNotFoundError",
  "error": "config.py",
  "retryable": false,
  "suggestion": "请先 list_files 或 search_files 查找真实路径"
}
为什么 suggestion 有价值?
因为 Tool 本身最了解自己的失败模式。
比如:
read_file遇到 FileNotFoundError 时,可以提示,尝试 list_files 或 search_files。
这会提高 Agent 恢复效率。
不过要注意,suggestion 是建议,不是强制 Workflow。
模型仍然可以结合上下文决定下一步。
错误消息也要做最小披露。数据库连接串、请求头、绝对路径和内部堆栈适合进入受控 Trace,不应原样塞进模型上下文或直接展示给用户。我们要保留足够决策的信息,但不需要把所有内部细节一起暴露出去。
这里可以把“Python 异常”到“模型可读错误”的转换理解成一道协议边界。异常先被 Executor 捕获,再被压缩成 error_type / message / retryable / suggestion 这类字段,最后才作为 Observation 回到 Agent。
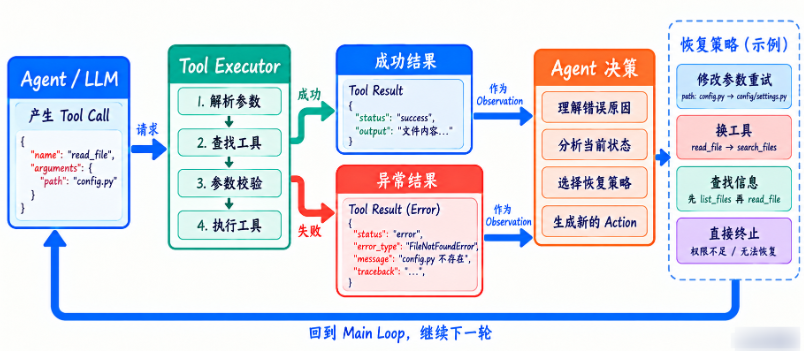
这样做以后,模型不需要从几十行 traceback 里猜重点;开发者仍然可以在 Trace 里保留完整证据。给模型的是决策信息,给 Trace 的是调试证据,两者目标不同。
定义统一 ToolResult
我们可以先设计:
from dataclasses import dataclass
from typing import Any


@dataclass
class ToolResult:
    ok: bool
    tool_name: str
    result: Any = None
    error_type: str = ""
    error: str = ""
    retryable: bool = False
    suggestion: str = ""
这比随手返回字符串更适合 Agent。
完整基础实现
运行后不会直接崩掉。
而是得到一个完整 Error Observation。
这里特意分成三段:先 registry.get(),再用 signature.bind() 检查调用形状,最后执行真实函数。这样工具内部抛出的 KeyError 不会被误判成 UnknownTool,工具内部自己的 TypeError 也不会和“模型少传了参数”混为一谈。需要再提醒一句,bind() 只检查参数名和数量,不验证 "3" 是否真的是整数;完整类型校验仍应使用上一节的 Schema 校验层。
哪些错误应该结构化?
基础 Agent 至少要考虑:
UnknownTool
InvalidArguments
FileNotFoundError
PermissionError
Timeout
ToolRuntimeError
后面还会扩展:
RateLimit
NetworkError
DatabaseError
ValidationError
最重要的是,错误类型要稳定。
不要让 LLM 只能从一大段 traceback 里自己猜发生了什么。
可以保留 traceback 到 Trace,但给模型的 Observation 应该优先结构化。
Error Observation 不是“把异常吞掉”
这是另一个容易误解的点。
我们不是为了,“程序不报错,看起来更稳定。”
而是为了,让错误进入 Agent 决策循环。
Trace 仍然可以完整记录异常。
只是 Agent 不应该因为一个可恢复局部错误直接失去控制。















请登录后查看评论内容