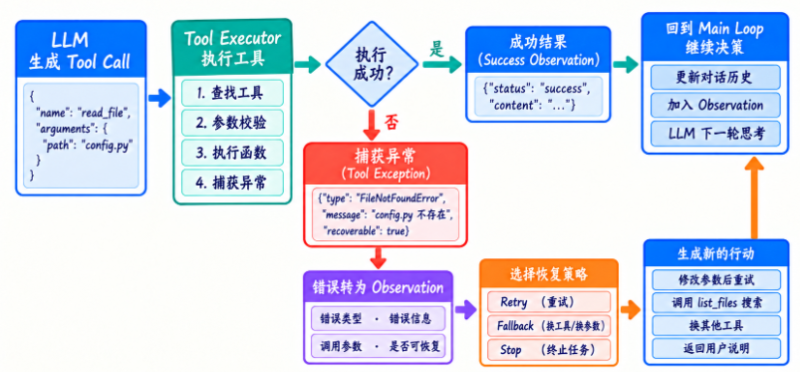


说到 Error Recovery,最常见的第一个词就是,Retry。
但 Retry 很容易被用错。
什么错误适合 Retry?
最典型的是瞬时错误。
比如:
网络超时
服务暂时不可用
429 限流
短暂数据库连接失败
这些错误有一个共同特点,条件可能在下一次尝试时发生变化。
还要再加一个条件:这次调用可以安全重复。 TimeoutError 是瞬时信号,但如果超时发生在写操作上,远端可能已经提交成功,只是响应丢了。此时 retryable 不能只由异常类型决定,还要结合 Tool 的 idempotent 元数据、幂等键和副作用状态一起判断。
例如:
第一次超时
 ↓
等 1 秒
 ↓
第二次成功
这就很适合 Retry。
什么错误不适合 Retry?
例如:
FileNotFoundError: config.py如果文件本来就不存在:
read_file("config.py")
read_file("config.py")
read_file("config.py")
不会凭空成功。
再比如:
PermissionError权限不变,重试没有意义。
所以真正应该先做:
错误分类
 ↓
判断 retryable
 ↓
再决定是否重试
Retry 需要最大次数
永远不要:
while True:
    try:
        ...
    except:
        continue
因为这会制造第二层死循环。
Agent Main Loop 有 Max Steps。
Tool Retry 自己也要有 Max Retries。
例如:
Agent Step 5
 ↓
Tool Retry 1
 ↓
Tool Retry 2
 ↓
Tool Retry 3
 ↓
失败 Observation
 ↓
交回 Agent
不要让 Tool 内部无限重试。
从图上看,Retry 应该始终被包在一个有限的恢复框架里:先判断错误是否真的可重试,再消耗一次 attempt;达到上限以后,把最终失败重新交回 Main Loop,而不是继续困在 Tool Executor 里。
这也是为什么 attempts 很值得放进 Tool Result。它不仅帮助模型知道“已经试过几次”,也方便后面的 Trace、成本统计和 AgentOps 判断某个 Tool 是否经常依赖重试才能成功。
一个可运行 Retry Executor
我们模拟一个“不稳定 Tool”。
第一次失败。
第二次成功。
结果会是:
第一次失败
第二次成功
attempts=2
这里的 max_retries=2 表示“初始尝试之外最多再试两次”,因此总尝试次数最多是 3。很多 SDK 把参数命名为 max_attempts,含义就可能是总共只执行两次;接入第三方重试库时,一定先确认计数口径,不然预算会悄悄多消耗一次。
为什么 Retry 最好发生在 Harness,而不是让 LLM 自己重复?
两种方式都可能存在,但含义不同。
Harness Retry 更适合:
同一个动作
同一组参数
短暂基础设施失败
例如:
HTTP Timeout这种错误没必要每次都再叫一次 LLM。
可以自动重试 1~2 次。
LLM Recovery 更适合:
需要改变策略
需要换参数
需要换 Tool
例如:
FileNotFoundError这时应该回到模型决策,而不是 Harness 无脑重复。
所以我们可以总结:
同一动作有机会自然成功
→ Harness Retry

同一动作逻辑上不会成功
→ 回到 Agent,重新决策
这两层恢复最好不要混在一起。Harness Retry 是执行层的小范围自愈,不改变动作语义;Agent Recovery 则意味着重新理解错误,可能换参数、换路径甚至换 Tool。把两条路径分开后,系统行为会更容易解释。
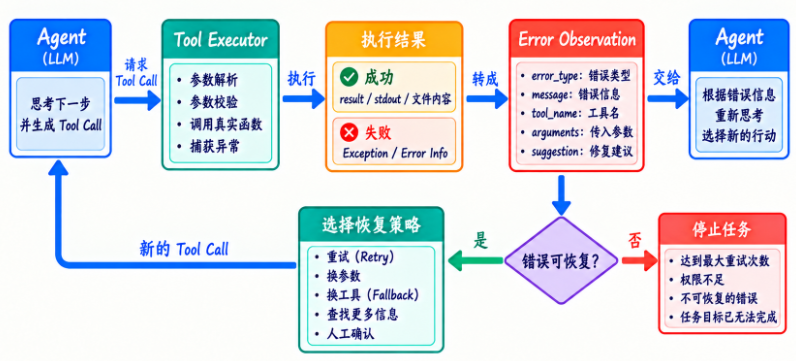
实际工程里可以把一句话记住:“原动作有机会自己恢复”交给 Harness;“必须改变策略才可能成功”交回 Agent。 这样既少浪费一次 LLM 调用,也不会让 Executor 越俎代庖地替模型做任务层决策。
Retry 还要不要加等待时间?
真实系统通常需要:
backoff例如:
1 秒
2 秒
4 秒
这一节我们先理解机制,不展开复杂网络重试库。
后面真实 Provider / API Tool 可以按需要加入指数退避。
工程里通常还会加入随机抖动 jitter,并优先遵守服务端返回的 Retry-After。等待也必须算进 Run 总超时,而且要能响应用户取消;如果 Agent 已经被取消,就不应该睡满退避时间后再发一次请求。
Retry 不能偷偷消耗无限成本
Tool Retry 次数也应该进入 Trace。
例如:
Tool: search_api
Attempts: 3
Result: success
因为重试会影响:
耗时
成本
外部接口配额
用户体验
所以后面 AgentOps 里也要统计。
















请登录后查看评论内容