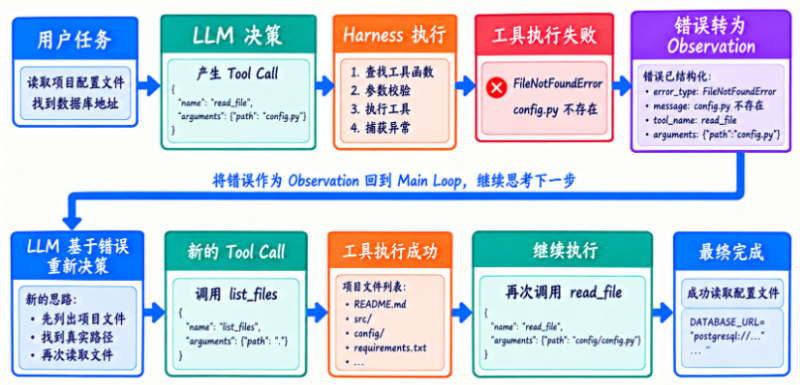


现在回到最开始的例子:
read_file("config.py")
 ↓
FileNotFoundError
Retry 没意义。
这时更适合,Fallback。
Fallback 可以理解成,当前动作失败以后,切换到另一种完成目标的方式。
切换以后还要确认语义有没有变化。实时接口失败后改读缓存,任务也许还能继续,但答案必须标明缓存时间;精确指标查不到时改用估算值,也不能再把结果描述成精确数据。Fallback 解决的是“还有没有替代路径”,不是把任何能返回数据的 Tool 都当成等价答案。
文件场景的 Fallback
原路径:
read_file("config.py")失败:
FileNotFoundErrorFallback:
list_files()得到:
config/config.py再:
read_file("config/config.py")这就是最典型的 Fallback。
把这个文件场景完整摊开以后,Fallback 的特点会非常直观:第一步失败带来了一个新事实——config.py 不存在;Agent 随后不是继续猜,而是调用 list_files 或 search_files 去获取真实环境信息,再使用新路径重新读取。
所以这里的“聪明”不在于提前知道 config/config.py,而在于利用失败 Observation 主动缩小不确定性。以后入口文件、日志位置、依赖配置找不到时,都可以沿用同样的思路。
Search Fallback
如果:
search_files("DATABASE_URL")没有结果。
可以:
search_files("db_url")或者先:
list_files()看目录。
数据分析场景的 Fallback
如果:
query_by_media结果为空。
可能:
Fallback 到更高层指标或者:
换数据源Fallback 不应该全写死在 Tool 内部
这点非常重要。
例如:
def read_file(path):
    try:
        ...
    except FileNotFoundError:
        自动 list_files
        自动猜路径
        自动重新读
看起来很智能。
但 Tool 职责就变复杂了。
更好的做法通常是:
Tool:
明确告诉 Agent 失败了

Agent:
基于 Goal + Error Observation
决定下一步 Fallback
因为,“找不到文件以后应该怎么办”
其实是任务层决策。
Tool 只负责,“我尝试读这个路径,结果不存在。”
这正是 Harness 分层。
Fallback 和 Retry 的区别
可以用一句话区分:
Retry:
同一个动作,再试一次

Fallback:
换一种动作继续完成目标
例如:
Retry:
query_api(params)
query_api(params)

Fallback:
read_file("config.py") 失败
→ search_files("config")
让 Agent 真正完成自主纠错
下面我们写一个完整可运行示例。
目标,读取 config.py。
真实文件却在:
config/config.pyAgent 第一次猜错。
然后自己恢复。
运行过程应该类似:
Step 1
read_file("config.py")
→ FileNotFoundError

Step 2
list_files()
→ ["config/config.py"]

Step 3
read_file("config/config.py")
→ 成功

Finish
这就是我们真正想要的自主纠错。
为什么这比“自动猜第二个路径”更 Agent?
因为恢复路径来自:
Observation而不是一开始就写死:
如果 config.py 不存在,
一定去 config/config.py。
模型通过:
list_files拿到真实环境信息后,再决定。
这才是动态纠错。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END
















请登录后查看评论内容