

有了 Retry 和 Fallback,很容易产生另一个问题,Agent 会不会为了“再试一下”一直跑?
答案是,会。
所以恢复机制一定要有边界。
第一层:Tool Retry 上限
例如:
max_retries = 2代表:
初始执行 1 次
+
最多重试 2 次
=
最多 3 次
这解决瞬时错误。
第二层:Agent Max Steps
即使每个 Tool 自己最多重试 2 次,整个 Agent 还是可能:
Tool A
Tool B
Tool C
Tool A
Tool B
...
所以 Main Loop 仍然需要:
MAX_STEPS第三层:同类错误重复次数
例如:
连续 3 次 FileNotFoundError即使路径不同,也说明 Agent 可能进入“乱猜文件名”模式。
这时可以:
注入 Reminder或者强制:
请先 list_files/search_files后面 System Reminder 一节会继续处理。
第四层:同一 Tool Call 重复检测
例如:
read_file("config.py")连续三次完全相同。
直接可以判断,这不是正常恢复。
可以停止或要求重新规划。
第五层:错误预算
更成熟一点,可以给一次 Run 设:
max_tool_errors = 8这样即使 Step 还没到上限,但错误过多,也可以终止。
因为错误越多,通常意味着:
- 模型策略不对;
- 环境异常;
- Tool Schema 有问题;
- Context 丢失;
- 任务本身不可完成。
这几层限制最好理解成一组套在一起的保险丝,而不是一个孤立的 max_retries。Tool 内部有限重试、Main Loop 的最大 Step、重复调用检测和全局错误预算共同决定了 Agent 什么时候应该继续,什么时候必须停。
尤其要注意,能恢复不代表必须恢复。当权限、安全策略、总超时或错误预算已经触发时,Harness 要拥有最终停止权,不能再让模型通过“换个 Tool 试试”绕过边界。
一个带 Retry Budget 的执行器
Retry Policy 应该属于谁?
后面可以放在:
Tool Metadata例如:
read_file
max_retries=0

query_api
max_retries=2

run_shell
max_retries=0
因为不同 Tool 的适合策略不同。
这也是 Tool Registry 后面会不断变强的原因。
什么时候必须直接 FAILED?
一些错误不应该恢复。
例如:
权限策略明确拒绝
用户取消
任务超过总超时
MAX_STEPS_EXCEEDED
安全规则触发
当前 Run 已经被标记 FAILED
此时不应该让模型,“再想想办法绕过去。”
Harness 必须拥有最终控制权。
Error Recovery 的目标不是“永远成功”
这一点非常重要。
真正成熟的 Agent 并不是,“无论如何都要完成。”
而是,能恢复时合理恢复,不能恢复时清楚失败。
一个明确:
{
  "status": "FAILED",
  "reason": "MAX_TOOL_ERRORS_EXCEEDED"
}
比无限尝试更专业。
把能修正的错误交回循环
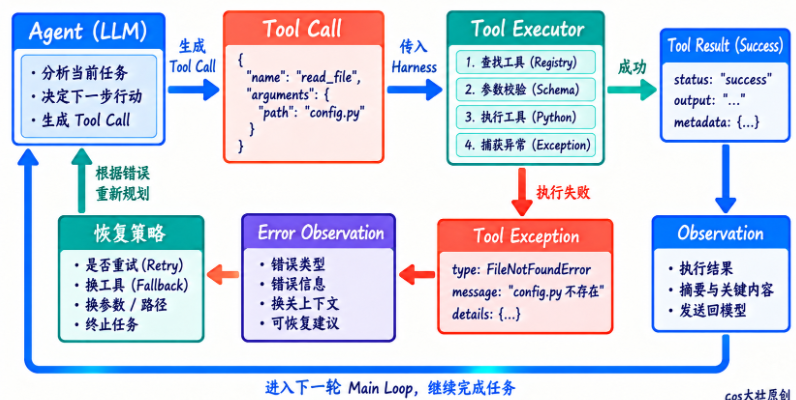
我们让 Agent 读取一个不存在的文件。这个错误说明路径假设不成立,下一步可以列目录。若异常直接冒泡到 Engine 最外层并把 Run 标记为 FAILED,模型就失去了修正机会。配套 AgentEngine 因此提供了显式的 recover_tool_errors 开关:默认保持快速失败,只有确认 Tool 可以安全重试的运行链路才开启错误 Observation。
对照项目代码看,ToolSpec 已经有 idempotent 元数据,RunGuard 也限制最大 Step、最大 Tool Call 和总运行时间。Tool Schema 参数错误会直接形成带字段路径的 Observation;开启 recover_tool_errors 后,Tool 执行期的参数、类型和白名单错误也会被包装成结构化 Tool Message,保留在 Trace、Tool History 与 Checkpoint 中,再交给下一轮模型修正。最终 Data Analysis Agent 只对受控的只读 Query Tool 开启它;普通 Engine 和副作用 Tool 仍默认快速失败,避免把未知写入结果误当成可以放心重试。
当前接入顺序是:Middleware 先做权限检查,Registry 做 Schema 校验,Executor 执行 Tool,再把成功或可恢复失败写成对应 tool_call_id 的 Tool Message;只有预算、安全策略、Provider 故障或未知副作用等终止条件触发,才把整个 Run 结束。权限拒绝不会包装成“换个工具试试”,否则恢复机制反而会变成绕过安全规则的入口。
可以先把错误分为参数错误、环境反馈、瞬态故障、权限拒绝和结果未知。参数错误适合根据提示修正;测试失败提供诊断证据;限流可以按剩余预算退避;权限拒绝不能通过换工具绕开;非幂等写入的未知结果则需要核查。分类比统一 retryable=true 更有用。
重试应共享任务总预算,并考虑外部服务的等待建议。指数退避和 jitter 用于减少并发请求再次撞在同一时刻,熔断则用于持续故障期间暂停冲击服务。Fallback 也可能改变数据来源或语义,因此需要说明替代结果是否仍满足原任务。
动手验证:错误是否推动了下一步
准备“文件不存在”“API 限流”“写入结果未知”三个案例。参考行为分别是重新定位路径、在预算内退避、查询状态或请求核实。若三个案例都简单重试三次,即使最终没有崩溃,也还不能证明恢复策略合理。
















请登录后查看评论内容