

前面几节,我们已经把 Agent 的工具系统搭得越来越完整了。
模型会产生 Tool Call。
Tool Registry 能找到真实函数。
Tool Schema 会告诉模型每个工具怎么用。
上一节我们甚至已经实现了:
read_file
write_file
edit_file
list_files
search_files
run_python
run_shell
到这里,一个 Agent 已经能真正“做事”了。
但只要它开始真的和环境交互,错误一定会出现。
比如:
Agent:
读取 config.py

Tool:
FileNotFoundError
如果系统的处理方式是:
失败
 ↓
Agent 结束
那么这个 Agent 其实非常脆弱。
因为真实世界从来不是“每一步都成功”。
文件可能不存在。
路径可能猜错。
网络可能超时。
参数可能不完整。
SQL 可能返回空结果。
Shell 命令可能执行失败。
测试可能失败。
权限可能被拒绝。
真正有价值的 Agent,不是“从不犯错”,而是,它能把错误当成新的环境信息,然后修正下一步。
不过,并不是所有“不成功”都叫 Tool Error。我们先把三个层次分开:
Tool 执行错误:工具不存在、参数不合法、超时、权限拒绝
环境真实结果:pytest returncode=1、查询结果为空、编译失败
Agent 任务失败:超过预算、触发安全边界、已经没有合理恢复路径
pytest 没通过,往往说明执行工具工作正常,只是环境给出了失败证据;读取路径不存在,则是一次动作失败,但任务仍然可能继续;只有恢复边界被用尽,整个 Run 才应该进入 FAILED。先分清层次,后面的 Retry 和 Fallback 才不会混在一起。
这一节,我们会正式把 Agent 从“会调用 Tool”推进到,“Tool 失败以后还能继续完成任务。”
这也是 Agent 第一次真正具备比较明显的“自主纠错能力”。
开场引入
我们先看一个很普通的任务,“帮我读取项目配置文件,看看数据库地址配置在哪里。”
模型根据经验猜:
{
  "name": "read_file",
  "arguments": {
    "path": "config.py"
  }
}
Harness 真正执行:
FileNotFoundError: config.py如果这是普通函数调用,我们可能直接抛异常。
但对于 Agent 来说,这个错误其实告诉了我们一件很重要的事,“刚才关于路径的假设错了。”
这不是“什么都没得到”。
恰恰相反,它是一个新的 Observation。
更合理的 Agent 路径应该是:
读取 config.py
  ↓
FileNotFoundError
  ↓
判断:路径猜错
  ↓
list_files
  ↓
发现 config/config.py
  ↓
重新 read_file
  ↓
成功
这里真正发生的是:
失败
不是终点
而是下一轮 Reason 的输入
我们把它写成更完整的闭环:
Reason
  ↓
Action
  ↓
Tool Error
  ↓
Error Observation
  ↓
Reason
  ↓
Recovery Action
  ↓
New Observation
这就是 Tool Error Recovery。
很多人第一次做 Agent,会把“Retry”理解成:
try:
    ...
except:
    再执行一次
但真正成熟的恢复逻辑远不止“再试一次”。
因为不同错误代表不同策略。
例如:
Timeout可能适合:
Retry但:
FileNotFoundError如果路径还是原来的:
config.py你重试 10 次也没用。
它更适合:
Fallback 到 list_files / search_files再比如:
PermissionError通常不应该继续自动重试。
因为权限不会因为你多试几次突然变好。
所以真正的错误恢复至少要回答:
错误是什么?
可不可以恢复?
该不该重试?
重试什么?
要不要换 Tool?
要不要换参数?
最多试几次?
什么时候必须停?
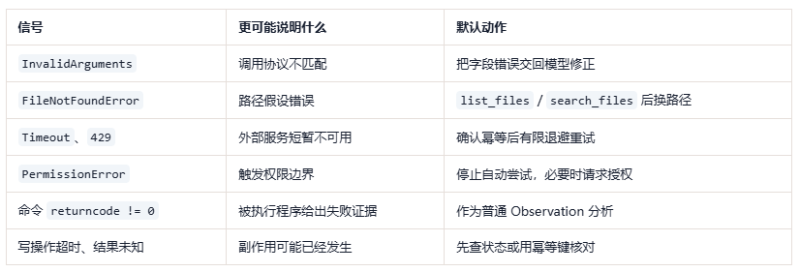
我们可以先用一张小表建立默认判断。它不是死规则,但足够帮我们避开大多数机械重试:
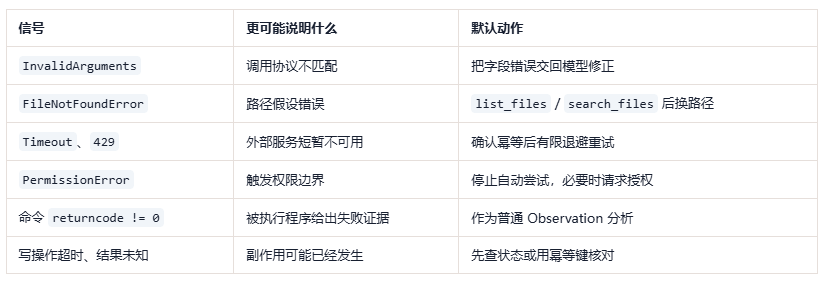
最后一行尤其值得注意:超时只说明“我们没按时拿到结果”,不一定说明“对方什么都没做”。如果工具会发送消息、创建订单或写入数据,盲目重试可能把一次操作变成两次。
把这几类错误放在一起看,会发现恢复策略其实不是由“失败”两个字决定,而是由失败背后的语义 决定。下面这张图把常见错误和后续动作放在同一条链路里,大家可以先建立一个默认判断框架。
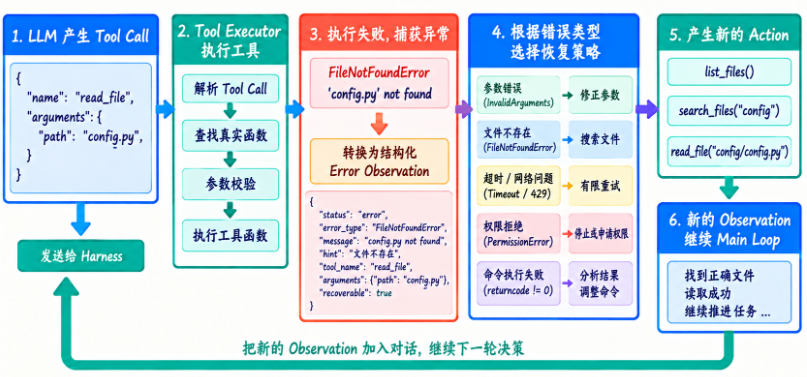
例如 FileNotFoundError 的问题通常是“路径假设错了”,自然应该换路径或搜索;Timeout 更像“环境暂时不稳定”,才有有限 Retry 的价值。先做分类,再谈恢复,比统一写一个 retryable=true 稳定得多。
这也是为什么这一节非常重要。
它让 Agent 从“会执行动作”升级成“会根据执行结果纠正动作”。
知识地图
这一节会把 Tool Error 正式纳入 Main Loop。
我们还可以把“自主纠错”压缩成:
Tool Error
   ↓
理解错误类型
   ↓
选择恢复策略
   ↓
产生新的 Action
   ↓
重新验证
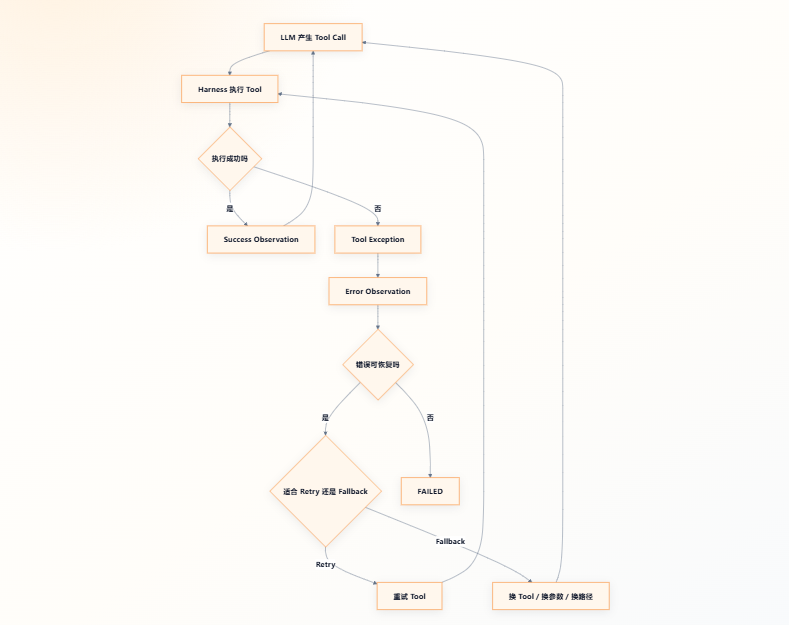
如果把刚才的 Mermaid 再换成一张更偏执行过程的图,会更容易看清 Error Recovery 在 Main Loop 里到底插在什么位置:Tool 成功时,结果正常回流;Tool 失败时,并不是直接把 Run 打断,而是先把异常整理成模型能够继续理解的 Error Observation。
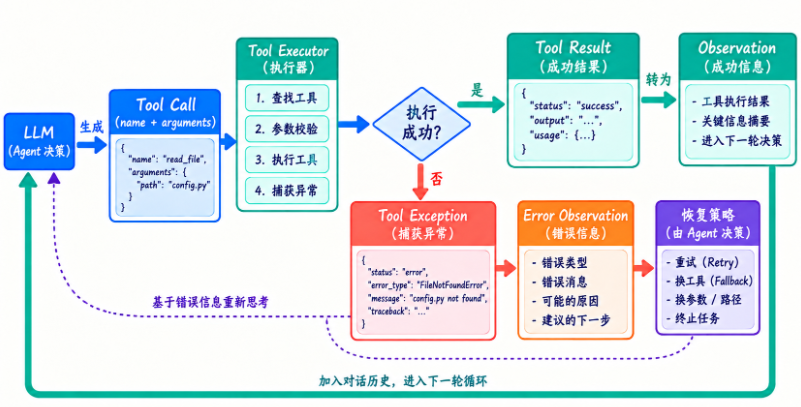
这张图最值得注意的是下面那条回路。恢复的本质不是把错误藏起来,而是把错误变成下一轮决策可用的信息。 只有到了不可恢复、安全边界或预算耗尽这类终止条件,Harness 才真正结束整个 Run。
















请登录后查看评论内容