

前面三节,我们已经把 Agent 的 Context Engineering 基础骨架逐步搭起来了。
第 12 节,我们实现了 ContextBuilder,开始理解真实 Agent 的输入并不只是:
System Prompt
+
用户问题
而是:
System Prompt
+
Agent Rules
+
AGENTS.md
+
Skills
+
Memory
+
Conversation
+
Tool Results
+
Current Task
第 13 节,我们又加上 Working Memory,让 Agent 不需要每一轮都从完整历史重新理解“我现在做到哪里”。
第 14 节,我们继续实现了 SessionManager,让:
messages
working_memory
tool_history
runs
能够围绕 session_id 持续保存。
到这里,一个真正的问题开始出现,这些东西会越来越多。
如果 Agent 工作 3 轮,没什么。
如果工作 10 轮,问题还不明显。
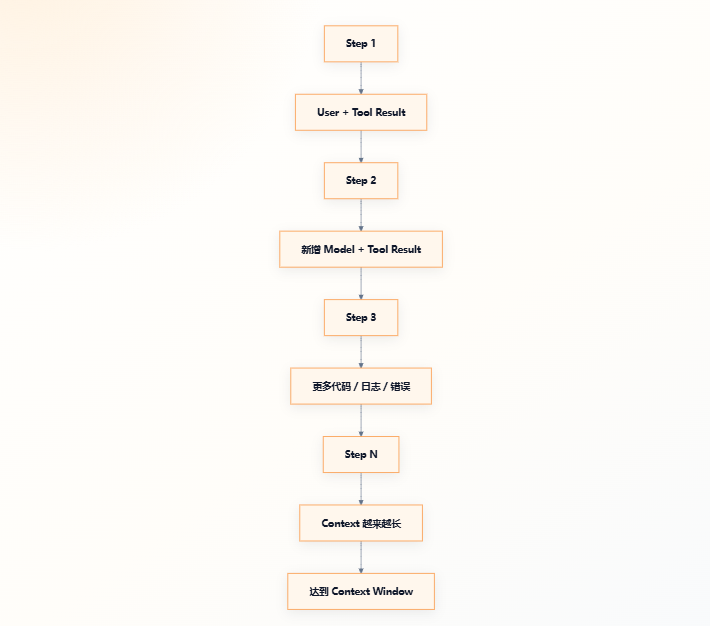
如果一个 Coding Agent 连续跑 30~50 轮,读取多个代码文件、执行测试、修改代码、重新测试、继续排查,你会发现 Context 会像滚雪球一样越来越大。
最常见的累积来源包括:
用户消息
模型消息
Tool Result
代码文件
运行日志
报错信息
SQL 结果
测试输出
搜索结果
Working Memory
Project Rules
Skills
……
这些内容最终都会以某种形式进入模型输入。
但模型一次能接收的上下文不是无限的。
它受到,Context Window
限制。
所以这一节我们要真正回答,Context Window 到底是什么?为什么会爆?为什么 Agent 比普通 Chatbot 更容易爆?
更重要的是,我们要建立一个工程意识:Context Window 不是“模型厂商给你的一个参数”,而是 Agent Runtime 必须主动管理的资源。你如果不监控它,最终就会在最难排查的时候遇到“突然忘记规则”“突然重复调用”“API 直接拒绝请求”这些问题。
开场引入
我们先模拟一个很常见的 Coding Agent。
用户说,“帮我修复这个 Python 项目为什么 pytest 一直失败。”
Agent 第1轮:
list_files()Tool Result:
README.md
requirements.txt
src/app.py
src/service.py
tests/test_app.py
tests/test_service.py
...
第2轮:
read_file("README.md")返回 2000 字。
第3轮:
run_shell("pytest -q")返回 300 行测试日志。
第4轮:
read_file("tests/test_service.py")返回 5000 字。
第5轮:
read_file("src/service.py")返回 8000 字。
第6轮:
edit_file(...)返回修改结果。
第7轮:
run_shell("pytest tests/test_service.py -q")又返回 150 行日志。
第8轮:
search_files("DATABASE_URL")返回 40 条命中。
第9轮:
read_file("src/config.py")又是 6000 字。
第10轮:
run_shell("pytest -q")又是几百行。
如果每一轮我们都把之前所有内容完整放回下一次请求中,那么第10轮的模型输入里,可能已经包含:
System Prompt
Agent Rules
AGENTS.md
Working Memory
用户初始任务
模型前9轮输出
前9轮 Tool Results
代码文件全文
测试日志
错误堆栈
当前任务
这还只是 10 轮。
如果是 30 轮呢?
如果读了 20 个源文件呢?
如果某次 Tool 返回了 1 MB 日志呢?
很快就会触碰模型的上下文上限。
这时你可能遇到几种典型表现。
第一类是最直观的:
请求被模型 API 拒绝
Context length exceeded
第二类更隐蔽:
系统为了适配模型,截断前面的消息然后 Agent 开始:
忘记最初目标
忘记项目规则
忘记已经完成的动作
第三类甚至没有任何显式报错。
Context 还在模型窗口以内,但里面已经堆了太多:
旧错误
旧日志
重复代码
过期计划
无关 Tool Result
模型每轮都要重新从巨大信息堆里找当前重点。
于是你会看到:
重复读取已经看过的文件
重新调查已经排除的问题
忽略高层规则
被某一段长日志带偏
所以 Context Window 问题,不只是,“API 会不会报错。”
它更像一个长期运行 Agent 的“内存管理问题”。
如果只知道“窗口很大”,却不知道:
谁在占空间
什么时候开始危险
哪些能删
哪些不能删
Agent 最终一定会变得越来越难控制。
这一节先把 Context Window 与 Token 的底层关系看清楚,然后我们再模拟几十轮 Agent 的增长,并给 ContextBuilder 增加基础监控。下一节才正式实现 Context Compaction,把旧内容压缩成更短、更稳定的记忆。
知识地图
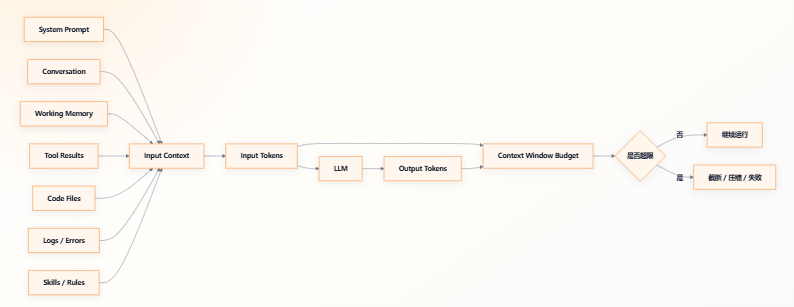
再看 Agent 多轮增长:
















请登录后查看评论内容