

1.4.1 大语言模型基础知识
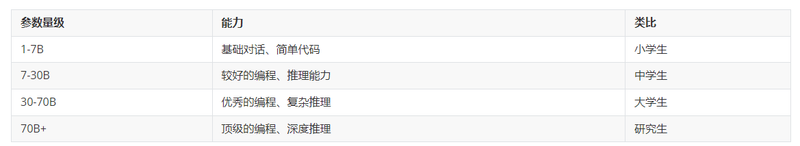
参数量:模型的”大脑”大小
你可能听说过”7B模型”、”70B模型”这样的说法。这里的 B 是 Billion(十亿)的缩写,指的是模型的参数数量。简单理解:参数越多,模型越”聪明”,但也越慢、越贵。
提示:参数量不是唯一标准。训练数据的质量、训练方法的优化同样重要。有些小参数模型经过精细调优后,在特定任务上可以媲美大模型。
上下文窗口:再次强调的核心概念
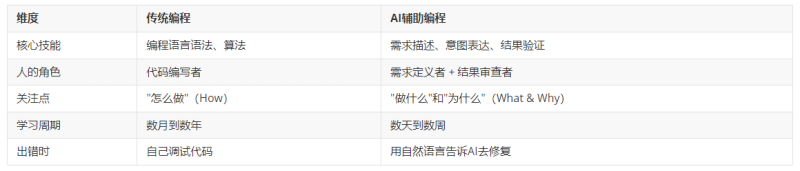
对AI编程来说,上下文窗口直接决定了AI能”看到”你项目中多少代码。窗口越大,AI对项目的理解越全面,生成的代码越准确。
4K Token   ≈ 一个文件      → 只能看到当前文件
32K Token  ≈ 几个文件      → 能看到相关的几个文件
128K Token ≈ 一个小项目    → 能理解整个小项目
200K Token ≈ 一个中型项目   → 许多主力模型的长上下文起点
1M Token   ≈ 一个大型项目   → Claude / Gemini / GPT 等旗舰模型的超长上下文级别
Token 计费:你的”油费”
使用AI模型就像开车需要加油 —— Token 就是你的”油”,用多少付多少。
费用 = 输入Token数 × 输入单价 + 输出Token数 × 输出单价
Temperature:AI的”创造性开关”
Temperature 是一个 0-1 之间的参数,控制AI回复的”随机性”:
- Temperature = 0:每次给出几乎相同的答案(最确定性)→ 适合代码生成
- Temperature = 1:每次答案都不同(最随机)→ 适合创意写作
提示:编写代码时,通常不需要手动调整 Temperature。Claude Code 默认使用适合编程的低 Temperature 值。
1.4.2 Claude 系列(Anthropic)
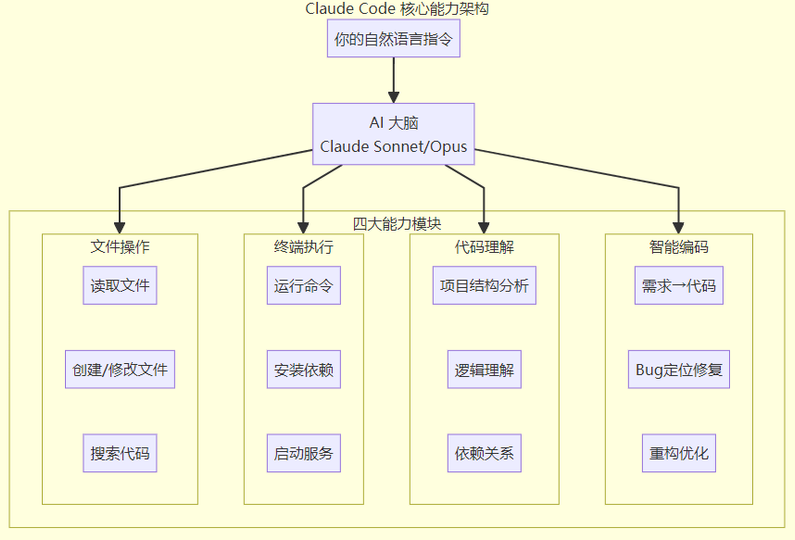
Claude 是本教程推荐的主力模型,由 Anthropic 公司开发。
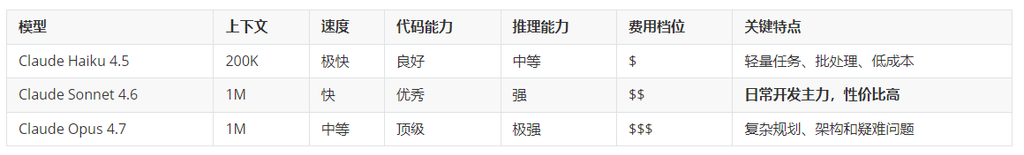
核心优势:
- 超长上下文(200K 到 1M,随模型不同而变化),项目级代码理解能力强
- 代码生成质量在业界领先
- 指令遵循能力精确(你说什么,它就做什么)
- 安全对齐好(不容易生成危险代码)
1.4.3 GPT 系列(OpenAI)
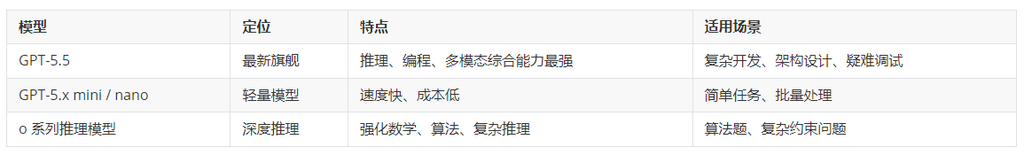
核心优势:多模态能力强、工具调用生态成熟,和 Codex / ChatGPT / OpenAI API 的集成最完整。
适合场景:将UI截图转换为代码、需要视觉理解的任务。
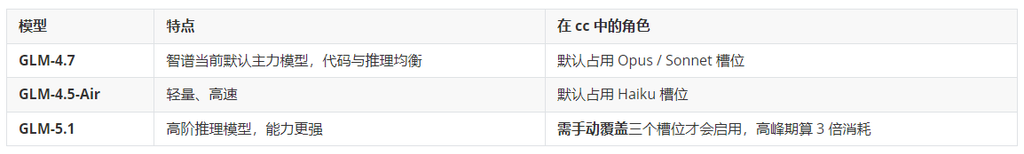
1.4.4 GLM 系列(智谱AI)
智谱AI的GLM系列(配套 CodeGeex 代码助手),中文能力和代码能力均衡,国内可用。
1.4.5 DeepSeek 系列 国内推荐
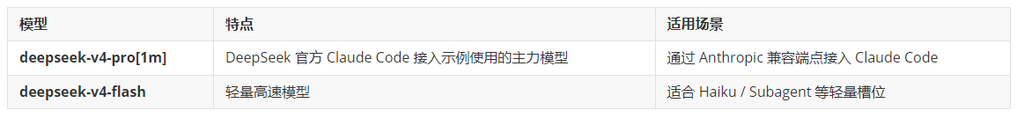
注意: 模型名与后续变化请以 DeepSeek 官方文档 为准。
核心优势:
- 极致性价比:价格远低于官方 Claude
- 代码能力强,接近 Claude Sonnet 水平
- 国内直连,注册简单
- 官方为 Claude Code 提供了专用的 Anthropic 兼容端点,适配度高
1.4.6 通义千问系列(阿里云)
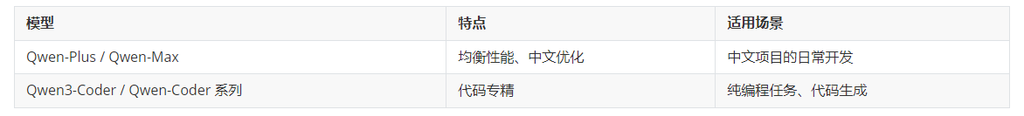
核心优势:中文理解能力出色、国内直连、阿里云生态集成。
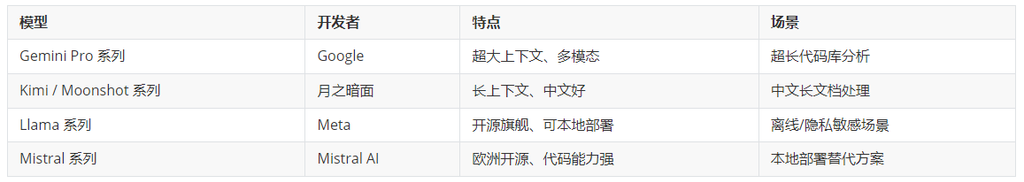
1.4.7 其他值得关注的模型
1.4.8 模型选型实战指南
1.4.8.1 选型决策树
面对一个编程任务时,按以下流程选择模型:
你的任务是什么?
│
├── 简单任务(代码补全、格式化、小修改)
│   ├── 追求最快速度 → Claude Haiku / GLM-4.5-Air / 本地 Qwen
│   ├── 追求最低成本 → DeepSeek API / 本地 Ollama
│   └── 完全免费 → 本地 Ollama 模型
│
├── 日常开发(功能实现、Bug修复、代码生成)
│   ├── 英文项目 → Claude Sonnet (首选)
│   ├── 中文项目 → Claude Sonnet 或 通义千问 / GLM-4.7
│   └── 预算紧张 → DeepSeek V4 / GLM / Kimi
│
├── 复杂任务(架构设计、算法难题、疑难Bug)
│   ├── 深度推理 → Claude Opus / GPT-5.5 / DeepSeek V4 Pro
│   └── 超长代码库 → Gemini Pro (1M上下文)
│
└── 特殊场景
   ├── 离线/隐私要求 → 本地 Ollama + Llama/Qwen
   ├── 截图→代码 → GPT-5.5 / GPT-4o 系列(多模态)
   └── 国内直连要求 → DeepSeek / 千问 / GLM
1.4.8.2 成本优化策略
策略一:分层使用
简单任务 ──→ Haiku / GLM-4.5-Air / 本地 Qwen(成本:$)
日常任务 ──→ Sonnet / DeepSeek V4 Pro      (成本:$$)
复杂任务 ──→ Opus / GLM-5.1              (成本:$$$$)
不要所有任务都用最贵的模型,就像不是每次出门都需要打专车。
策略二:Prompt Cache(缓存利用)
Claude 和 GPT 都支持 Prompt Cache —— 如果你发送的上下文中有大量重复内容(如每次都发送同一个 CLAUDE.md),后续请求可以复用缓存,显著降低重复上下文的输入成本。
策略三:本地模型补充
对于简单的代码格式化、注释生成等任务,可以使用 Ollama 部署的本地模型,完全免费。
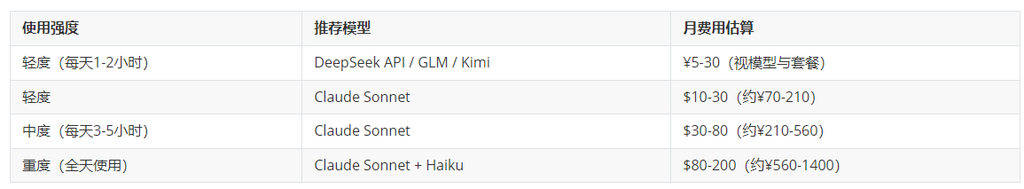
一个月的费用预估:
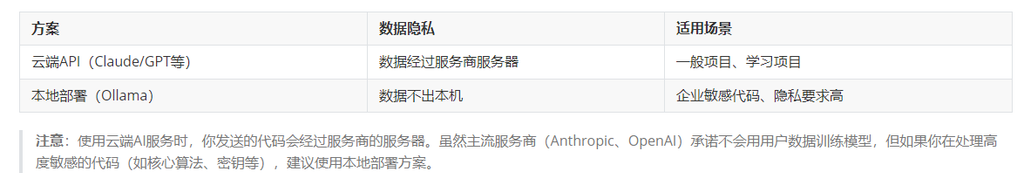
1.4.9 安全与隐私考量
1.5 本部分小结
核心概念回顾:
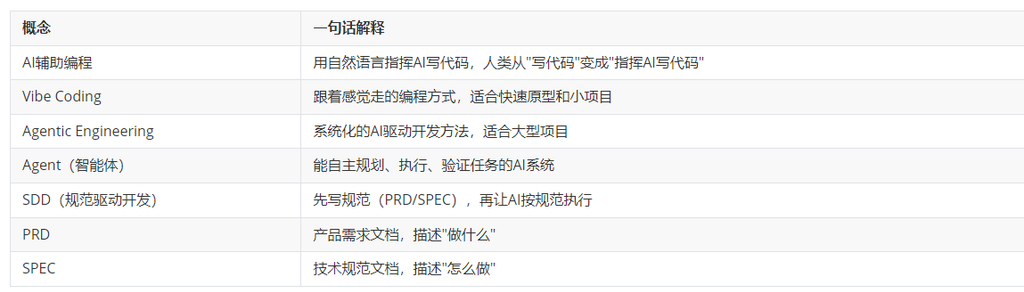
三者的关系:
Vibe Coding(感觉驱动)
   ↓ 项目变大、需要更多控制
Agentic Engineering(系统化方法)
   ↓ 需要精准的沟通"合同"
SDD(规范驱动开发)











请登录后查看评论内容