


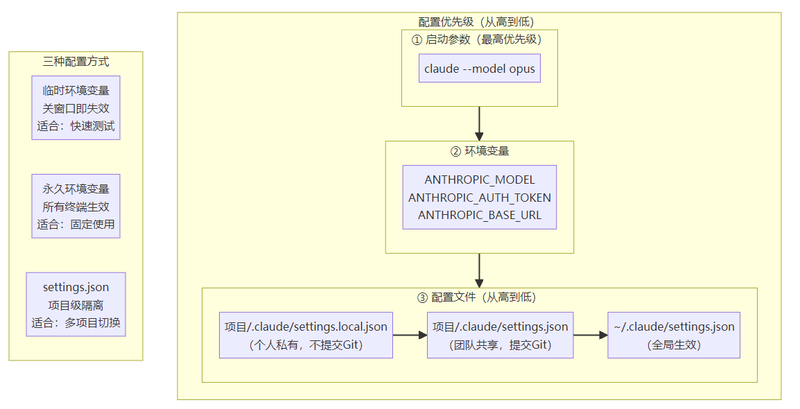
Claude Code 有多层配置体系,从全局到项目级,层层覆盖。
配置层级:
全局配置(影响所有项目)
└── ~/.claude/settings.json
项目级配置(只影响当前项目)
└── 项目根目录/.claude/settings.json
项目上下文文件(告诉AI项目背景信息)
└── 项目根目录/CLAUDE.md ← 最重要!
3.2.1 settings.json 配置文件
Claude Code 的配置文件位于 ~/.claude/settings.json(全局)或项目目录下的 .claude/settings.json(项目级)。
常用配置项:
{
  // 允许 Claude Code 执行的操作(不再需要每次确认)
  "permissions": {
   "allow": [
     "Read",        // 读取文件
     "Write",       // 写入文件
     "Bash(npm *)",   // 执行 npm 命令
     "Bash(git *)",   // 执行 git 命令
     "Bash(node *)"   // 执行 node 命令
   ],
   "deny": [
     "Bash(rm -rf *)" // 禁止执行危险的删除命令
   ]
  },
  // 默认使用的模型
  "model": "sonnet",
  // 自动紧凑阈值(上下文使用超过此比例时自动压缩)
  "autoCompactThreshold": 80
}
注意:权限设置要谨慎。过于宽松的权限可能导致AI执行你不期望的操作。建议初学者保持默认设置,让 Claude Code 在执行每个操作前都询问你确认。
3.2.2 CLAUDE.md:你的项目”说明书”
CLAUDE.md 是 Claude Code 中最重要的配置文件之一。它就像你给新来的实习生写的”项目入职手册” —— 告诉AI这个项目的背景、技术栈、编码规范和当前进度。
为什么 CLAUDE.md 如此重要?
没有 CLAUDE.md 时,Claude Code 每次开始工作都要花时间”重新认识”你的项目。有了 CLAUDE.md,它一启动就知道项目的全部背景,效率大幅提升。
CLAUDE.md 模板(可直接复制修改):
# 项目名称
## 项目概述
一句话描述这个项目做什么。
## 技术栈
- 前端:Next.js 14 + TypeScript + Tailwind CSS
- 后端:Next.js API Routes
- 数据库:Prisma + SQLite
- 部署:Vercel
## 项目结构
•```
src/
├── app/ # Next.js App Router 页面
│ ├── api/ # API 路由
│ ├── layout.tsx # 全局布局
│ └── page.tsx # 首页
├── components/ # React 组件
│ ├── ui/ # 通用UI组件
│ └── features/ # 业务组件
├── lib/ # 工具函数和配置
├── prisma/ # 数据库 schema 和迁移
└── types/ # TypeScript 类型定义
•```
## 编码规范
- 使用函数式组件 + React Hooks
- 组件文件使用 PascalCase 命名(如 BookmarkCard.tsx)
- 工具函数使用 camelCase 命名
- API 路由返回统一格式:{ success: boolean, data?: any, error?: string }
- 所有数据库操作通过 Prisma Client 执行
## 当前开发状态
- 项目初始化完成
- 数据库 Schema 设计完成
- 书签 CRUD API 开发中
- 前端页面待开发
- 搜索功能待开发
## 注意事项
- SQLite 数据库文件在 prisma/dev.db,不要提交到 Git
- 环境变量在 .env 文件中,不要提交到 Git
- 所有新功能先创建 Git 分支再开发
CLAUDE.md 的三个层级(由顶向下叠加生效):
很多人只知道 CLAUDE.md 可以放在项目根目录,其实官方设计了 3 个层级的 CLAUDE.md,它们会同时生效、不冲突:
| 层级 | 路径 | 作用范围 | 适合写什么 |
|---|---|---|---|
| 全局级 | ~/.claude/CLAUDE.md | 所有项目都会读 | 个人习惯、身份、翻译偏好(如”永远用中文回答”、”我是 xx、从事 xx”) |
| 项目级 | 项目根目录/CLAUDE.md | 仅本项目 | 项目技术栈、架构、规范、进度(可提交 Git,团队共享) |
| 文件夹级 | 子目录/CLAUDE.md | 仅该子目录 | 模块专属约定(如 src/payment/CLAUDE.md 写支付模块踩过的坑) |
三层叠加生效,不冲突。优先级:文件夹级 > 项目级 > 全局级。
两个官方推荐的创建姿势:
/init创建项目级:在项目根目录下运行claude后输入/init,cc 会自动扫描项目并生成一份 CLAUDE.md 初稿,你再调整。官方建议:项目有一定规模再/init效果更好(太空它扫不出什么东西)。/memory编辑全局级:在 cc 会话里输入/memory选择“全局 CLAUDE.md”,会用默认编辑器打开该文件供你修改。修改全局后需重启 cc 才生效。
最佳实践:
- 保持更新:项目级 CLAUDE.md 应该是动态的——项目加了功能、踩了坑,就同步更新
- 足够具体:技术栈写明具体版本号,目录结构要与实际一致
- 写明禁忌:把”不要做什么”也写清楚(如”不要修改数据库迁移文件”)
- 适度简洁:不要写成论文,AI需要的是关键信息而非赘述
- 只放”顶层不变原则”:随着实践你会发现,CLAUDE.md 不该塞太多。卡帕西发布的「claude.skills」几百行通用规则就能拿 10 万+ Star——写点 “顶层、不变、须严守” 的东西就够了。https://github.com/multica-ai/andrej-karpathy-skills
3.2.3 第二层记忆:Auto Memory(cc 自己的笔记本)
如果说 CLAUDE.md 是你主动立下的规矩,那 Auto Memory 就是 cc 在干活过程中默默记下的设计笔记。你没显式写进 CLAUDE.md 的习惯、反馈、项目踩坑,会被一个后台 agent 静静记录。
如何启用:
# 在 cc 会话中输入
/memory
# 在弹出的菜单里选第一个选项 “启用 Auto Memory”
# 启用后菜单里会多出“打开自动记忆文件夹”选项
Auto Memory 会记哪几类东西:
| 类型 | 含义 | 举例 |
|---|---|---|
user | 关于你 | 你的角色、偏好(如“不喜欢深色 UI”) |
feedback | 你给过的反馈 | “不要这样做”、“对,就这样” |
project | 项目相关 | 进度、决策、技术选型 |
reference | 外部资源索引 | “某份设计文档在 docs/design.md” |
使用手感(重要):
- 它只在当前项目生效(文件存在项目目录下),换项目需重新积累
- 启用后 cc 不会每次都把所有记忆全部加载进上下文,只会读一份
memory.md索引——遇到具体问题才去读对应的子文件,占 token 很少 - 随时可以用快捷键
Ctrl+O在会话中查看实际被调用过的记忆内容 - 记错了就跟它说:“忘掉刚刚说的不喜欢深色主题”,它会自己删掉
提示: 一句话区分 CLAUDE.md vs Auto Memory:CLAUDE.md 是第一优先级、全量注入的明规则;Auto Memory 是第二优先级、按需注入的隐规则。两者配合,cc 越用越懂你。
3.2.4 第三层记忆:自建参考文档(渐进式披露)
除了上面两层,你还可以仿照 Skill 的”渐进式披露“机制为 cc 手动打造一套专项参考文档。
应用场景:某些东西不适合全部塞进 CLAUDE.md(太长、太专门),但 cc 需要的时候必须能查到。比如做个产品,你希望:
- 品牌视觉规范:颜色、字体、间距 →
docs/brand-visual.md - 产品文本风格:语调、术语表 →
docs/copywriting-style.md - API 约定:请求响应格式、错误码 →
docs/api-conventions.md
然后在 CLAUDE.md 里加上指引:
## 外部参考文档
- 修改前端视觉、调颜色、调间距时 → 必读 `docs/brand-visual.md`
- 写产品文案、按钮文字、提示语时 → 必读 `docs/copywriting-style.md`
- 写 API 、定义返回格式时 → 必读 `docs/api-conventions.md`
这样 cc 只在”需要的时候”才去读完整文档,既保证了准确性,又不占多余上下文。
3.2.5 三层记忆总览
Claude Code 的三层记忆体系:第一层 CLAUDE.md(你主动写,全量加载)→ 第二层 Auto Memory(cc 自己记,按需读取)→ 第三层自建参考文档(你写,cc 遇到对应任务才读)。
| 层 | 位置 | 优先级 | 加载方式 | 谁在维护 |
|---|---|---|---|---|
| 1 | CLAUDE.md(三级) | 高 | 会话启动全量加载 | 你手动维护 |
| 2 | Auto Memory | 中 | 先读索引、按需读子文件 | cc 自己写、你校对修改 |
| 3 | 参考文档 | 按需 | cc 遇到对应任务才读 | 你手动维护 |
本质认知:agent 的所有”记忆”,本质上都是在合适的时候向大模型注入压缩过的上下文。粗暴点说 —— 这些记忆机制本质上还是提示词工程,只不过由 cc 帮你组织了层次。
3.2.6 .claudeignore 文件
类似于 .gitignore,用来告诉 Claude Code 哪些文件/目录不需要关注:
# .claudeignore 示例
node_modules/      # 依赖包目录(太大了,AI不需要看)
.next/            # Next.js 构建产物
dist/            # 编译输出
*.log            # 日志文件
.env             # 环境变量(包含敏感信息)










请登录后查看评论内容