




3.5 数据清洗与预处理
章节核心内容关键知识点1. 缺失值处理检测、删除和填充缺失值的方法isna(), dropna(), fillna(), 前向/后向填充, 均值/中位数填充2. 重复数据处理识别和删除重复行 duplicated(), drop_dup...
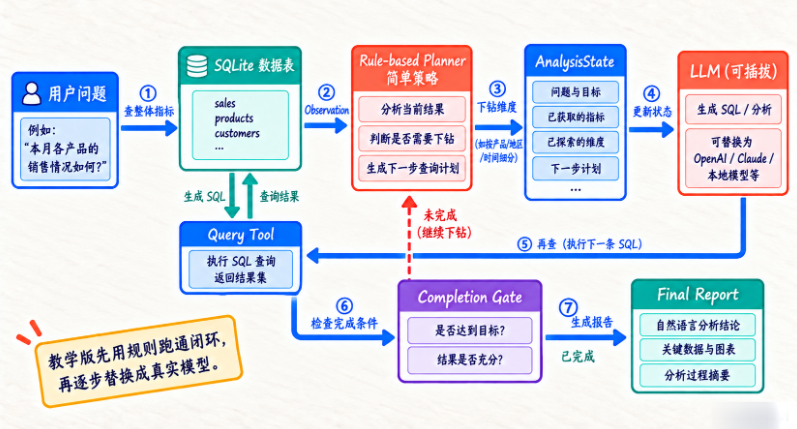
小节四:实现一个真正可运行的最小 Data Analysis Agent——用 SQLite 模拟完整异常分析闭环
到了可运行示例,最值得抓住的是任务怎样从一次查询转成下一次查询。教学版先用 SQLite 和明确的决策规则走通完整链路,再把决策组件替换为真实模型。 注意观察每次 Query Result 怎样更新 Anal...
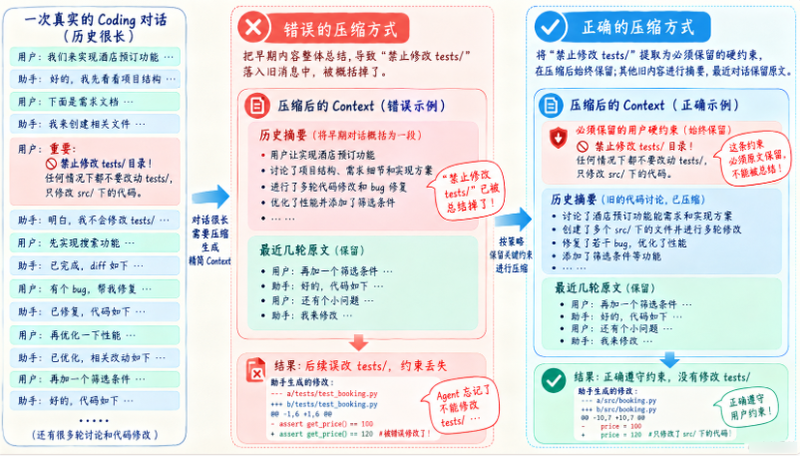
案例分析一:Coding Agent 运行 40 步,如何压缩而不丢失“禁止修改 tests/”?
这个案例很典型,也很适合配合图来看。因为很多 Agent 在长对话里出问题,不是不会写代码,而是把用户最重要的硬约束压没了。下面这张图把错误压缩方式和正确压缩方式放在了同一页里,对比会特...
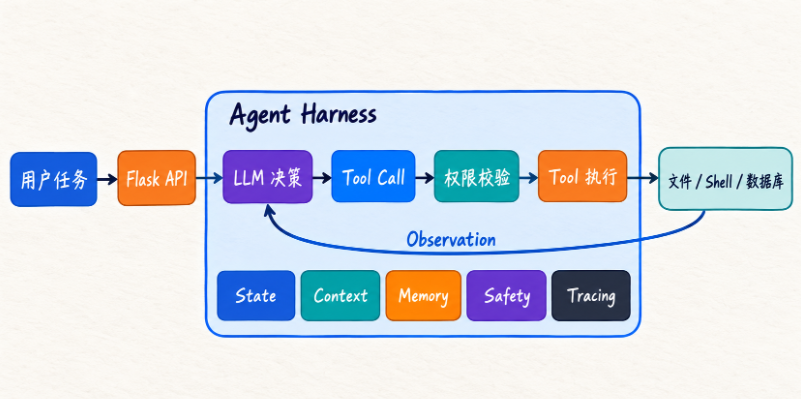
为什么现在需要自己理解 Agent Harness?
我们最终要实现的是这样一条完整链路: 用户提出任务 ↓ Flask API ↓ Agent Harness ↓ LLM 思考与决策 ↓ 选择 Tool ↓ 执行 Tool ↓ 获取 Observation ↓ 继续决策 ↓ 完成任务 最终这个 Age...
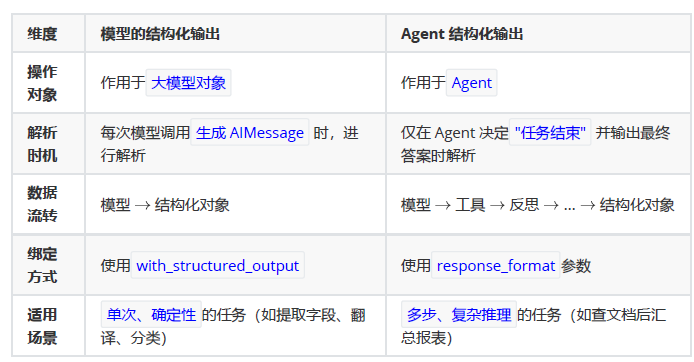
7、Agent的高级用法3:结构化输出
结构化输出是Agent的核心功能之一,它允许Agent以特定、可预测的格式返回数据,而不是传统的自然语言响应。通过结构化输出,开发者可以直接获得Pydantic模型、JSON对象或数据类等结构化数据,这...
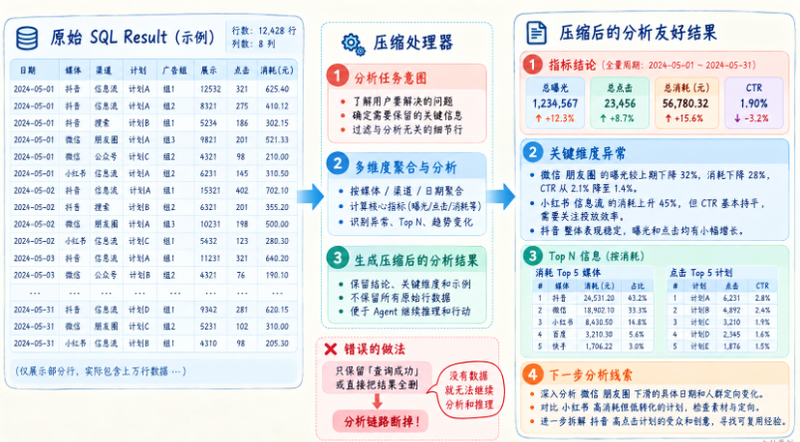
案例分析二:Data Analysis Agent 的 SQL Result 应该如何压缩,才能既省 Token 又不丢分析链路?
数据分析类任务里,最常见的问题不是“没有结果”,而是结果太大,直接把上万行 SQL 输出塞进 Context 根本不现实。所以真正关键的,不是保留所有原始行,而是把它压成仍然利于分析继续推进的结...
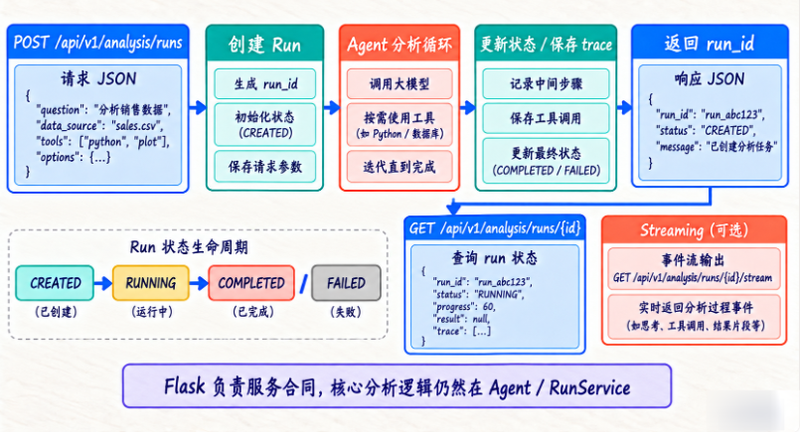
小节六:用 Flask 封装 Data Agent——让“为什么下降”变成真正可以调用的分析服务
前面的分析链路能在脚本中运行以后,还要解决请求如何提交、Run 如何记录,以及客户端怎样查询任务状态。把这些职责拆开,Flask 接口就不用承担全部分析逻辑。 图示将创建 Run、分析循环、状态...
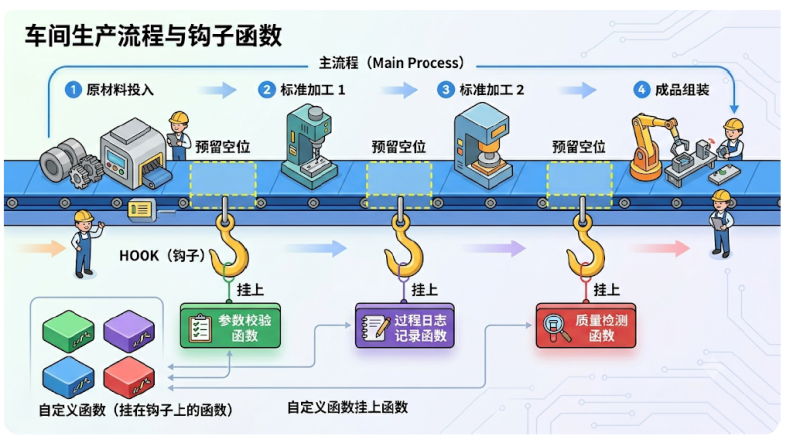
5、自定义中间件
某些复杂场景下,官方内置的中间件不能完全满足需求,此时可以通过实现LangChain暴露的中间件hook函数构建自定义中间件。说明:尽可能使用内置中间件。 5.1 什么是hook函数(钩子函数) Hook 函数...
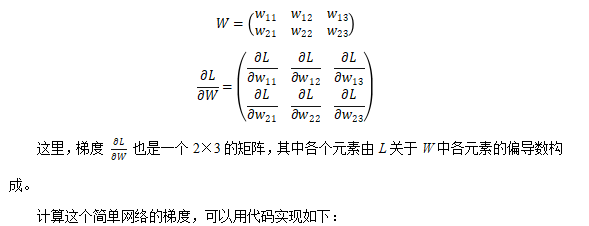
3.3 神经网络的梯度计算
在神经网络的学习中,梯度的计算非常重要。神经网络中的梯度,指的就是损失函数关于权重参数的梯度。 我们以一个单层的简单网络为例,形状为2×3,权重参数为W,损失函数记为L。那么它的权重参...
3.2.2 Series的运算
s1 = pd.Series([1, 2, 3, 4]) s2 = pd.Series([10, 20, 30, 40]) # 基本运算 print(s1 + s2) # 对应位置相加 print(s1 * 2) # 标量乘法 3.2.3 常用方法与统计 用途分类方法说明示例代...

